10月20日下午,DeepSeek把自家线上跑的推理框架DeepInfer全面开源了,协议是最宽松的Apache 2.0,可以商用;同一时间还放出了配套的Token编解码组件deepseek-recipe(MIT协议),整套东西兼容英伟达与华为昇腾两个平台。36氪
先对齐一个背景:这不是"又开源了一个模型"。10月17日DeepSeek发布V4.1-Flash-1017版,10月19日就登顶CodeArena开源模型榜,把之前的榜首Kimi K3超了过去。 模型、TileLang编译工具、一批算子库,此前都开过了;这次开的是从模型权重到用户回答之间"怎么算得快、用得省"的那一层——官方标题起得很直白:走向真正普惠的未来。36氪哔哩哔哩
热闹是真的。但作为想在双11前折腾自建、或者等着API降价的人,你先把三处小字读完。
第一道门槛:硬件白名单里,没有你的卡
微博上有开发者扒完README后说得很直接:DeepInfer目前只支持V4.1-Flash这一个模型,硬件只认英伟达SM100(Blackwell这一代的数据中心卡)和华为昇腾950NPU。微博36氪
这句话对两类人是两种意思:
对家里插着4090、刚把1017塞进单机的小红书"邪修"们——DeepInfer和你无关,官方测性能用的就是4到64块数据中心卡,个人电脑跑不动。 它不是llama.cpp,不是GGUF,不会因为你显卡够狠就跑得起来。社区现在的本地路线还是量化和分机:有人晒一张4090跑552B量化版能到26.8 tok/s,有人用1-bit量化把1017塞进家用机,还有人拿两台DGX Spark组双机。 这些路子跟DeepInfer是两个世界,别看到"推理框架开源"就以为自己的机器白买了。微博小红书
对盯硬件清单的人——SM100和昇腾950都是数据中心卡,不在你的双11购物清单上。消费级卡吃不到这波直接红利,间接红利要看API和云厂商的报价什么时候被这套参考实现打下来。
第二道门槛:开源的是"离线推理",最值钱的两块没放完
DeepSeek自己在部署问答里写得清楚:开源版本目前提供的是离线推理;撑起那155万亿Token/日吞吐的关键环节——KV缓存管理和负载均衡——因为与内部基础设施耦合太深,代码暂时没有完整开源,只给了设计细节。36氪知乎
知乎已经有工程师拆出了"离完整推理服务还差什么"的清单:你要自己补缓存调度、自己补扩缩容、自己补那套P:D(Prefill/Decode分离)流量的配比逻辑。对想抄作业搭私有化部署的企业来说,DeepInfer更像一份顶级参考答案,不是开箱即用的发行版。参考答案很值钱,但离交卷还差你自己写完的那几道题。
第三道门槛:官方的"最小启动规模"是128张卡
这篇长文里最容易被粉丝情绪略过的数字:官方建议的最小部署单元,是64卡跑Prefill、64卡跑Decode,两类机器实际配比大约1:1。 Prefill用常见的8卡机器、Decode用64到128卡的超节点,跨机房部署每8张卡要配约400Gbps的互联带宽。36氪36氪
翻译一下:这是给"集群"准备的开源,不是给"机器"准备的开源。个人玩家和中小团队想原样复刻,先过采购这一关。
“$38/卡/小时"这笔账,别读成"每张卡每小时净赚38美元”
随开源一起公布的两组线上数据刷屏了:单集群每天吞吐155万亿Token,按谷电价计算每卡每小时收入38美元。知乎
知乎有篇《DeepInfer的开源边界在哪里》提醒得对:这是"收入"口径,还不是"利润"。要算净利,你得把卡的钱、电费、机房网络、100PiB的3FS存储集群、闲置和峰谷负载全摊进去,现有公开材料没给出完整成本账,外部读者没法据此复算毛利。知乎
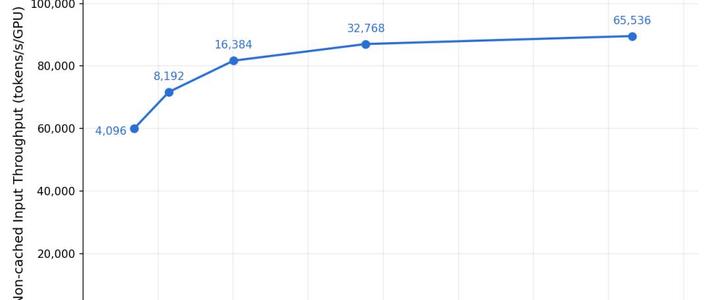
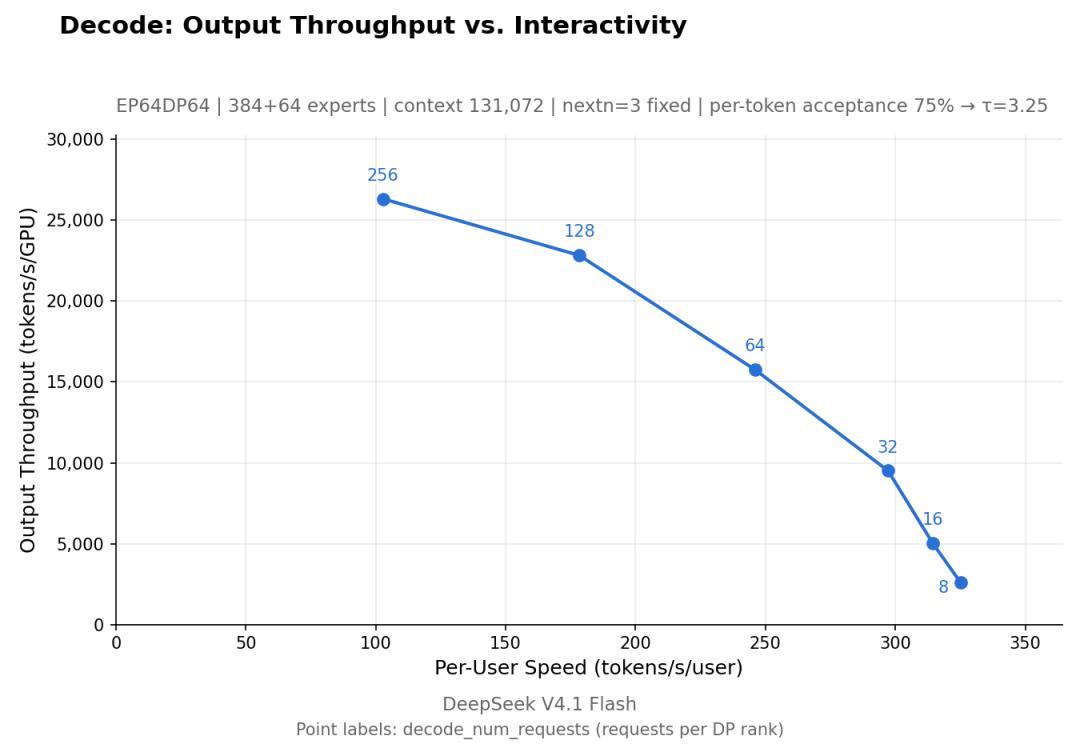
DeepSeek披露的另一组数字其实更能说明钱花在哪:平均每个请求输入77K Token,首字延迟约400毫秒,每请求每秒生成230个Token(写代码能到300),平均96%的输入直接命中缓存不用重算;同一张卡跑Prefill,不命中缓存每秒处理6万个Token,命中后能到150万个,差整整25倍。36氪
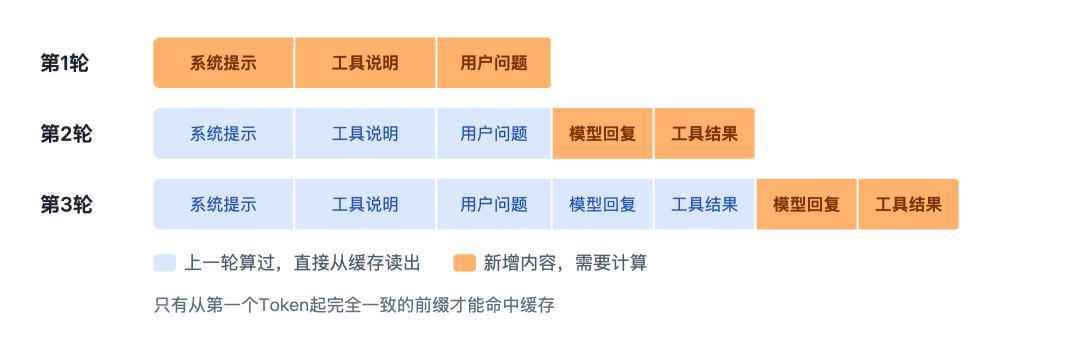
也就是说,那38美元里有一大块是"缓存复用"省出来的:BlockKVCache存在独立的3FS分布式文件系统里,相关存储容量约100PiB,聊天流量缓存留7天、Agent流量留3天。 但命中的前提是前缀从第一个Token起完全一致,中间重复的内容复用不了——Agent每调用一次工具都要把整段对话重新发给模型,DeepSeek的做法是把算过的KV缓存存下来,下一轮只算新增的那一截。36氪36氪
Decode侧的工程账同样具体:滑动窗口注意力层把"补算"限制在最近128个Token,20层里每层从重算2560个变成只算128个,Prefill总算量因此少了近一半;DSpark投机解码用变长验证,按候选Token的接受概率决定验证范围,比固定验5个Token吞吐高6%;CPU排下一步请求和GPU算当前请求同时进行,设备等待时间被压到最少。 这些是工程细节,也是DeepSeek真正的护城河——它第一次把护城河的图纸免费发出来了。36氪
顺带一提,社区里"国产算力底座"的讨论也被这波点燃:DeepInfer同时支持昇腾950,而V4的官方技术报告已经把华为昇腾和英伟达并列写进硬件验证清单,昇腾超节点全系列产品完成了对V4的适配。 对做全国产化方案的人来说,一份生产级参考实现的意义,比多一个开源模型大。知乎
四种人,四个结论
API用户(重度调用者):1017发布时API价格没动,MiniMax昨天(10月20日)发的M3.1 Flash输入每百万Token 1元、输出4元、缓存读取只要0.1元,价格直接砍到行业"斩杀线"。 DeepInfer开源本身不直接降价,但它把"推理成本该是多少"的锚公开了。继续观察三个信号:DeepSeek是否跟进降价、云厂商按小时租卡报价是否松动、开源版线上组件是否补全。36氪
家庭本地玩家:你的路线仍然是量化+llama.cpp/vLLM,DeepInfer短期与你无关。但社区晒的4090单机26.8 tok/s、两台Spark双机这些实测可以先收藏,那是你现在真能抄的作业。
企业私有化部署/中度自建党:这是最该认真读的人。Apache 2.0可商用意味着你可以直接拿去改;但要清楚拿到的是离线推理参考栈,缓存管理和负载均衡要自己补,最小单元128卡的账先算完再立项。
双11想攒机的人:别让"开源普惠"四个字替你下单。SM100是数据中心卡,消费级卡这波没有直接红利;想追本地跑1017,先看量化版在你的显存里能吐多快,再决定掏钱。
值得继续收藏这条线的理由
DeepSeek已经表态:未来新模型的推理代码和性能优化,都会持续在DeepInfer里开源。 从今天模型开源一路卷到"电饭锅"开源,推理成本的底牌正在一张张翻开——下一步是它补不补线上那块拼图、友商跟不跟价。双11前如果你要定机器、定会员、定主力API,这张账单值得放在手边。知乎