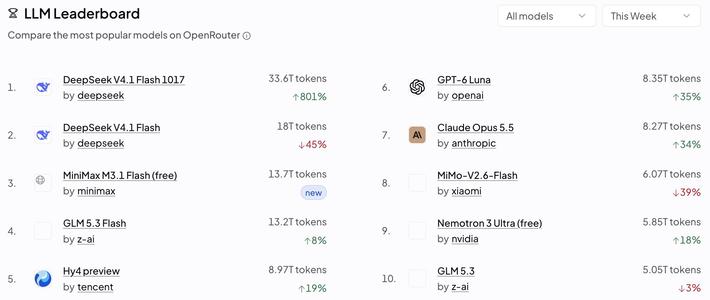
10月17日晚,DeepSeek把线上模型换成V4.1-Flash-1017,网页端、App和API同夜切换,API模型名不用改,价格一分没涨,相当于全员免费升级。开发者的迁移速度比这次切换本身还快:OpenRouter在10月19日至25日的全球周调用榜上,1017版单周处理33.6万亿Token、环比增长801%登顶,9月10日发布的老版V4.1-Flash则掉到18万亿、环比下滑45%。一涨一跌说明流量正在整体搬家。但恰恰是“什么都没变”让这轮切换的成本最隐蔽:模型行为变了、账单多了一个新计费项、同名模型在第三方渠道价差很大、十月内两次宕机,而且下一次静默切换已经在官方代码库里预埋。知乎36氪
不改代码就“换模型”:行为漂移是第一个坑
1017版与9月初版共用同一副骨架:552B总参数、输入激活8B、输出激活16B的非对称MoE,原生多模态,主打代码、自动化Agent与视觉任务。有开发者把两版开源权重拉下来比对:config.json的SHA-256完全一致,96085个张量键名和总字节数逐条对得上,只有里面的数值重写了一遍,架构、参数量、推理代码一个字节没动。等于后训练和强化学习重跑了一轮,技术报告却没有更新,仓库里的链接仍指向9月那份。36氪知乎
骨架没变,脾气变了。官方口径是基准全面涨分、任务运行时间和输出长度双双缩短,但B站技术UP主实测发现,这版的Agent行为明显变“抠门”:做事情有代价就倾向于不做,和上一个flash版本的表现完全不一样。也有开发者报告,模型会在本该调用结构化工具的时候,把一堆畸形的DSML标记当成普通文本喷出来,导致整个Agent流水线直接瘫痪。提示词是围绕老版本调的、输出模板是按它的习惯搭的团队,切换前拿自己的经典用例跑一轮回归,比看任何跑分都直接。另外官方点名对DeepSeek Harness和腾讯CodeBuddy、WorkBuddy做了适配优化,用Harness的要把客户端升到0.2.1-rc.1以上才有完整支持。哔哩哔哩知乎知乎
单价没涨,但账单上有两个新变量
DeepSeek走峰谷定价,高峰是工作日白天、闲时半价。缓存命中价更是压得极低,9月初版一度把闲时缓存命中打到每百万Token 0.02元。这决定了负载形状直接改写账单:官方披露线上平均输入缓存命中率96%,靠的就是长系统提示、长文档、代码库反复复用的Agent负载;零散短请求命中不了缓存,实际按高峰全价输入付钱。有开发者社区吐槽过它价格和路由规则“朝令夕改”,成本测算别拿旧价表,要以官方实时价表加自家命中率为准。知乎知乎
更隐蔽的是搜索计费。1017版内置了Search/Fetch通用搜索能力,官方自研搜索引擎API同步开放,发布约两周后按搜索次数收费,定价5元/千次,时间点正落在眼下。单次用户提问里,模型可能自行换几轮关键词反复检索,账单会明显高于“用户点了几次发送”的直觉——接搜索型任务前,要么把这项预算进成本模型,要么显式关掉内置搜索。知乎
同一个模型名,背后不是一回事
聚合渠道上的“DeepSeek V4.1-Flash”并不都是官方服务:OpenCode的同名模型同时挂着官方和非官方两家提供商。有实测者说各渠道的差距“根本不是简单的量化能解释清楚的”,而很多人正拿免费或低价档位的OpenCode来测评1017本身。也有用户反馈go套餐肉眼可见变慢、超过约200k上下文后降速明显,而官网速度正常;看到“1017变差了”的第三方测评,先确认测的是哪条渠道、什么档位,再决定跟不跟着迁。知乎知乎
转售平台的价格同样要折算。有开发者注意到,WorkBuddy里DeepSeek 4.1-Flash的计费达到了GLM-5.3-Flash的两倍,10月15日DeepSeek上午宕机时这个入口也跟着一起崩——它买的就是官方API转售。订阅套餐的“大额额度”另有水分:有人用自建网关把两家10美元/月的套餐对官方价表逐日核算,OpenDesign宣传的120美元月额度实际约对应80美元的官方API等值用量,只有宣传值的66.5%——个人粗算,口径有限,当交叉核对的习惯看即可。知乎知乎
自部署这条路的账更难算。权重以MIT协议开源,全局KV缓存压到每Token约890字节、100万Token驻留约890MB、一张24GB显存的消费级卡就装得下,本地“跑得起来”不是问题;但DeepSeek自己的成本经济建立在完整集群工程之上——公开披露的单集群日均155万亿Token、谷时每卡每小时38美元收入,都来自深度优化的推理栈,而其中KVCache管理与负载均衡组件因耦合内部基础设施尚未完整开源。社区援引SemiAnalysis的测算:用vLLM部署同一模型、按官方96%的输入缓存命中率折算收入,H200单卡每小时只能卖出0.79到1.58美元,连卡租都不够。OpenCode联合创始人Dax Raad也在试水自部署后得出“复现不了这个成本”的结论;vLLM和SGLang吸收DeepInfer开源内核后,部分配置的性能已接近甚至反超官方框架——但“速度追平”不等于“账单追平”。知乎知乎
决定迁移前,先把榜单口径分清
801%是OpenRouter上单一模型单周处理的Token量增幅;同一完整周,按厂商维度统计的DeepSeek文本请求数只增长了16%。一个数新版吃进多少Token,一个数DeepSeek旗下模型收到多少次请求,两个都真实,但都不能单独读成“用户暴涨801%”,10月27日经济日报援引的33.6万亿Token周数据也来自同一张榜单。而且OpenRouter只覆盖聚合API渠道,不含官网、App和私有化部署。知乎36氪
第三方评测的更新同样滞后:有开发者翻查ArtificialAnalysis,V4.1-Flash名下仍只有9月发布的那一行条目,1017版尚未单独入榜。发布当天官方跑分表显示,1017版在DeepSWE测试中以77%的通过率拿下第一、单个任务平均费用不到2块钱,约为通过率相近的旗舰模型费用的二十分之一。独立实测者验证过“两个完整项目花不到两块钱”的量级,能力结论仍建议等第三方基准收录后再引用。知乎知乎
最贵的隐性成本:两次宕机,和已经预埋的下一次切换
10月15日DeepSeek停摆5小时,官方事后按用户最近七日的API消耗发放补偿赠金。10月27日傍晚到28日凌晨再度中断,网页、App、API和聊天机器人同时停服,累计约13个小时,是2025年以来最长的一次断线,官方未公布根因。大模型服务的恢复以小时计——权重装载、缓存重建、灰度放量都省不掉——把流水线押在单一模型上的团队,故障时整条链路一起停。工程上的对策不新:接一家备选、关键链路平时两边各跑一部分流量、提前评测主备模型的输出差异(备用模型接不住你的提示词,等故障那晚再发现就晚了)、降级策略按任务分级。知乎知乎
下一轮切换已经在路上:开发者在官方deepseek-harness代码库的测试文件里发现了三个全新的V5模型标识符,代码实际上传于9月24日、10月28日才被外界广泛注意到。三个V5标识符合计出现39处;其中deepseek-v5-open没有客户端版本门槛,V5一旦发布,官方可能只需修改服务端配置,就能让所有用户无感切上,-next路径则备着高版本门槛,指向需要强制更新的重大功能。业界预测V5最早11月亮相,官方尚未就V5发布任何公告、模型卡或API标识符。在那之前给配置里的模型ID做好版本固定、把经典用例的回归测试自动化,下次切换才不会又是一次事后才发现的被动搬家。知乎知乎
这轮切换潮的能力红利是真的:不加价、不改名、单周33.6万亿Token的调用量就是开发者用脚投票的结果。但它提醒了一件事——当升级不需要你做任何操作时,成本核查反而要变成主动动作:回归测试跑一遍、搜索计费入预算、渠道提供商查清楚、备份链路留好、版本固定写进配置。做完这五件,再切。