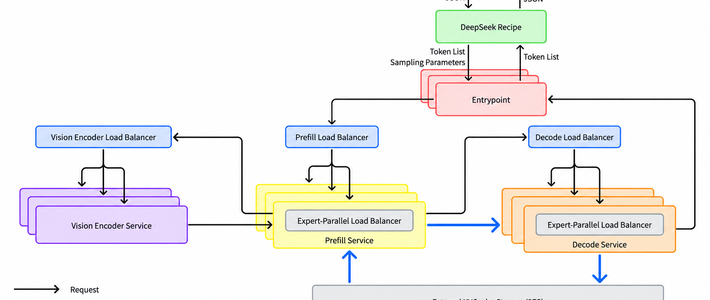
10月20日,DeepSeek宣布,在此前开源一系列大模型、TileLang编译工具及推理算子库的基础上,决定进一步将内部推理框架DeepInfer全面开源。同步发布的技术报告也摊开了线上服务的账本:目前单一集群的服务吞吐是 155 万亿 Tokens/天,整体收入是每卡每小时 38 美金(按谷价)。这次开源交出的,是此前只存在于各家机房里的推理引擎与调度经验;而把引擎变成完整线上服务所需的KV缓存系统、Prefill/Decode分离部署和跨副本负载均衡,开发者仍需自己补齐。微博知乎第一财经
开源了什么:调度层第一次有了公开的参考实现
DeepInfer 集成了高性能算子和深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay、结构化输出等能力,可在英伟达与华为昇腾平台上运行。这套框架在GitHub仓库以Apache License 2.0协议发布,商用、修改和再分发在法律上没有障碍。官方还公开了整机的硬件组织形态:DeepSeek使用常见的8卡机器承担Prefill任务,并采用64至128卡超节点承担Decode任务。知乎GitHub36氪
没开源什么:接线上流量的三块拼图还在官方手里
推理系统中的 KVCache 管理与负载均衡组件因与内部基础设施耦合较深,相关代码目前尚未完整开源。仓库README的边界写得同样直白:这一版本提供的是离线推理以及大规模服务所需的核心能力。这次开源是开放核心引擎与工程经验,企业落地仍需要系统集成和运维投入。知乎GitHub第一财经
两个数字怎么读:吞吐是量级,38美元是收入
155万亿Tokens/天换算下来约等于每秒17.9亿token,是理解集群规模的数量级参照;而38美金这一项要读准口径——官方表述是整体收入,且限定按谷价计算,它不是利润,也不能直接推出任何"回本周期"。
性能数据的适用条件同样需要看清:官方图表的测试配置是在同一scale-up域内,prefill用4张、decode用64张SM100 GPU完成。GitHub
双平台信号也有细微差别:支持的硬件只列NVIDIA SM100与华为昇腾950两类,但批不变推理与确定性采样这两个特性明确标注仅在NVIDIA平台开启。昇腾这条线目前读到的是"支持",还不是经过实测数字验证的等价,仓库中尚未公布任何昇腾950的实机吞吐。GitHub
对谁意味着什么
最先受益的是自部署阵营:deepseek-recipe处理逻辑与 DeepSeek 官方 API 完整对齐,以确保第三方部署能获得与官方部署一致的 API 体验。过去开源权重常被第三方量化"降配"转售,同一模型不同渠道体验参差,现在"满血自部署"第一次有了官方对齐件。其次被波及的是整个推理框架生态:官方在仓库中承认,DeepInfer最初主要基于vLLM构建,并借鉴了SGLang与TensorRT-LLM。推测解码的置信度调度、缓存未命中的有界重放这些原本锁在各家实验室里的做法有了可编译的样板,它们进入上游社区的速度,决定了这次开源对同行的实际杀伤力。而对普通用户,参照系被公开意味着"低价"与"满血"不再是一句宣传话术,中转站和云厂商的报价从此要在同一把尺子上竞争。知乎GitHub
背景与接下来该盯什么
这次开源与美国对华AI动作在同一天形成对照:针对有报道说美国政府要求其机构停止使用来自中国企业的DeepSeek等人工智能工具,外交部发言人毛宁20日在例行记者会上答问时表示,中方一贯反对泛化国家安全概念、将科技经贸问题政治化,我们将坚决维护中国企业的合法权益。两者之间的因果没有证据支持,但DeepSeek选择把竞争最白热化的环节摊开,本身就是姿态。接下来有两个可观察的信号:仓库已透露Prefill/Decode分离的引擎侧功能大部分已经就绪,缺的只是编排层——“most required engine functionality is already implemented”。KV缓存与跨副本负载均衡何时跟进开源、vLLM与SGLang的更新日志何时出现同源的调度设计,这两个时间点会决定"印钞机开源"到底走到了哪一步。第一财经GitHub