32K上下文越聊越忘?不是AI变笨,而是注意力被稀释了
03-25 08:32
精选参考来源

网络用户 2026-02-28
来自微信公众号
网络用户 2026-03-16
来自新浪微博来源
精选参考来源
1. 属于Agent的文件协议来了!Selfware让Agent之间无缝传递上下文

微信公众号 2026-02-28 00:00:00
2. 在线聊天记录和上下文管理总是难题,消息太多模型上下文窗口很快就撑满了。一个超棒的开源插件 Lossless Claw(基于 LCM:Lossless Context Management),为 OpenClaw 提供了一套无损上下文管理方案。它用有向无环图(DAG)替代传统滑动窗口,完美保存所有消息,通过智能摘要浓缩旧消息,又能即时复原细节,感觉像和一个“永不忘记”的智能助手聊天。主要功能:- 所有对话消息持久存储到 SQLite 数据库,确保数据不丢失;- 采用 LLM 自动生成多层摘要形成聚合 DAG 结构,压缩旧内容但保持可展开细节;- 每次对话上下文由最新消息+层级摘要组成,极大扩展了上下文容量;- 配套 lcm_grep、lcm_describe、lcm_expand 等搜索和回溯工具,快速定位旧消息和内容;- 支持自动分层压缩、会话持久化,减少手动操作;- 多种可自定义参数调节压缩触发阈值、摘要深度、最新消息保护数量等。安装只需在 OpenClaw中执行插件安装命令,一键启用,适合想突破上下文限制的AI项目和研究者。GitHub:github.com/martian-engineering/lossless-claw#AI技术# #开源插件# #上下文管理##AI创造营##人工智能#

新浪微博 2026-03-16 00:00:00
3. EMNLP 2025 | CARE:无需外部工具,让大模型原生检索增强推理实现上下文高保真
微信公众号 2025-10-06 00:00:00
4. 智能体上下文工程:为什么文件系统成了AI记忆的最佳载体?

知乎 2026-03-09 00:00:00
5. Clawdbot 如何搭建永久记忆管理系统:全靠 MD 文档
微信公众号 2026-02-02 00:00:00
6. 免费电子书《The Context Engineering Guide》Context Engineering(上下文工程)远非简单往提示词里堆数据,而是设计智能系统,在恰当时间、用合适格式,动态提供精准信息。关键不在于单纯扩大模型上下文窗口,而是如何高效利用有限的“活跃上下文”。真正的挑战是“编排”——让系统内部各模块(提示设计、检索增强、代理协作、记忆管理等)无缝协作,抵御人类和模型本身的错误。只有这样,AI系统才能突破模型固有限制,变得稳健且实用。这就是为什么Context Engineering将成为AI应用开发的核心复杂性。你需要让系统智能决定:- 什么信息放入活跃上下文- 何时总结压缩节省空间- 什么内容外部存储并按需调取- 如何精准路由查询到合适工具- 代理之间如何协同完成专业任务Victoria团队发布了完整电子书,详解如何构建这样的高效系统:从代理(Agents)、记忆系统(Memory Systems)、查询增强(Query Augmentation)、检索策略(Retrieval)到工具调用与提示循环(Tools & Prompting)。书中包含实战案例和架构图,直击从模型到生产级应用的瓶颈。业内反馈一致认为,单纯扩大上下文窗口是“懒办法”,真正难点在于设计类似人类记忆的动态、分层记忆系统。Context Engineering是连接理论与落地的桥梁,是AI技术走向成熟的必由之路。这不仅是技术细节,更是AI系统设计的艺术和哲学。掌握它,才能构建出既聪明又稳健的智能应用。电子书下载(含架构详解与实操指南):weaviate.io/ebooks/the-context-engineering-guide——思考:信息的力量不在于量多,而在于何时何地以何种方式被激活。未来AI的竞争,不是单纯模型大小,而是对“上下文生命线”的精妙编排。设计智能系统,就是设计未来人与机器共舞的节奏。
新浪微博 2025-11-13 00:00:00
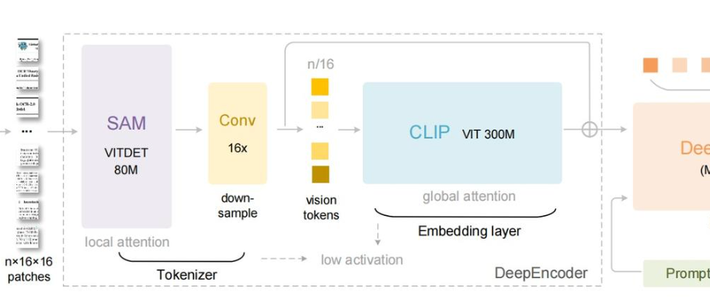
7. DeepSeek-OCR开源:10倍压缩+97%精度,A100日处理20万页数据,更是大模型的 “记忆革命”
微信公众号 2025-10-21 00:00:00
8. 爆肝10亿token,我给OpenClaw做了个龙虾管家!【一键安装龙虾】

哔哩哔哩 2026-03-10 00:00:00
9. TRAE中国版白送SOLO,一人指挥一支AI大军 重磅消息!SOLO终于上线TRAE中国版了,Waitlist免费开放中 本期视频实测TRAE的新版本,亮点很多 1、先规划再动手的 Plan 模式 2、带专家团一起干活的 Subagent 子智能体 3、DiffView 差异视图 4、多任务并行 5、上下文智能压缩长时运行不掉链子 SOLO终于把AI从“瞎干活的外包”变成了“懂协作的队友” #AI #人工智能 #TRAE #AI编程 #vibecoding

抖音 2025-11-26 00:00:00
10. 对话丘脑智能:当AI memory理解了“时间”,下一个抖音就要出现了
微信公众号 2026-02-03 00:00:00
11. #小米新模型媲美DeepSeekV3.2##小米发布新模型#小米新发布的开源自研大模型是 MiMo-V2-Flash,有点儿强呀!MiMo-V2-Flash总参数3090亿,活跃参数150亿,采用专家混合架构(MoE),性能可与DeepSeek-V3.2和Kimi-K2等头部开源模型媲美。推理速度达到150 tokens/秒,每百万token输入成本0.1美元、输出0.3美元,性价比极高。采用5比1的激进比例,5层滑动窗口注意力搭配1层全局注意力交替使用,减少KV缓存存储量近6倍,支持256k上下文窗口。能并行预测多个token,推理速度提升2到2.6倍,训练阶段也能加速采样,减少GPU空转。通过后训练阶段的多教师在线策略蒸馏(MOPD),效率提升惊人,只需传统方法1/50的算力,学生模型即可达到教师性能峰值。在AIME 2025数学竞赛和GPQA-Diamond科学知识测试中排名开源模型前两名,编程能力出色,SWE-bench Verified得分73.4%。在τ²-Bench分类得分中表现优异,支持深度思考和联网搜索功能。与主流开发环境无缝配合,256k超长上下文窗口支持数百轮智能体交互与工具调用。#小米#
新浪微博 2025-12-17 00:00:00
12. DeepSeek模型更新 黄心怡 财联社 多名用户反馈,DeepSeek在网页端和APP端进行了版本更新,支持最高1M(百万)Token的上下文长度。而去年8月发布的DeepSeekV3.1上下文长度拓展至128K。《科创板日报》记者实测中发现,DeepSeek在问答中称自身支持上下文1M,可以一次性处理超长文本。记者在提交了超过24万个token的《简爱》小说文档,DeepSeek可以支持识别文档内容。
新浪微博 2026-02-11 00:00:00
13. Claude更新记忆功能,一分钟迁移所有上下文
微信公众号 2026-03-05 00:00:00
14. 南卡 OE Mix2 智能AI 开放式耳机:支持语音对话、实时翻译、图像生成等多项智能功能,让耳机不仅是听歌,更是贴身智能助理
知乎 2025-11-11 00:00:00
15. 刚刚,腾讯姚顺雨署名首篇论文发布,「下半场」先搞上下文学习
微信公众号 2026-02-03 00:00:00
16. 当全网疯抢 “龙虾” 智能体,有人却直言 “别捧上天”。 当AI能一人顶一队,当智能体协作成趋势,一人公司是否会颠覆传统团队? 3月24日下午18点红衣客厅,对话企业AI战略顾问沈攀,带你看透 AI 智能体的真实价值。#红衣客厅 #大有学问 #openclaw #人工智能
抖音 2026-03-24 00:00:00
17. Claude Code省钱~节省tokens的核心操作:1. /compact:强制压缩当前上下文,把长对话浓缩成摘要。复杂任务到一半时用一次,效果明显;2/ 任务完成后新开 session:别在一个 session 里一直追加,积累到后期每次请求都是重量级;3. CLAUDE.md 里加节省指令:写上"能简短就别长篇,不需要解释每一步",全局减少输出 token;4. 拆分任务:一个大任务拆成几个小任务,每段完成后 compact 一次,别让上下文无限膨胀。 #HOW I AI# #程序员#
新浪微博 2026-03-05 00:00:00
18. DeepSeek 团队发布视觉压缩 OCR 模型,哪些信息和技术亮点值得关注?知乎答主们做了一波测评,总结:这个工作不是在单纯提高 OCR 的准确率,而是在尝试解决一个更大的问题——大模型的上下文瓶颈。它不是单纯在「识字」,而是在试图用视觉的方式去压缩长文本上下文,因为它碰到的其实是所有大模型都头疼的问题:上下文太长,token 不够用。简言之,大模型可以一目十行了!
新浪微博 2025-10-21 00:00:00
19. 对话八位具身智能大咖:模型之争、数据来源与第一性原理|甲子光年
微信公众号 2025-11-21 00:00:00
20. 攻克记忆瓶颈:腾讯云Data Platform如何为智能体打造记忆湖架构
知乎 2026-01-13 00:00:00
21. MiniMax M2.7+OpenClaw实战!AI到底能接管多少工作?
哔哩哔哩 2026-03-23 00:00:00
22. 盘点一周AI大事(3月15日)|首次上传大脑成功 工程师开源龙虾办公室Claw3D 龙虾彻底出圈,,百虾大战正式开打 工程师开源一键装龙虾AlphaClaw 斯坦福开源科学家龙虾LabClaw 工程师Karpathy 开源龙虾版GitHub AgentHub Chrome上线龙虾Web协议 WebMCP 工程师开源龙虾软件协议CLI-Anything 吴恩达开源龙虾上下文工具Context Hub 研究员开源最强动漫图像模型Anima-v2 研究员开源最强视频分割模型MatAnyone 2 科学家成功上传了一只果蝇的大脑 #AI新星计划 #AI #AIGC #龙虾 #openclaw
抖音 2026-03-15 00:00:00
23. 第三天《Context Engineering: Sessions & Memory》,一个Agent做得好,80%看上下文管理!这个pdf有72页,系统讲述了如何让LLM在交互中形成“状态”“个性”与“持续学习“,想做好AI Agent的别忘记深读一下这个文档。划线点:1. 上下文工程的核心理念 传统的 Prompt Engineering 只关注如何写出一个最优提示,而 Context Engineering 则是更高维度的概念。它要求开发者在每次模型调用前,动态地拼装完整的上下文——包括系统指令、工具定义、few-shot 示例、外部检索内容、长期记忆以及当前对话历史。 白皮书中有个比喻:如果 Prompt 是食谱,那么 Context Engineering 就是备料,决定了模型能否稳定地产出理想结果。2. Session vs. Memory Session 是一场对话的“工作台”,保存着事件日志和临时状态;Memory 是长期的“档案柜”,从这些对话中提炼出可复用的知识。 Session 负责连贯性,Memory 负责持续性。3. 多智能体系统中的会话共享 多个 Agent 协作时,Session 的设计变得更复杂。不同框架(如 ADK、LangGraph)内部的数据结构差异较大,直接共享会导致互操作问题。 文档提出用框架无关的 Memory 层作为共享语义中枢,各 Agent 通过抽象化的记忆数据交换信息,从而实现真正的跨框架协作。4. 长上下文的管理与压缩 模型上下文窗口有限,随着会话增长,成本、延迟和注意力衰减都会出现。有三种压缩策略: (1)保留最近 N 轮(滑动窗口); (2)基于 token 数截断; (3)递归摘要,用 LLM 生成对旧内容的总结。 这些方法共同目标是保留必要、舍弃冗余,让模型始终聚焦关键信息。5. 记忆系统的设计与生命周期 记忆并非简单存储,而是一套动态的 LLM 驱动工作流,涵盖提取、整合、存储、检索与遗忘(有点像一个ETL系统)。 提取阶段从原始对话中识别有意义的信息;整合阶段解决重复与冲突;存储可采用向量数据库、知识图谱或混合架构;检索阶段结合语义相似度、时间衰减与重要度评分挑选最合适的记忆。 文档还提出“遗忘”机制——旧记忆会随时间或置信度衰减被归档或删除,以保持知识库的健康。 划重点:真正的智能不在于保存全部信息,而在于知道何时、为何、记什么、忘什么。一个理想的 Memory 系统,像人脑的海马体,既能在短期保持上下文,又能在长期过滤、压缩、抽象出模式。 AI Agent的设计应该把动态遗忘作为标准功能来设计,而非可有可无的能力。6. 触发策略与 Memory-as-a-Tool 模式 记忆生成可在会话结束、固定回合、实时、或用户显式命令下触发。频繁触发可保留更多细节,但计算成本高;批量触发更经济,却易失真。 白皮书提出 Memory-as-a-Tool 模式:让 Agent 自行判断何时、为何生成记忆,将“记忆何时发生”的控制权交给模型逻辑本身(划重点!)。7. 信任、来源与隐私 文档专门讨论了 Memory 的来源溯源(Provenance):每条记忆应携带来源类型、时间戳、置信度与可信层级。系统需依据来源权重解决冲突,并对个人敏感信息在写入前脱敏,确保隔离与合规。8. RAG 与 Memory 的对比 RAG 让模型更懂世界, Memory 让模型更懂你。 前者检索外部事实,后者积累用户语境。Agent 需要二者结合,既具世界知识,又具个人连续性。#ai创造营# #程序员#
新浪微博 2025-11-14 00:00:00
24. Claude Code Skills 采用了一种极其巧妙的三层上下文系统。请记住这个结构,当你构建技能(Skills)时会非常有用。第一层:主上下文(Main context)——项目配置,总是会被加载。第二层:技能元数据(Skill metadata)——只包含 YAML 前言部分,每个技能大约占用 100–200 个 token。第三层:活动技能上下文(Active skill context)——SKILL.md 文件以及按需引用的文档,在需要时才会加载。像脚本(scripts)和模板(templates)这样的支持文件不会被预加载到上下文中,而是在使用时直接访问,不消耗任何 token。这种架构让系统可以同时容纳数十个技能,而不会触及上下文长度限制。#人工智能##程序员#
新浪微博 2025-10-25 00:00:00
25. 大模型的上下文工程,都说很重要,但相关的研究那么少,对Agent开发有什么影响,有大佬能解释一下吗?
知乎 2025-11-27 00:00:00
26. 马斯克Grok 4深夜大升级:200万逆天上下文、五倍GPT-5「脑容量」!
知乎 2025-11-09 00:00:00
27. 对话蚂蚁灵波首席科学家沈宇军:2万小时真机数据,用“慢功夫”做具身智能|甲子光年
微信公众号 2026-02-08 00:00:00
28. 对话云栖大会:下一个AI爆款、大模型进化与Agent万亿级企业市场
哔哩哔哩 2025-10-17 00:00:00
29. #DeepSeek下个王炸是什么# DeepSeek2026年的王炸大概率聚焦长上下文与效率优化的深度融合,继2026年初灰度测试百万token上下文模型后,DeepSeek将完善相关技术,依托mHC流形约束超连接与Engram条件记忆模块,解决长序列计算的内存开销问题,实现100万token下的高准确率推理。DeepSeekV4完整版模型的发布应该也是DeepSeek的一个重要的更新,新模型将结合混合专家架构优化,延续DeepSeek低成本高性能的优势,让中小企业也能便捷接入顶尖AI能力。推动开发者共建垂直场景应用;贴合2026年AI从会生成向会行动的进化趋势。#HOW I AI#
新浪微博 2026-02-15 00:00:00
30. Claude Opus 4.6 和 Sonnet 4.6 的 100 万 token 上下文窗口今天正式全面开放(GA),且不加价,按标准价格计费,无论请求长度是 9K 还是 900K token,单价完全一样。 Opus 4.6 的定价是输入 $5、输出 $25(每百万 token),Sonnet 4.6 是 $3/$15。此前超过 20 万 token 的请求需要加 beta 标头,现在直接生效,已有代码无需改动。 除了价格统一,这次更新还有几个实际变化:单次请求可处理的图片和 PDF 页数从 100 提升到 600;所有上下文长度享受相同的速率限制,不会因为请求变长而被限流。Claude Code 的 Max、Team 和 Enterprise 用户在使用 Opus 4.6 时将默认启用 100 万上下文,意味着对话压缩(compaction)频率大幅降低,更多对话历史得以完整保留。 在准确率方面,Opus 4.6 在 MRCR v2 基准上得分 78.3%,Sonnet 4.6 在 GraphWalks BFS 上得分 68.4%,均为同类前沿模型在百万 token 长度下的最高分。简单说就是:窗口虽大,信息检索能力没有打折。 Anthropic 引用了多家客户的反馈来说明实际效果。 Cognition(Devin 背后的公司)表示,此前大型代码差异塞不进 20 万上下文窗口,需要分批处理,容易丢失跨文件依赖;现在整个差异一次送入,代码审查质量更高,流程也更简单。Ramp 的工程师提到,Claude Code 在调试时经常消耗超过 10 万 token 检索各类数据源,一旦触发压缩就会丢失细节、陷入重复调试循环,百万上下文直接消除了这个问题。 该功能今天起通过 Claude Platform 原生支持,也可通过 Amazon Bedrock、Google Cloud Vertex AI 和 Microsoft Foundry 使用。 http://t.cn/AXVmRMYf
新浪微博 2026-03-14 00:00:00
31. AI Agent 的“进化之路”:从研究原型到生产级记忆系统,技术趋势与产品对比
知乎 2025-12-29 00:00:00
32. 嘿,你的 128K 模型可能只使用了其上下文的一小部分,而你却不知道。llama-server 会将上下文窗口分割成多个并行槽位。如果在一个 128K 的上下文中设置 -np 4,则每个槽位将获得 32K 的空间。在一个 32K 的上下文中设置 4 个槽位,则每个槽位将获得 8K 的空间。这就是为什么长时间的对话会被切断的原因。不是模型的问题,也不是量化指标的问题,而是时隙分割吞噬了你的上下文。解决方法:在启动命令中添加 -np 1。一个槽位。完整上下文分配给一个用户。如果你只是在本地运行程序,不需要多个窗口。你只需要一个窗口,并占据整个窗口即可。
新浪微博 2026-03-19 00:00:00
33. 英伟达推理上下文内存存储对NAND意味着什么?
知乎 2026-01-15 00:00:00
34. 对话普罗宇宙创始人葛巾:具身智能产品未来三年成本可能下降 50%
知乎 2026-01-26 00:00:00
35. 2026年AI全景预测:迈向百亿智能体时代的20个发展趋势。 #大咖观察 #人工智能 #红衣聊AI #智能体 #AI时代
抖音 2026-01-09 00:00:00
36. 大模型更像人的大脑,智能体是大模型的手和脚。 #大咖观察 #红衣聊AI #智能体 #大模型
抖音 2025-10-17 00:00:00
37. 创新Transformer!面壁基于稀疏-线性混合架构SALA训练9B模型,端侧跑通百万上下文
微信公众号 2026-02-11 00:00:00
38. DeepSeek-OCR一开始以为是又一个普通的OCR模型,认真看了下论文,发现其重点是压缩,可以有助于LLM或者Agent的记忆管理。DeepSeek-AI 团队提出了一种全新的Contexts Optical Compression 方法,核心思想是:利用视觉模态作为一种高效的文本压缩媒介,以图像形式表示长文本,从而大幅减少LLM处理长上下文的计算负担。DeepSeek-OCR 首次验证了将文本信息以视觉形式进行高效压缩与恢复的可行性,在 10× 压缩下仍能近乎无损地还原文本。1. 研究动机当前LLM在处理长文本时面临计算量随序列长度平方增长的问题。论文提出将长文本转化为图像,让视觉模型(VLM)对其进行编码,用较少的视觉 token 表示大量文本信息,实现“以视觉压缩文本”的思路。这种“光学压缩”既能显著减少 token 数量,又可能启发 LLM 的长期记忆与遗忘机制研究。2. 模型架构DeepSeek-OCR 由两部分组成:(1)DeepEncoder:一种新型视觉编码器,结合 SAM-base(局部注意力)与 CLIP-large(全局注意力),中间加入 16× 卷积压缩模块,可在高分辨率下保持低激活内存并显著减少视觉 token。(2)DeepSeek-3B-MoE 解码器:基于 Mixture-of-Experts 架构,推理时仅激活 570M 参数,用于从视觉 latent token 重建原始文本。3. 多分辨率与模式支持DeepEncoder 支持多种输入模式(Tiny、Small、Base、Large、Gundam),对应不同分辨率与视觉 token 数,方便在研究不同压缩率或实际应用时灵活选择。例如 Gundam 模式可解析超高分辨率文档(如报纸),最高支持动态拼图式输入。4. 视觉遗忘机制作者提出“视觉化遗忘机制”假设:可以通过逐步缩小图像分辨率模拟人类记忆衰减过程,实现“信息随时间模糊化”的长期上下文管理。光学上下文压缩或可成为未来 LLM 无限上下文架构的关键方向。项目:github.com/deepseek-ai/DeepSeek-OCR#人工智能##程序员#
新浪微博 2025-10-21 00:00:00
39. 互联网技术 DeepSeek这次悄无声息的更新确实展现了技术上的重大突破。上下文窗口从128K直接跃升至1M,意味着模型能一次性处理《三体》三部曲级别的超长内容,这不仅是参数量的提升,更是架构稳定性和内存管理能力的质变。知识库更新至2025年5月也让模型对近一年的技术动态和行业趋势有了原生理解,显著提升了实用性。值得注意的是,新模型在保持强大推理能力的同时,交互体验更加细腻自然,被评价为可媲美Claude 3.5 Sonnet。这次更新很可能是DeepSeek-V4正式发布前的关键测试,延续了其在春节前后推出颠覆性更新的传统。虽然未包含多模态能力,但在纯文本处理上已实现对国际顶尖模型的追赶甚至超越。对于开发者而言,1M上下文窗口将彻底改变工作流程,能够直接分析完整项目代码库进行全局优化。这次更新不仅展现了DeepSeek的技术实力,也为国产大模型的商业化落地开辟了新路径。大家觉得这样的上下文长度扩展会在哪些领域产生最直接的影响呢?
新浪微博 2026-02-11 00:00:00
40. 云小二 Aivis 的架构实践——基于上下文工程与多智能体的自主服务新形态
知乎 2026-03-03 00:00:00
41. 实操教程|3种AI 智能体对话设置方法
微信公众号 2025-10-08 00:00:00
42. 突破一亿Token极限:EverMind提出MSA架构,实现大模型高效端到端长时记忆
微信公众号 2026-03-19 00:00:00
43. 2月18日,Anthropic正式宣布推出Claude Sonnet 4.6,并将其直接设为免费用户和Pro付费用户的默认模型。这一升级标志着公司进一步将高性能AI能力向更广泛用户群体开放。Claude Sonnet 4.6在编码能力、指令遵循、长上下文理解、代理规划、知识密集型任务以及设计等领域实现显著提升。模型新增beta版100万token上下文窗口,可一次性处理完整代码库、长篇法律合同或数十篇学术论文等超大文档。最受关注的在于,免费用户现可直接使用Sonnet 4.6作为默认模型,同时获得文件创建、外部连接器、技能调用、上下文压缩等此前部分受限的功能,而API定价保持不变(输入/输出每百万token分别为3美元/15美元,与前代Sonnet 4.5一致)。Anthropic官方表示,该模型在真实世界办公场景中的表现已接近甚至超过2025年11月发布的旗舰版Claude Opus 4.5,尤其在编码一致性和复杂多步任务执行上获得开发者高度评价。公司强调,Sonnet 4.6的计算机使用能力较前代有明显飞跃,能更可靠地完成需要与界面交互的自动化任务。此次更新距Claude Opus 4.6发布仅12天,反映出当前AI领域竞争的白热化与迭代速度。Claude Sonnet 4.6已即刻在claude.ai网页端、移动端、Claude Cowork生产力工具以及API和主流云平台全面上线,为数百万用户带来更强大、更普惠的AI体验。
新浪微博 2026-02-18 00:00:00
44. 对话MIT终身教授Joe Paradiso:纤维也可具备智能|甲子光年
微信公众号 2025-11-24 00:00:00
45. 如何从0到1搭建属于自己的AI智能体?
知乎 2025-10-18 00:00:00
46. 姚顺雨在腾讯首个研究:在“上下文”这事上,在座的各位都不及格
微信公众号 2026-02-05 00:00:00
47. 推特热议、AI 万亿美元新赛道,「上下文图谱」到底是什么?创业机会在哪?
微信公众号 2025-12-29 00:00:00
48. 突破具身智能长程任务瓶颈!EchoVLA双重记忆机制赋能移动操作机器人,超越π0.5
知乎 2026-01-20 00:00:00
49. AI 的本质不是算力,而是「上下文革命」
微信公众号 2025-11-06 00:00:00
50. Prompt 膨胀危机
微信公众号 2026-01-17 00:00:00
51. Claude Skills + MCP管理子智能体 = 解决主上下文零污染和零膨胀!
微信公众号 2026-01-11 00:00:00
52. 告别“上下文爆炸”
微信公众号 2026-01-02 00:00:00
53. 智能体(AI Agent)如何运用上下文工程!

小红书 2025-11-17 00:00:00
54. Manus
微信公众号 2025-10-20 00:00:00
55. 动态上下文发现
知乎 2026-02-27 00:00:00
56. Cursor推出动态上下文发现功能,赋能编程智能体
微信公众号 2026-01-08 00:00:00
57. 通俗讲解大模型短期记忆 vs 长期记忆
知乎 2026-02-04 00:00:00
58. 有效支持长期运行智能体的机制
知乎 2025-12-01 00:00:00
59. 随着任务周期变长,智能体系统的“记忆”成本与效率矛盾该如何解决?
知乎 2026-02-01 00:00:00
60. 在多轮交互中,智能体的“状态”应该包含哪些内容?如何设计可序列化的状态结构?
知乎 2026-03-01 00:00:00
61. OpenAI 智能体工程指南
微信公众号
62. AI Agent 的注意力稀缺与预算规划
微信公众号
63. 更大的上下文窗口为什么让RAG变得更重要而非更多余
知乎
64. 精读 Anthropic 上下文工程
微信公众号
65. 如何“学会忘记”?记忆衰减算法-智能体的新陈代谢系统
微信公众号
66. AI写代码越写越笨?掌握上下文卫生,3步解决Claude降智难题

什么值得买
67. AI智能体持续学习之道
微信公众号 2026-03-18 00:00:00
68. 北大等高校突破

今日头条 2026-02-12 00:00:00
69. 总编辑圈点 | 更小内存带来更强AI,压缩内存可提升大模型处理任务准确性
今日头条 2026-01-01 00:00:00
70. 聊下 AI Agent 的上下文记忆和遗忘
知乎 2025-11-15 00:00:00
71. 做好AI Memory需要解决三个技术难题
微信公众号 2026-03-14 00:00:00
72. 别再迷信“大海捞针”了!清华 LongBench v2 揭露真相
微信公众号 2025-12-06 00:00:00
73. 为什么大模型会“越聊越蠢”?
今日头条 2026-01-29 00:00:00
74. 🌋 大模型长上下文|正确率暴跌❗️。🔥大模型集体翻车!平均正确率仅17.2%!颠覆认知的CL-Bench测试结果
抖音 2026-02-05 00:00:00
75. LongBench-Pro
知乎 2025-12-14 00:00:00
76. 长上下文模型的极限:128k上下文能否真正理解全文?
微信公众号 2025-10-05 00:00:00
77. AI算法面试
微信公众号 2026-01-26 00:00:00
78. MIT论文解读
知乎 2026-03-09 00:00:00
79. 【OpenClaw 记忆机制】第1课
知乎 2026-02-05 00:00:00
80. 长上下文不是长期记忆
知乎 2026-03-17 00:00:00
81. Agent多步任务总卡壳,从上下文断裂到状态自愈以及一致性与可恢复性实战手册
微信公众号 2025-11-27 00:00:00
82. 告别拼凑
微信公众号 2026-01-30 00:00:00
83. 大模型的上下文会腐烂,这是大模型内生的缺陷。并不是给钱越多,上下文越大,就越好用。
哔哩哔哩 2026-03-12 00:00:00
84. AI记得越多,效果越差?是时候放弃“文本仓库”,转向“语义缓存”了
微信公众号 2026-02-01 00:00:00
85. 大模型的“健忘症”有药了
微信公众号 2025-12-02 00:00:00
86. LangChain剖析”上下文工程”的四大核心策略和实践技巧
今日头条 2025-10-02 00:00:00
87. LLM中Lost in the Middle核心原因&解决方案
知乎 2025-11-24 00:00:00
88. DeepSeek的OCR,而是通向AGI记忆系统的钥匙
小红书 2025-10-26 00:00:00
89. 51CTO-西瓜老师-2025年大模型 MCP 技术实战课
知乎 2025-12-03 00:00:00
90. 递归语言模型登场!MIT华人新作爆火,扩展模型上下文便宜又简单
微信公众号 2025-10-16 00:00:00
91. Token省30倍,大模型Agent高效永久记忆框架开源
微信公众号 2026-02-02 00:00:00
92. 大模型基于函数Token的记忆检索
微信公众号 2025-10-16 00:00:00
93. 图文详情

中移科协
94. AI Agent技术社区
95. 2025 年 AI 开发者的红利,在扣子
网易
96. 真·开外挂!MIT新研究:架构0改动,让大模型解锁千万级上下文
网易
97. A Survey of Context Engineering for Large Language Models
98. 微软:大模型在多轮对话中翻车的深层原因..
小红书 2026-02-27 00:00:00
99. Claude 博客笔记:长期运行智能体的有效策略
微信公众号 2025-12-10 00:00:00
100. 光学压缩革命:DeepSeek用视觉令牌突破Ai长上下文瓶颈,人类记忆机制或可模拟
微信公众号 2025-11-01 00:00:00
101. 突破上下文窗口限制!RLM让大模型轻松处理1000万+token长文本
微信公众号 2026-01-08 00:00:00
102. 聊聊大模型推理系统之 L4:为什么你的128K长上下文服务总是慢?原来卡在批次长度不均
微信公众号 2026-01-06 00:00:00
103. DeepSeek-OCR:光学压缩下的AI记忆与遗忘
微信公众号 2025-10-27 00:00:00
104. 麻省理工学院研究人员突破上下文窗口限制
哔哩哔哩 2026-01-22 00:00:00
105. 对长上下文能力有不同要求,怎么选择合适的模型?
知乎 2025-12-17 00:00:00
106. 破解AI算力黑洞:多模态模型压缩之道
什么值得买 2026-02-24 00:00:00
107. 为什么说大模型也需要“记忆”管理?如何看待DeepSeek-OCR利用视觉压缩语言来模拟人类遗忘机制?
知乎 2025-11-03 00:00:00
108. ⚠️为什么大模型会"选择性失忆"
小红书 2025-12-22 00:00:00
109. 快被deepseek“达到对话长度上限”时逼疯?一文带你解决此问题deepseek一百个功能详解之二
知乎 2025-11-04 00:00:00
110. 解决大模型上下文衰减的6种方案,附详细代码
微信公众号 2025-09-29 00:00:00
111. 【手把手】一篇文章搞懂 MCP2 CLI:彻底解决 MCP 上下文膨胀问题,人人都能学会
微信公众号 2026-03-16 00:00:00
112. 解锁DeepSeek隐藏技能:128K上下文如何改变你的创作方式
微信公众号 2026-01-24 00:00:00
113. AI Agent的单轮对话和多轮对话如何评测?
小红书 2025-12-17 00:00:00
114. 不用额外缓存!英伟达开源大模型记忆压缩方案,128K上下文提速2.7倍
微信公众号 2026-01-16 00:00:00
115. 首个长上下文Agent评估基准
小红书 2025-11-19 00:00:00
116. 【中文语音版】带大多数开发者理解上下文窗口是如何工作的
哔哩哔哩 2025-11-01 00:00:00
117. AI智能体记忆机制深度解析
知乎 2025-12-30 00:00:00
118. DeepSeek-OCR详解:光学文本压缩打造AI记忆
小红书 2025-10-22 00:00:00
119. 智能体实践经验:长期运行Agent的高效框架
小红书 2025-12-01 00:00:00
120. 蚂蚁百灵开源新模型!长文本编程提速 3 倍,128K 上下文零卡顿
微信公众号 2025-10-29 00:00:00
121. 视觉压缩革新,大模型长文本处理新范式
知乎 2025-10-25 00:00:00
122. 压缩即智能
知乎 2026-02-23 00:00:00
123. 大模型写长篇总“失忆”?一文解决AI小说的记忆难题
知乎 2026-03-02 00:00:00
124. 3分钟搞懂AI记忆升级:DeepSeek OCR压缩法
小红书 2025-10-21 00:00:00
125. DeepSeek OCR:十倍压缩,开启AI记忆革命
小红书 2025-10-21 00:00:00
126. UltraLLaDA:扩散语言模型上下文扩展到128K!
小红书 2025-10-19 00:00:00
127. OpenClaw本地跑满128k上下文!llama.cpp+NVIDIA超轻量模型实测!
今日头条 2026-03-22 00:00:00
128. 让AI Agent跨越上下文窗口:Anthropic的长时任务实践笔记
微信公众号 2025-12-10 00:00:00
129. Agent 高效60秒|Sub Agent 上下文优化
知乎 2025-10-18 00:00:00
130. 大模型会在多轮对话下会“迷路”
小红书 2025-10-18 00:00:00
131. 告别 “金鱼记忆”:智能体拥有长期记忆,每一次对话都被牢牢记住
微信公众号 2026-02-15 00:00:00








已收藏
去我的收藏夹