阿里通义千问团队此前正式开源了新一代图像生成模型 Qwen-Image-2.1。这款模型的发布引发了 AI 创作社区的广泛关注。与以往许多单纯强调“文生图”能力的模型不同,Qwen-Image-2.1 将图像生成、图片编辑与透明背景输出等多种功能整合到了同一个模型架构中,其视觉生成主干仅包含 7B 参数。这种“轻量高能”且“生成与编辑一体化”的设计,正在对 AI 图像创作的实际工作流、本地部署生态以及开源与闭源模型的竞争格局产生深远影响。
在技术架构与创作效率方面,Qwen-Image-2.1 展现出了极高的实用导向。模型采用了 32 层 Single-Stream DiT 作为视觉生成主干,配合 Qwen3-VL 8B 多模态文本编码器以及专门的 RGBA 变分自编码器(VAE)。为了在消费级设备上实现高效率的推理,模型引入了混合粒度注意力机制与上下文缓存技术。在处理多图编辑或复杂指令时,模型会在第一步将输入的参考图与提示词等静态上下文进行预计算并缓存,随后的生成步骤可以直接复用这些记忆,大幅降低了显存开销并提升了生成速度。这种优化使得原生 2K 分辨率的大图直出以及多图融合编辑在个人电脑上跑得更加丝滑。
在创作功能上,Qwen-Image-2.1 最贴近实际生产力的突破在于“原生支持透明背景图像”的生成与编辑。过去,设计师与电商运营在利用 AI 生成素材后,往往需要借助额外的抠图工具来获取透明 PNG 图片。而 Qwen-Image-2.1 能直接根据文字指令输出带 Alpha 通道的透明图像,不仅可以一步到位生成贴纸、Logo 和商品素材,还能直接对透明图层进行文字修改、表情调整或从真实照片中提取特定主体。这一特性的普及,直接打通了从创意生成到设计合成的最后一步,大大缩短了图像创作与后期排版的流程。
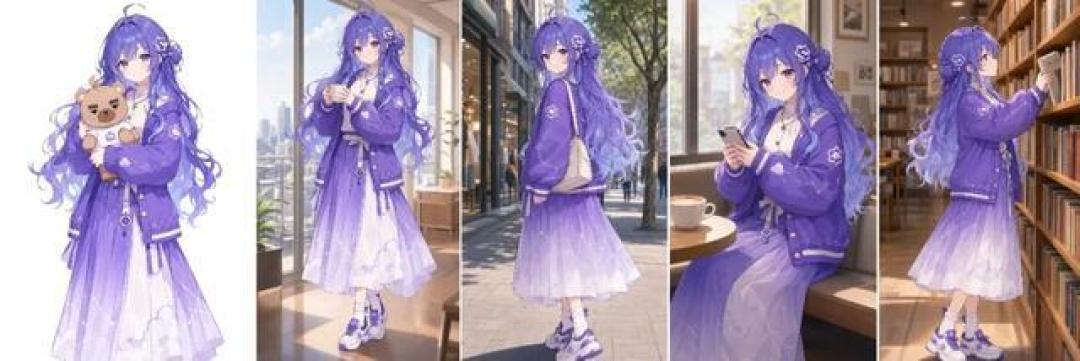
多图参考与精准编辑能力的提升,也深刻改变了创作中的“可控性”问题。模型原生支持多达 10 张参考图的同时输入,能够在保持人物身份特征、商品细节纹理的前提下,进行服装搭配、室内家居布置乃至多人合影合成等复杂任务。为了满足更细致的修改需求,模型还支持圈选、涂抹以及独立掩码等多种局部编辑方式。创作者可以在同一张图上指定多个不同区域分别提出修改意见,例如同时替换衣服、改变发色并移除饰品,而无需整张图重新生成。配合其对中文文字排版和复杂信息图表达的天然优势,AI 生成图片正在从“随机抽卡”走向“精准交付”。
从硬件门槛与工具生态来看,Qwen-Image-2.1 的开源显著降低了创作工具的使用成本。虽然包含文本编码器在内的整套系统规模达到 16B 级别,但由于视觉生成核心仅为 7B,且支持量化运行,它能够以较低的显存要求在普通消费级显卡乃至搭载 Apple 芯片的 Mac 设备上本地部署。发布首日,ComfyUI、Diffusers 等主流创作框架和社区工具就完成了快速适配。创作者无需支付云端 API 费用,就能在本地将文生图、修图、抠图融合进自动化 Agent 工作流中,极大地赋能了个人创作者和中小型设计团队。
此外,Qwen-Image-2.1 的亮相也重新塑造了开源生图模型的竞争态势。公开基准评测显示,该模型在综合表现上能够与部分闭源巨头的小型模型一较高下。虽然在部分极致写实的光影质感或极其复杂的物理动作理解上,开源模型与顶尖闭源模型之间依然存在一定差距,且新版本的开源许可证调整为了研究许可,商业使用需要单独申请授权,但它依然证明了轻量化开源架构在多功能整合上的巨大潜力。
综合来看,阿里千问开源 Qwen-Image-2.1 不仅仅是一次技术参数的更新,更是 AI 图像创作领域向“生产力工具”转变的重要信号。通过把文生图、图像编辑、透明素材提取和多图保真整合至统一的轻量模型中,它不仅降低了图像创作的技术和成本门槛,也为未来 AI 辅助设计工具的进化指明了更加实用化、一体化的方向。