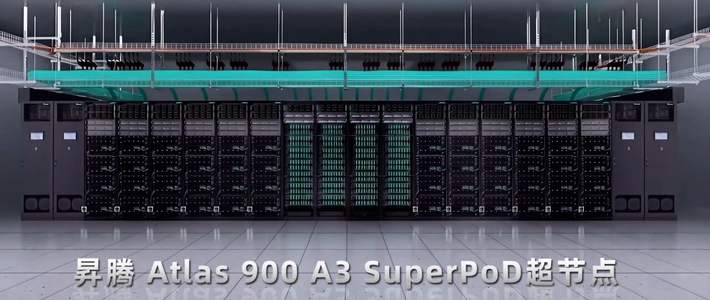
11月4日,月之暗面把 Kimi K3.1 Pro 的完整权重放上 Hugging Face。按模型卡,2.8 万亿总参数、每词元激活 1040 亿、约 104 万词元上下文。 权重放出后,昇腾宣布基于 vLLM Ascend 和 SGLang 完成 0Day 推理适配,覆盖 Atlas 800 A3、Atlas 900 A3 SuperPod 和昇腾 950 超节点。 对企业的直接意义是:模型发布首日,就能在自己的国产算力上开展部署和应用验证。0Day 不是一句口号。昇腾复用了 K3 的适配经验,提前做模型分析,补上 K3.1 Pro 新增的稀疏注意力路径和多模态推理,再把分布式缓存叠进去,同时保持框架原有的服务能力。 企业省掉的,正是模型接入、算子开发和服务验证这段排期。知乎微博知乎
但“能跑”和“能部署”之间,还隔着一本算力账。1.561TB 的权重,按单台八卡 80GB、共 640GB 显存估算,仅静态装载就要 2.5 台以上,这还没算 KV cache、激活和通信缓冲。 这不是多卡工作站,而是多机分布式推理集群,百万上下文的 KV cache 和专家并行的跨机通信还要另算。昇腾官方说的是支持“部署与应用验证”;能跑、能验,不等于已经按你的业务负载调好。知乎微博
Kimi K3.1 Pro 的 API 价格确实降了:输入从每百万 token 20 元降到 13 元,输出从 100 元降到 68 元;但单价下降没有传导成使用成本下降,部分高频场景反而更贵。 有用户反映,仅发送一句“审查项目架构”指令,模型便拉起 5 个子 Agent,十几分钟耗尽 5 小时额度;开发者实测显示,新模型完成同类任务的 Token 消耗量是上一代的 1.6 至 2.4 倍,轻松吃掉了官方下调的 33% 单价。 月之暗面随后道歉,承诺为订阅者一次性恢复 25% 月度额度,并承认后台存在“不必要的子Agent调用和输出长度”。这些冗余计算发生在订阅产品里,换成企业自建,账单就会从“额度”变成“卡时”;0Day 解决了“能不能跑”,没有解决“跑一次要花多少”。知乎微博
还有一道不写进机房的账:许可证。K3.1 Pro 用的不是 Apache 2.0,而是自定义的 Kimi K3.1-Pro License。内部使用基本自由;但如果企业对外提供模型服务,且连续 12 个月收入超过 2000 万美元,就要先和月之暗面单独签约。 对多数企业,这不是障碍,但它提醒一件事:权重开放改变的是选择权,不是部署的复杂度。知乎
所以,昇腾 0Day 适配的真实价值,不是让企业“省掉部署”,而是把“从模型发布到开始验证”的等待时间压到零。过去,新模型出来,企业往往要等框架适配、等算子补齐;现在,第一天就能拿到一个可运行的起点。当 0Day 逐渐成为国产算力的常规动作,真正拉开差距的就不再是谁先跑起来,而是谁跑得稳、算得清、管得住。适配期可以归零,部署账不会。