











3
2
有人把一颗CPU编译进大模型,跑通了一帧Doom
2026-11-06 11:13:22
0点赞
0收藏
0评论
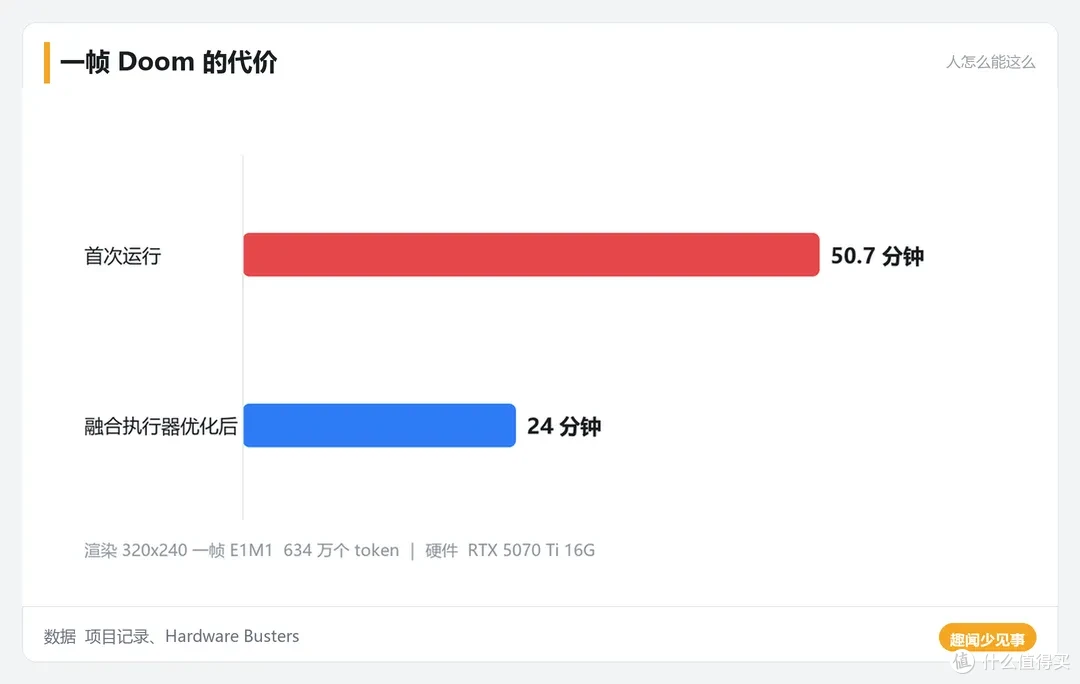
大模型算不准算术这事,哥们应该深有体会,让它算个六位数乘法,它能一本正经地错给你看。十月底有个叫 Divyansh Agrawal 的开发者想了个狠招,把一整颗 32 位 RISC-V CPU 直接编译进了阿里 Qwen3.5-4B 的模型权重里,取名 Qwenputer。十一月月初第二个开发者接棒,拿这台只存在于模型里的电脑渲染出了 Doom 的一帧画面,320 乘 240,第一关 E1M1,一张 16G 显存的 RTX 5070 Ti 跑了 50.7 分钟,生成了 634 万个 token。
 chart_qp_doom.png
一帧 Doom 的代价 | 数据:项目记录、Hardware Busters
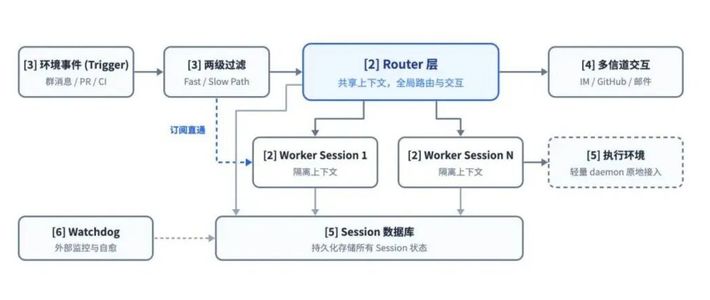
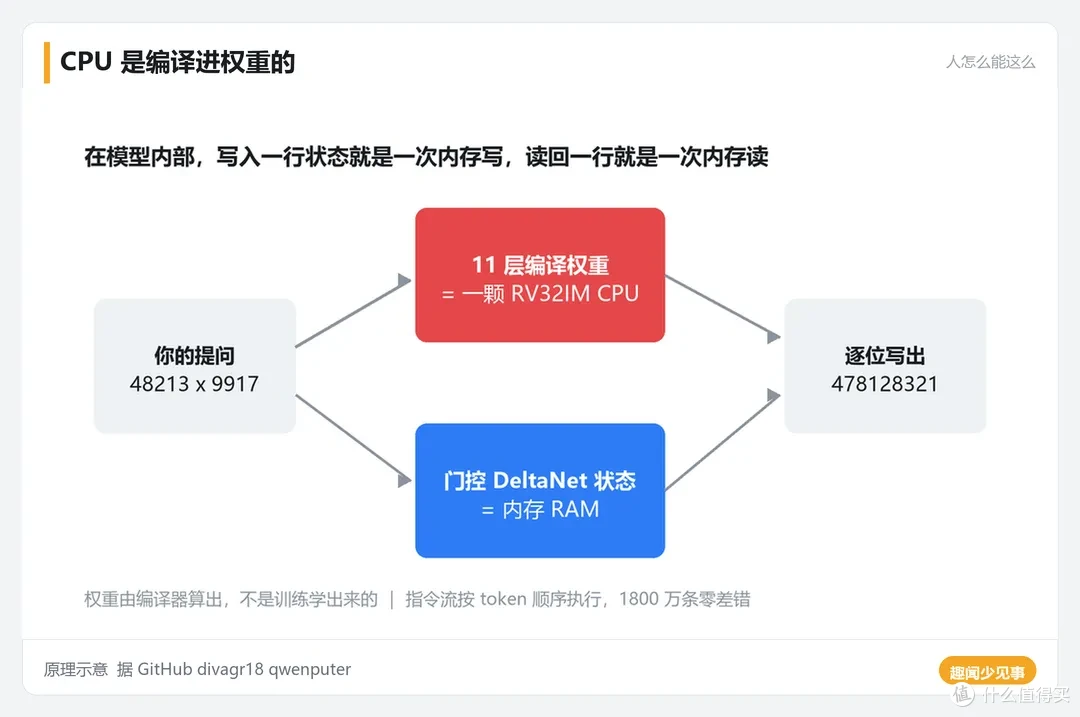
这颗 CPU 不是训练出来的,是编译出来的。模型前面加了 11 层 transformer,每层的权重都由编译器精确算出,不是从数据里学来的,所以这些层的行为是逻辑,不是概率。内存更有意思,Qwen3.5 自带一种叫门控 DeltaNet 的状态层,开发者把门锁死全开,让每次写入精确覆盖一行,这就是一次内存写,按地址读回来就是一次内存读,寄存器、程序计数器、调用栈全拆开放在这些状态里。
 qp_diagram.png
CPU 是编译进权重的 | 原理示意:据 GitHub divagr18 qwenputer
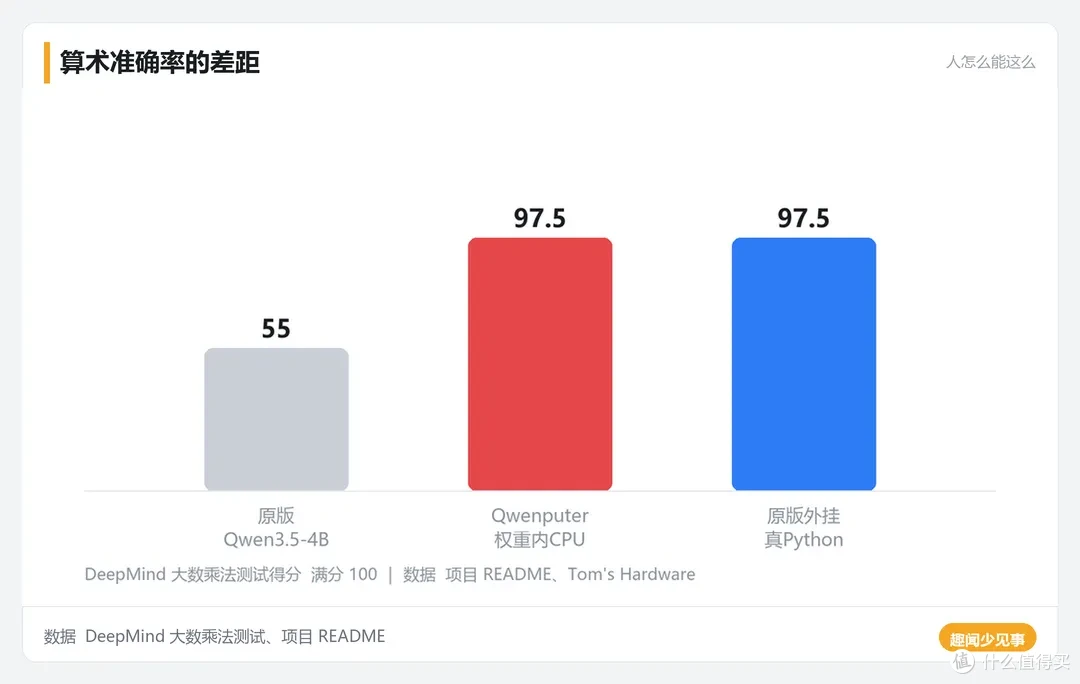
效果是实打实的,官方 RISC-V 测试套件全部通过,累计 1800 万条指令零差错,大整数乘法准确率从 55 分提到 97.5 分,跟原模型外挂一个真 Python 打平。
 chart_qp_acc.png
算术准确率的差距 | 数据:DeepMind 大数乘法测试、项目 README
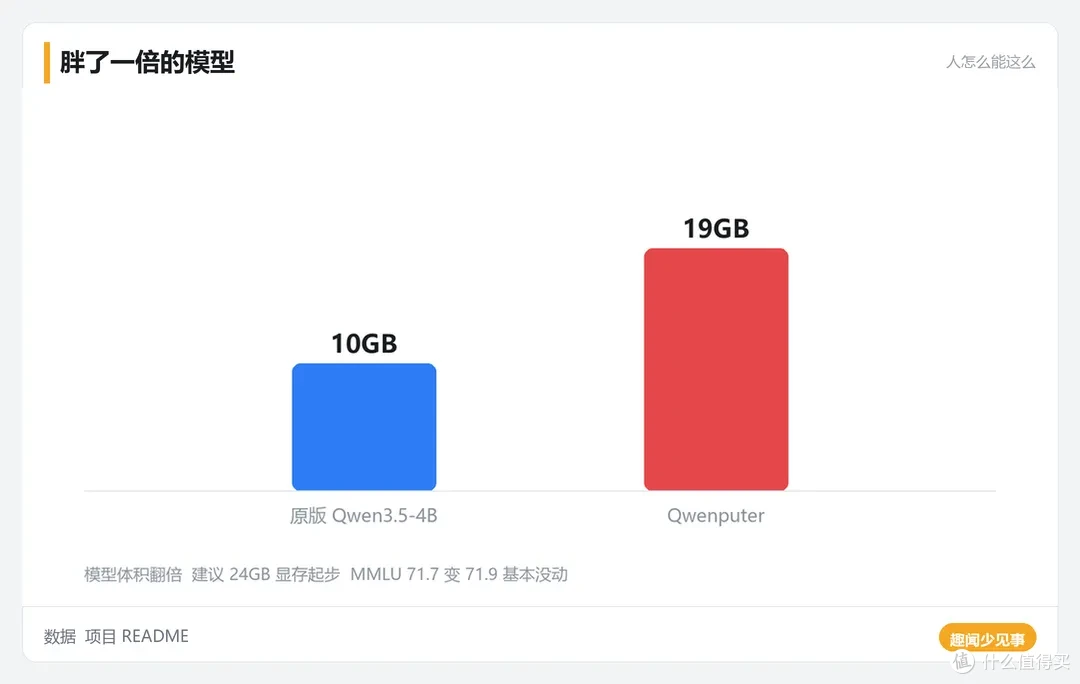
对游戏玩家说句实话,Qwenputer 当游戏机是废物,一帧 50 分钟,后来换融合执行器优化到 24 分钟,离流畅差着四五个数量级,模型体积还翻倍到 19G,24G 显存起步。但这事的重点压根不是跑游戏。大模型算术靠概率猜,猜错了就是幻觉,它自己都不知道错。现在有人证明了确定性计算可以住进概率模型里,逐位写出正确答案,正课成绩还一点没落下,MMLU 只从 71.7 变到 71.9。
 chart_qp_model.png
胖了一倍的模型 | 数据:项目 README
你的显卡一秒算几万亿次,但 AI 回你一句错误答案的时候,它连心虚都不会。这个实验给的是另一种思路,让模型在自己身体里长一颗不会骗人的处理器。
项目在 GitHub 开源,MIT 协议,权重挂在 Hugging Face,想折腾的哥们在 24G 显存的卡上就能复现,跑不动整机的可以看看它的 CHIP8 变体,还有个能存 512 个文件的模型内文件系统。普通玩家不用上手,记住一件事就行,以后再看到 AI 将取代 CPU 这种标题,把这条新闻甩过去,真取代之前,先让一帧 Doom 跑进一秒再说。
注:本文只讲原理与项目故事,不含任何复现教程与操作步骤。