我们打算下周发布。
说话人话音刚落,字幕先蹦出“我们打”,两秒后变成“我们打算不”,再过一秒才补成“我们打算下周”。一句话,屏幕闪了三下。
人看字幕,闪一下能忍。可如果字幕下面挂着一个语音 Agent,事情就不一样了。它在“我们打”那一刻可能触发“打架”相关的意图,在“我们打算不”那一刻又读出否定。等完整句子出现,动作已经发出去了。
这是网易有道 Confucius4-R2T2 想解决的问题。
九月,这款真流式语音识别模型和 14B 的流式翻译模型 T3PO 一起开源,发布五天后双双登上 Hugging Face 的 ASR 和 Translation Trending 榜首。新智元GPLP看科技
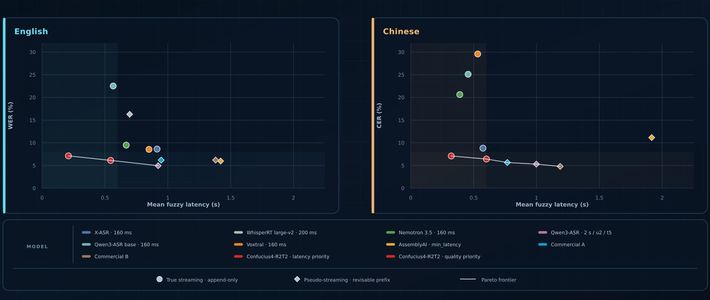
语音识别榜上,OpenAI 的 Whisper-large-v3 排在第六,英伟达 Nemotron 排在第八。微博
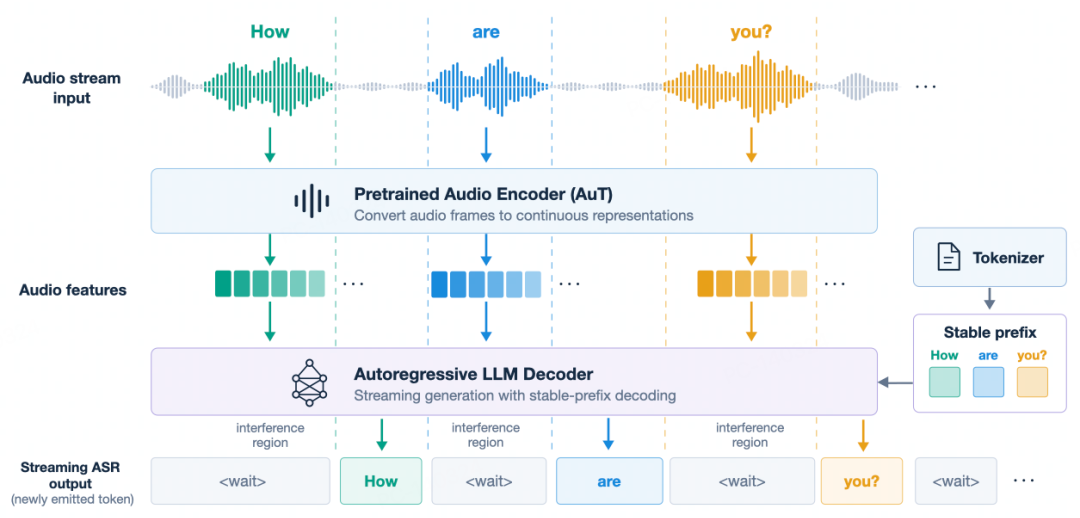
R2T2 的做法有点反直觉:已经输出的字,永久锁定,不准改。它不再靠“先猜一个、错了再回滚”换低延迟,而是每 80 毫秒判断一次——当前这段音频,我能确定到哪个字;剩下的,等。
训练时,有道没有只教模型“输出什么”,还多教了一件事:“什么时候可以输出”。
团队用一个更强的离线模型当老师,对每段音频前缀,算出它和整段音频最终识别结果的最长公共前缀,把“迟早不会变”的部分标出来,再用这些数据微调。
这套方法叫 LSP,最长稳定前缀。模型学到的不是更敢猜,而是更知道哪里该停。知乎
解码时还有一道硬约束:已经 commit 的文本,在解码路径上不可触及。“不回改”不是写在提示词里的请求,而是路径上根本没有回改这个选项。阿Q的AI笔记
数字也对得上。官方给出的中文字错率 6.42%,英文 WER 6.13%,160 毫秒 chunk 配置下平均延迟 0.55 秒。知乎新智元
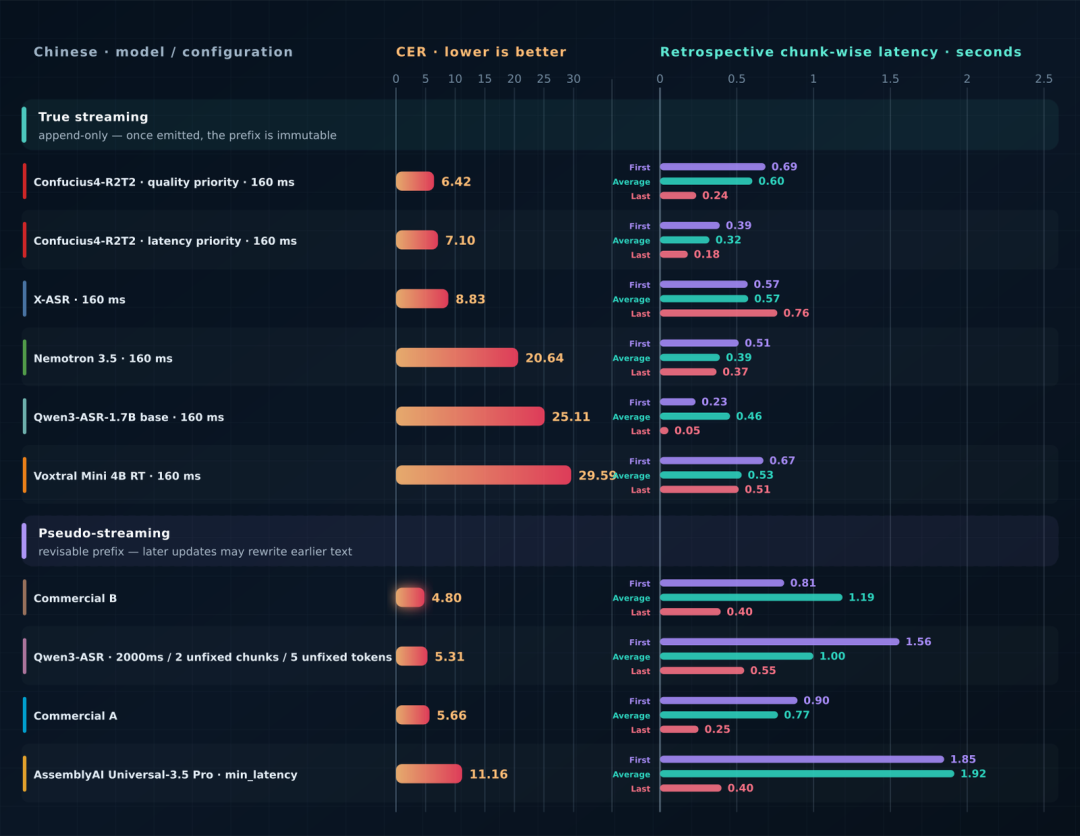
一段 50 秒英文音频、单步 2.5 秒的测试里,Whisper 重写了 16 次、等效回退 1137 个字符;R2T2 只重写 1 次、回退 39 个字符。每天玩AI
轻也是它被开发者接住的原因。R2T2 基于 Qwen3-ASR-1.7B 微调,1.7B 参数,GGUF Q8_0 量化包约 2.2GB。
有开发者在 16GB 的 M2 Pro 上用 llama.cpp 加 Metal 跑了起来,不联网也能做流式转写。Hugging Face 官方还给它搭了 ZeroGPU 在线 Demo。
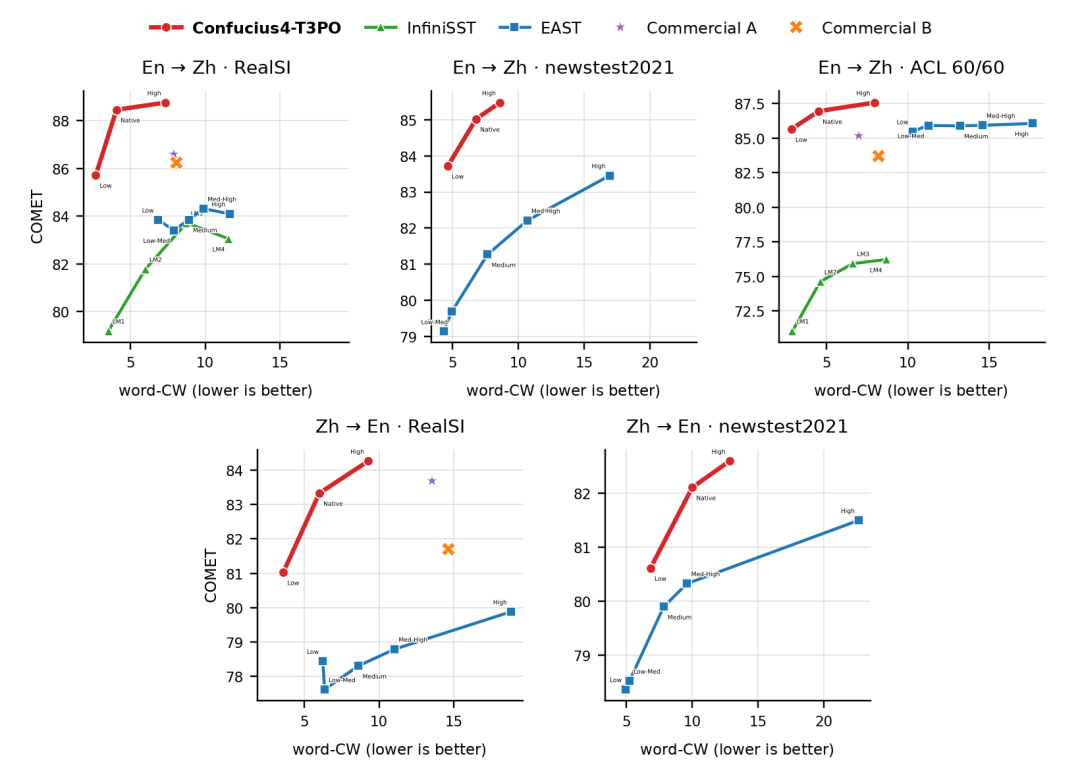
T3PO 负责另一半。R2T2 把话听成文字,T3PO 边读边译,自己判断什么时候该等上下文、什么时候可以出译文。微博
两个模型串起来,就是一条实时同传链路:跨国会议字幕、直播转译、硬件端侧都能接。在流传的一段演示里,斯坦福 Percy Liang 的公开课被配上 R2T2 和 T3PO 的实时双语字幕。霜叶
不过,把它当成“零回改”会过头。
R2T2 默认的 unfixed_token_num 是 1,末尾一个 token 仍留了微调窗口,这是工程折中;要做到任何一个 token 都不动,需要把它设成 0,并接受准确率损失。阿Q的AI笔记
中文和英文是重点优化语言,其余 29 种语言的流式表现没有公开完整基准。
延迟也随 chunk 大小和硬件变化,0.55 秒不是所有场景的保票。
对做语音产品的人来说,有一个很便宜的测试:在字幕出现的瞬间触发下游动作,看这个动作会不会被后面的字幕推翻。
会,就说明管道还是“伪流式”——延迟再低,交给下游的也只是草稿。知乎
有道过去被人记住,多是因为词典笔和查单词。这次它拿出的是一套给 Voice Agent 打底的开源件。
从“听懂”到“敢让下游立刻动手”,中间隔着的不是又一个模型,而是一个更克制的输出时机。
会等半句,才敢先说。