

说好半小时,抬头天都亮了。这不是段子,是一条 B 站视频的简介:本地模型想接进 AI 工具,地址、协议、模型名来回改。这条视频拿了 2.7 万个赞。它像极了此刻很多人:养龙虾的热火烧了快一年,千亿参数模型塞进了 12GB 游戏卡,可你真想把 AI 雇来干活才发现,真正的墙不是"跑起来",而是装上之后的三道坎:连不上、干不动、不敢放。哔哩哔哩
第一道坎:教程只教到聊天框,Agent 不认聊天框
装个 LM Studio,下个模型,聊上了,以为大功告成。一打开 OpenClaw(开源智能体框架,江湖人称"龙虾")、Codex 或 Claude Code,直接卡死。Agent 不跟人聊天,它们跟接口对话:服务地址和端口要真的在监听,得是 OpenAI/Anthropic 兼容协议,模型名要一字不差——名字里版本号、量化标记一个字符不对就全线失败。“浏览器里能用,一写代码就连接失败”,九成是把"模型跑起来了"当成了"服务上线了"。知乎知乎
第二道坎:Agent 的调用量,会把本地模型打回原形
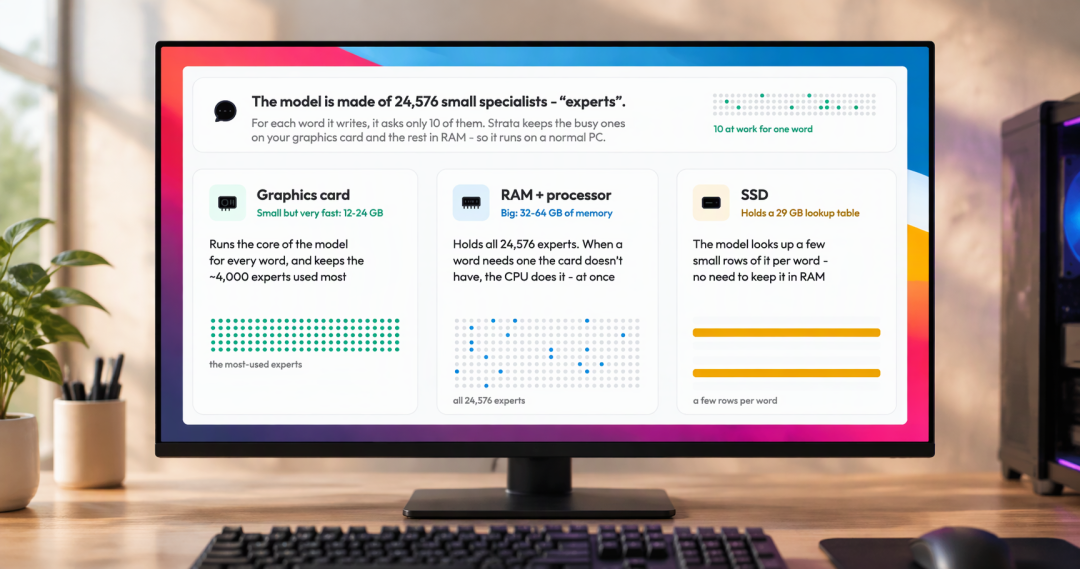
人聊天一天几轮,Agent 干一件活几十次调用、每次塞满上下文,短板全被放大:有人接进 Agent"能用,但特别慢,1 秒出 1.6 个";有人上下文卡在 16K 就溢出;还有人让龙虾跑自动化,一个月 token 花掉几百美元,任务照样不利索。所以想让龙虾真干活,得是能工具调用、上下文够长的大模型。这也是上个月 Strata 开源项目爆火的原因:把 125B 参数的 Qwen3.8-Flash-Next 塞进 12GB 游戏卡——模型 24576 个专家,每写一个字只唤 10 个,常用的留在显卡、其余放内存和 CPU,再让"先猜后验"提速 1.6 到 1.8 倍;自带 OpenAI/Anthropic 兼容接口,Claude Code 改个地址就能接。但速度这事要会看:项目方说 12GB 能跑 90 token/秒,社区实测多在 30 上下,5070 配 64GB 内存才摸到 53-94。你机器上的速度,不等于 README 里的速度。哔哩哔哩知乎微博
第三道坎:省了 API 的钱,别省权限的钱
知乎上有个 225 万浏览的问题,回答里最清醒的一句是:部署本身是最便宜的一步,真正的成本在后面——电费持续、显存被占死、模型三个月就过时、半夜服务挂了自己修。给模型装上手脚之后还多一层风险:有人让龙虾"处理一下"邮件,本地文档被悄悄删了。所以 token 账单越省,越别第一天就给满权限:最小权限、关键操作留人确认、重要目录先备份。知乎知乎
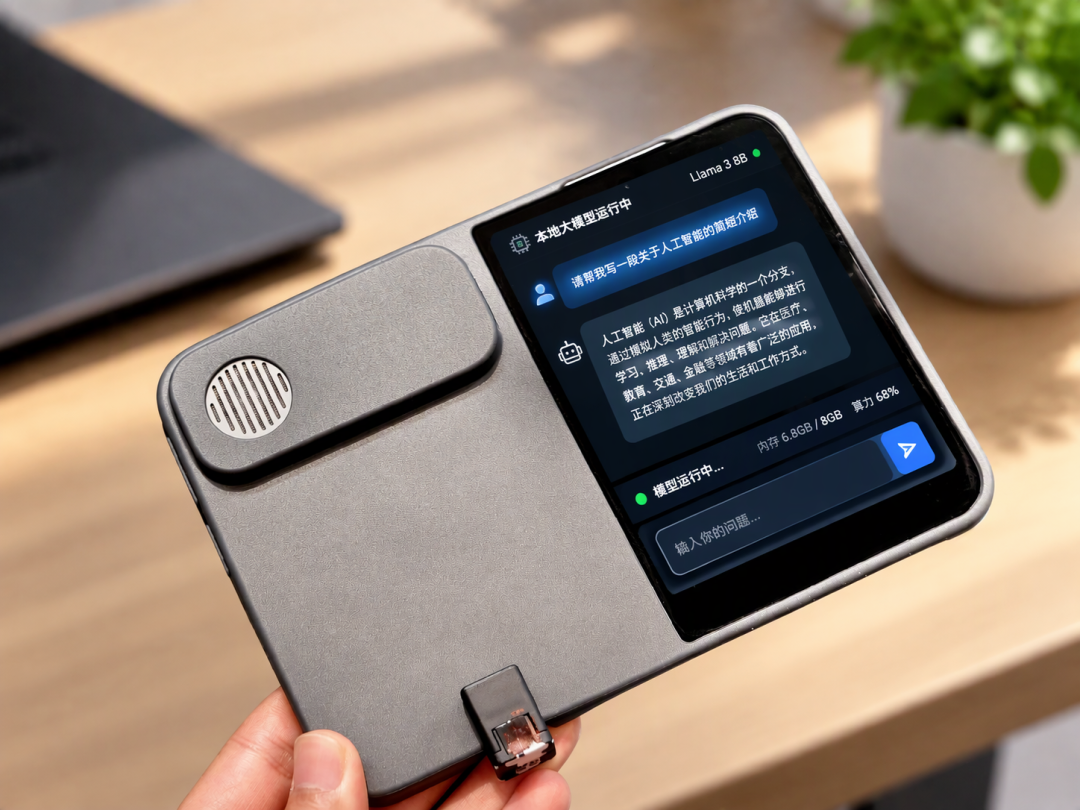
结论按人群分:只聊天、翻译、理素材,小模型加 Ollama 就够,别堆硬件;想让 Agent 真替你干活,就挑能工具调用、长上下文的大模型,内存给足;为了"token 自由"来的,记住自由是被显存和算力框死的——数据不能出内网、真离线、大用量,只有这三种场景,本地部署才划算。知乎
当前文章无评论,是时候发表评论了