9月18日,有人在 Newegg 上搜了一遍"128GB DDR5 RDIMM",数出来 11 款在售内存套装,标价从 3,893.99 美元到 6,492.99 美元(不含税运)。其中 8 款的价格,超过一整台 128GB 的英伟达 DGX Spark——那台整机里除了内存,还多一块 GB10 芯片和 4TB 固态。哔哩哔哩
一个装机党过去两年的常识是"内存是整机里最便宜的部件"。现在这条常识,在 128GB 这个容量段被内存涨价行情掰断了。

反常识是怎么算出来的
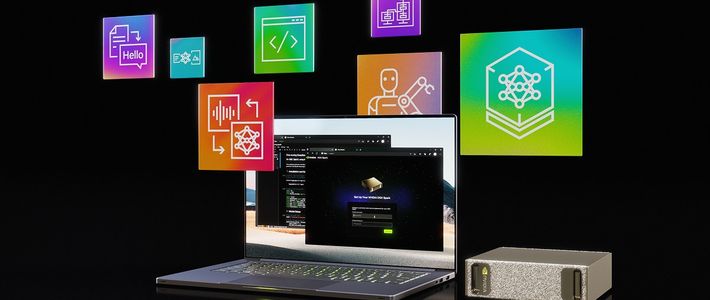
这台机器的官方口径(英伟达 DGX Spark 产品页):128GB LPDDR5X 统一内存、带宽每秒 273GB、4TB SSD、FP4 算力最高约 1 PFLOP。注意:产品页上并没有标价。目前流通的整机价格口径是 3,999 美元涨到 4,699 美元——出自 Notebookcheck 今年 2 月底的报道,转述英伟达在开发者论坛的说法,涨价理由是 DRAM 和存储成本暴涨。英伟达官方原文没查到,这个数你按"媒体转述"对待。哔哩哔哩
把 4,699 美元除以 128GB,整机每 GB 折 36.71 美元;11 款内存条的每 GB 中位数是 39.37 美元,比整机贵 7%;最贵那条 128GB 单条每 GB 50.73 美元,贵 38%。但别急着喊"整机完胜":11 款里也有 3 款比整机便宜(其中 1 款还缺货),最便宜的 V-COLOR 64GB×2 套装 4,136.99 美元,比整机省 562 美元。所以准确说法是大多数零售 128GB 内存套装,现在比一整台带 128GB 内存的 AI 小主机贵。
国内行情同向。一位 8 月自购的知乎车主 9 月 5 日复盘:入手时 3.4 万,官方价一个多月奔着 4 万去,涨了快 20%。小红书 9 月 16 日也有帖子提醒:别等降价了,官方售价已经调整、GB10 版本现货越来越难找。知乎小红书
OEM 版也在水涨船高:技嘉 AITOP ATOM(DGX Spark 的 OEM 版)8 月初有人 34,999 上车。小红书晒出的两台 Spark 淘宝在售价是 73,499 元。评论区甚至出现了"6 月初 3 万左右买的,现在倒手赚一两万"的理财叙事——一台电子产品,被内存行情逼出了保值属性。哔哩哔哩小红书
为什么英伟达能"整机比内存便宜"
两个原因,都不神秘:
一是采购身份不同。整机里是焊死的 LPDDR5X,英伟达是按晶圆厂长约大批量拿货的(此前已有报道称英伟达把内存长约锁到了 2031 年);你今天零售买的 DDR5 RDIMM,是被同一轮涨价逐级加价后摆上货架的货。OEM 拿货价和玩家拿货价之间,隔着这一轮内存周期的全部暴利。
二是比价的边界。这个对比只回答一个问题:现在获得 128GB 内存容量,哪个通道更便宜。它不回答"这台机器对你有没有用"。而且板载 LPDDR5X 意味着内存不可升级、不可拆卖——你没法把它拆下来去喂你的下一台装机。

真正要给这轮反转降温的,是下面这组数。
“装得下"和"跑得快”,隔着一条 273GB/s 的硬线
社区里对这台机器的分歧,全在带宽上。一位折腾了一个多月的知乎车主给出了自购实测:Qwen3.6-35B-A3B 用 llama.cpp 跑,占用约 22.8GB,速度约 60 tok/s。Qwen3.8-27B 近 20 tok/s,占不到 40GB。两个模型同时驻留,内存还剩小一半——对他这种单用户、Agent+日常任务的用法,一台够用。知乎
他还给了一个很直观的解释模型:生成 token 时 GPU 要把模型参数反复过一遍,273GB/s 带宽下跑一个约 35GB 占用的 27B 量化模型,纯带宽视角的上限只有约 7.8 次/秒量级。缓存、MoE 稀疏激活、量化格式、投机解码都会改变实际结果,所以实测 20-60 能高于这个粗估,但容量的事两台机器能解决,速度这台机器的物理上限摆在那:双机互联(ConnectX-7)不带宽翻倍,扩的是"能不能装下"——社区实测两台跑 Q4 版 DeepSeek V4 Flash,单机 128GB 装不下的 510GB 级别模型才轮到多机方案。知乎
反驳信号同样密集,必须放在这:B站选购指南视频热评(276 赞的总结)给的口径是 Spark 跑 70B 只有 12-16 tok/s、“输出慢得离谱”。还有人称 vLLM 下 27B FP8 只跑出 3 tok/s(框架与量化差异巨大,同一台机器从 3 到 60 都有人晒)。软件层的坑也没填完:Windows ARM 版驱动至今不全。9 月 17 日还有车主实测 DCGM 诊断插件大面积跳过,也有个别"发热大、随机死机"的自述。这台的真实状态是:Ubuntu+llama.cpp 路线成熟且够用,Windows 和全家桶场景还没准备好,参数表上的 1 PFLOP 帮不了带宽的忙。哔哩哔哩哔哩哔哩
这轮反转真正影响的,是你手里 3-4 万预算的走法
过去半年,这个预算的主流纠结是"5090 还是魔改 96G 还是 Mac Studio"。内存这条涨价曲线把第三类选项挤了出来,并把各条路的成本重新排了序:

自己攒 128GB 内存的 AI 工作站:以前最便宜的扩容路线。现在零售 RDIMM 每 GB 比 Spark 整机贵 7%-38%,还要另配 GPU、CPU、硬盘。DIY 路线在这一容量段第一次打不过 OEM 整机——这是对"等等党攒机"逻辑的反向打脸。
AMD AI Max+ 395 小主机:同为 128GB、带宽两百多 GB/s,年初 1.1 万时被嫌弃,如今涨到约 2 万。它的存在提醒一件事:Spark 的溢价你买的不是内存,是那 273GB/s 之外的 CUDA 生态和双机互联。
Mac Studio M5 Ultra 256GB:约 8.6 万,带宽 1.2TB/s,装得更大跑得也不慢,但 prefill 短板和"CUDA 系模型/工具不支持"的坑,评论区两边车主互喷了两个月。
纯 API:最冷的水。DeepSeek V4-Flash 2026 年峰谷定价输出 9 元/百万 token、空闲 4.5 元。一位车主算过自己"生成 440 条数据集"的账:本地磨 4.5 小时,或者 API 空闲时段约 270 元(还只算了输出)。热评说得更直白,三万五拿去买 Token 就能玩到飞起了。反方论据同样真实:API 说改规则就改规则、数据出不出门、以及"35000 的 token 用完就没了,这玩意还能出二手"。知乎哔哩哔哩
动手之前,把这三组数自己核一遍
你的月 token 账单。翻过去三个月的 AI 订阅/API 发票:月消耗换成功率模型值不值 4 万?只是聊天码字,订阅+API 的路线没有任何行情能翻盘;Agent 长上下文重度使用、多用户并发、数据不能出本地,才进入讨论区。
你的模型体量。主力需求在 27B/35B 稠密或 MoE 这一档,单台就够,别听"两台起步"的焦虑;需要 100B+ 或满血 V4 Flash,预算直接从 4 万跳到 8-15 万(双机到四机),这是另一道题。
你的延迟容忍度和折腾半径。能不能接受单台首字十几秒、只走 Linux、驱动等半年?评论区一句话点破:“跑得动不代表用的爽。”
继续盯四个信号:内存批价这轮拐点(拐点一来,"整机比内存便宜"的红利会先缩水)、DGX Spark 国内现货和官方价变动、RTX Spark/Windows ARM 驱动补全时间、以及 MeraLink 这类把 Spark 算力按小时挂出去卖的出租回报是否可持续。现有回本口径(7 个月、10 个月)全是车主自述,没人给审计数。哔哩哔哩
这轮反转最扎心的结论其实不是"DGX Spark 值得买",而是:你 DIY 的成本线,被内存厂抬到了英伟达长约价之上。老黄没给你发福利,他只是用批发价,给你演示了一遍什么叫结构性差价。