













 深耕居家、数码兴趣领域




15
11
本地跑AI大模型,还想剪视频、玩3A游戏?RTX Spark用给出新解法
2026-10-17 12:32:00
0点赞
2收藏
1评论
哈喽,大家好,我是@梁粤Leo。作为一个AI大模型爱好者,我强烈感受到,现在选购电脑的逻辑已经不一样了。想在本地跑大模型的朋友,基本都算过这笔账:显卡算力够不够,显存能装多大的模型,升级又要花多少钱。
普通独显台式机,显存到24GB基本到顶。RTX 5090的32GB已是消费级顶端,但它也只能跑中等参数的模型,再大,输出速度就很慢。降低量化精度能装下,模型又会笨到没法用。走Mac路线,统一内存确实管够,但没有Windows软件生态,没有CUDA,也没有游戏体验。
本地大模型跑得快、剪视频出图不卡、游戏玩得爽,三个需求放一台电脑上,现实里往往是三选二,预算还得往高了抬。
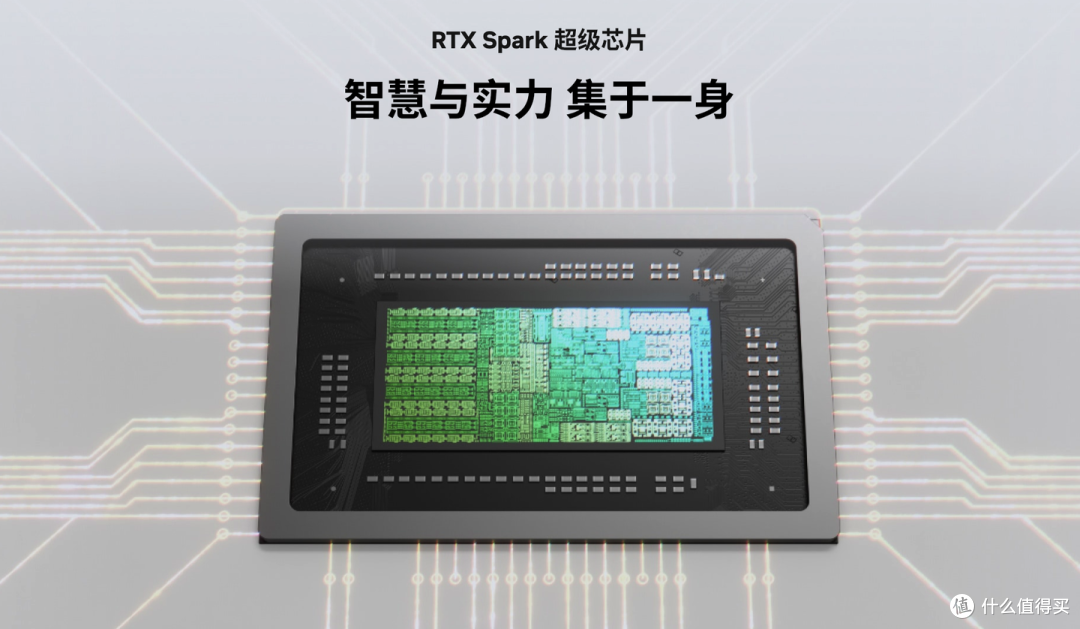
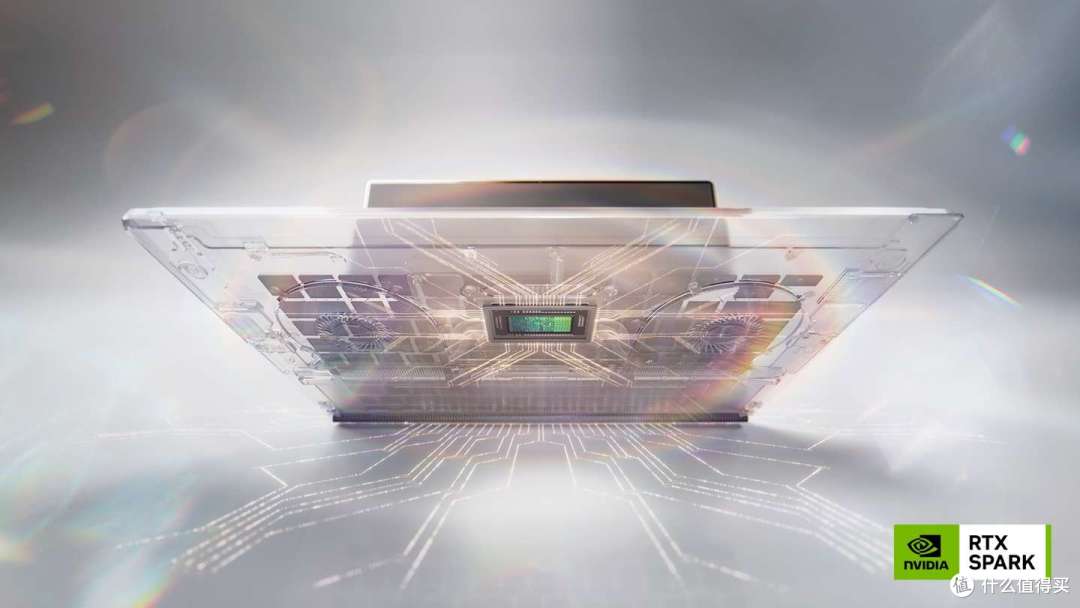
英伟达这次给了个新路数:将Grace CPU、Blackwell RTX GPU和最高128GB统一内存装进同一颗芯片,做成Windows笔记本和紧凑型桌面主机。这也是Windows阵营第一次有真正意义上的统一内存。跑本地大模型不用再堆天价显存,也不用纠结选大显存还是大内存。创作和游戏,照旧走RTX那套成熟体系。
接下来我就从RTX Spark的平台设计、能跑多大的AI模型,创作和游戏表现四大维度来拆解一下皮衣哥的新招式,看看它给我们带来的到底是真解法还是新噱头。
一、平台设计:统一内存加RTX,怎么凑到一颗芯片里
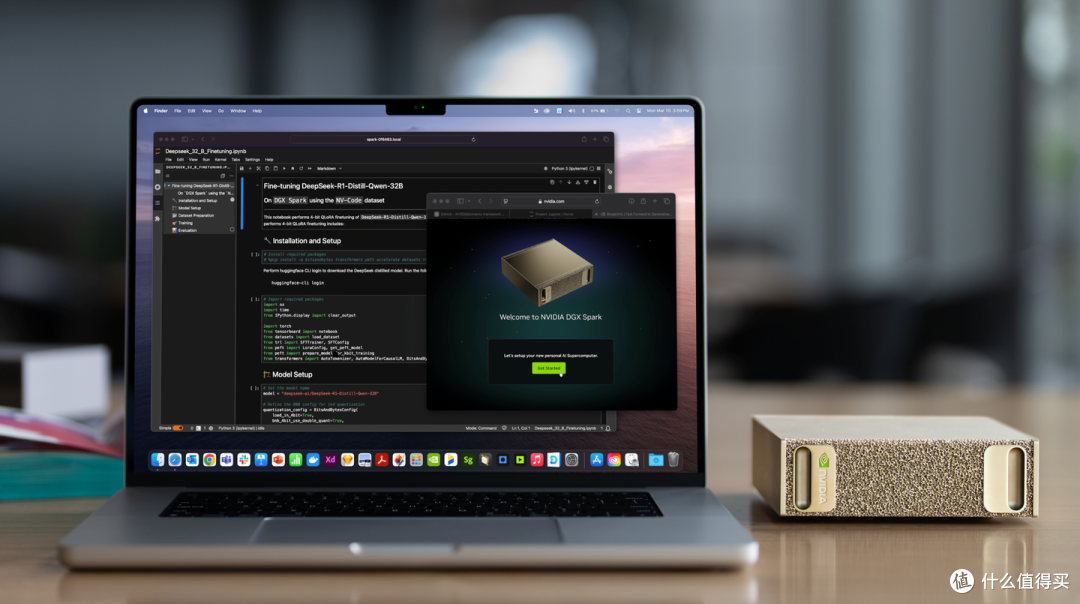
统一内存不是黄仁勋拍脑门想出来的。2025年英伟达先推出了DGX Spark,巴掌大的一台「桌面AI超算」,用的正是同一套Grace CPU加Blackwell GPU加统一内存的方案。不过,DGX Spark主要面向开发者和行业级用户,运行的是Linux系统。
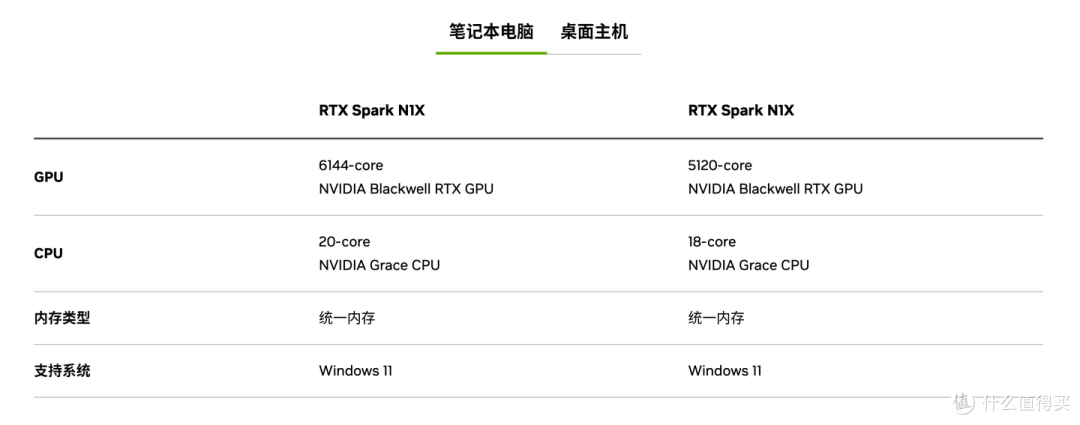
现在这条技术路线已经验证的差不多了,这才有了面向普通消费者的RTX Spark:正经的Windows 11产品,CUDA、Studio驱动、DLSS、NVENC整套RTX体系照单全收。
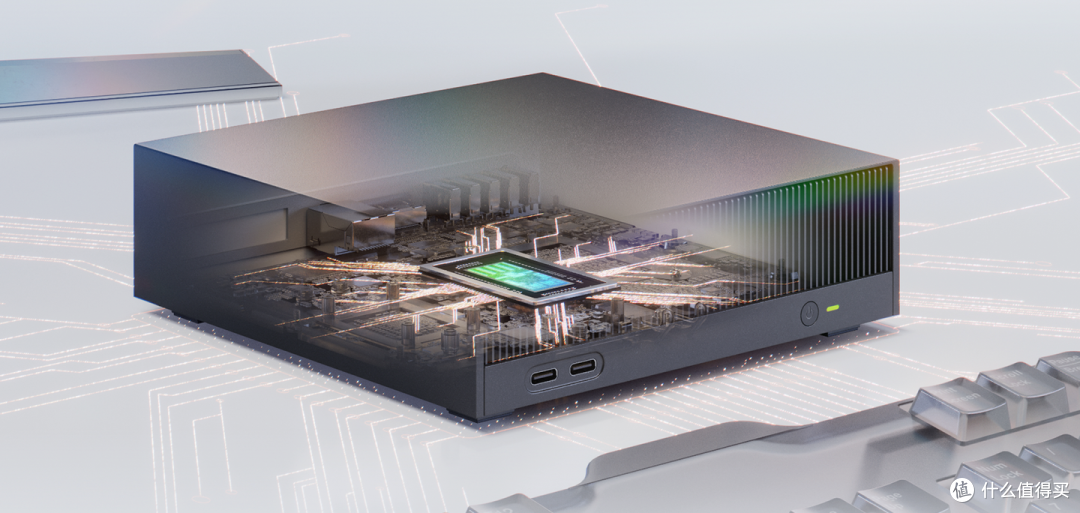
简单来说就是RTX Spark等于把DGX Spark在行业级验证过的架构带进消费级市场。也是第一次将RTX+统一内存在Windows生态落地,并覆盖笔记本和紧凑型桌面主机,同时还更适配日常创作和游戏体验。
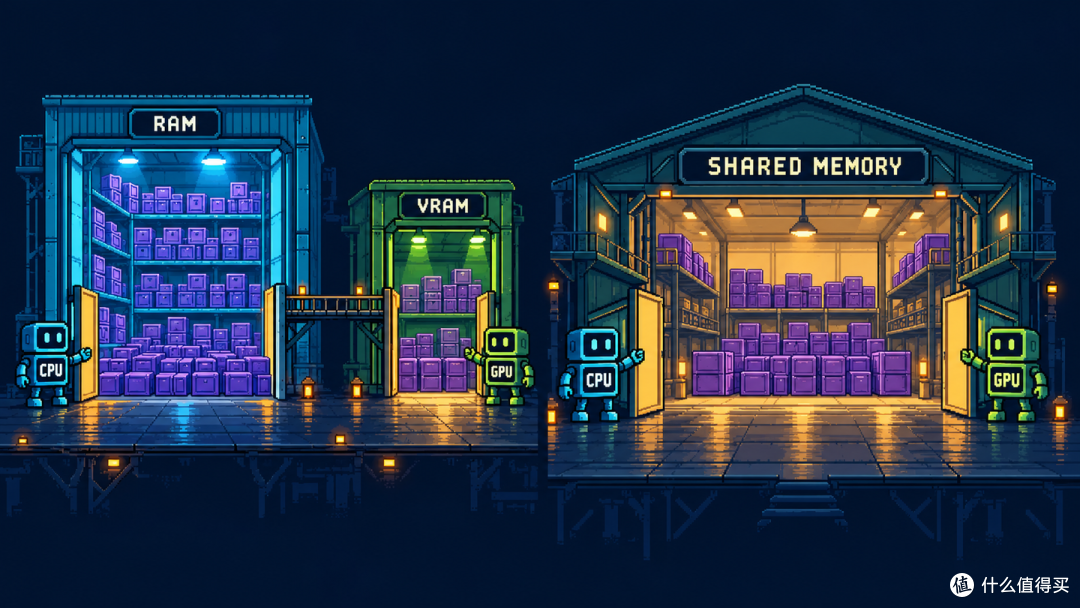
传统PC里CPU和GPU各管一摊:CPU用内存,容量大、带宽低;GPU用显存,带宽高、容量小。跑本地大模型时这就成了死结。而RTX Spark集成NVIDIA Blackwell RTX GPU(最高6144核)与高达20核心的NVIDIA Grace CPU,它们之间走NVLink-C2C互连,互连带宽能达到600GB/s,FP4 AI性能达1PFLOPS。同时,它们能共享最高128G内存池,为大型模型和复杂场景提供更多空间。
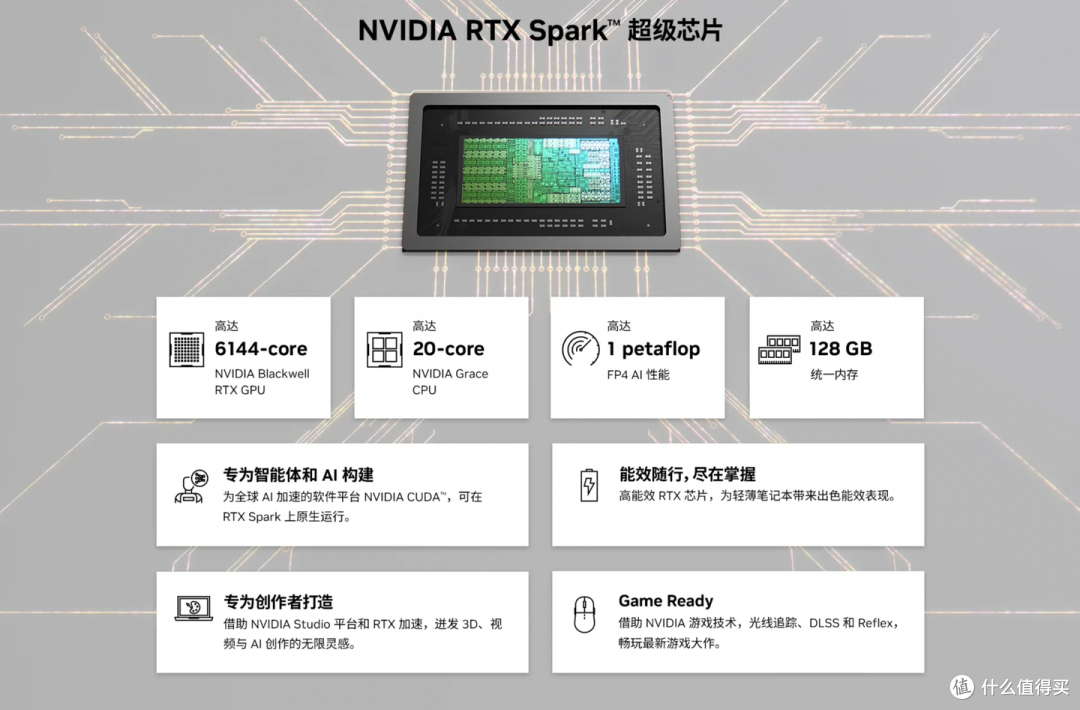
除了统一内存架构,RTX Spark的另一大看点,就是把统一内存和CUDA、RTX生态结合到了一起:让本地运行的AI大模型有CUDA和TensorRT加速,创作有RTX和OptiX,游戏有光追、DLSS、Reflex。熟悉这套工具的用户,不用再重新折腾,就能无缝衔接。
二、能跑多大的AI模型:容量之外,更要跑得动
英伟达官方宣称RTX Spark可以在本地运行通义千问3.8 Flash Next等125B参数级模型(51B n-gram),能够媲美云端模型效果,本地推理时,输入数据也无需发送到云端。
什么概念?想要安装前段时间很火的千问3.8 27B,来说,Q8版本的模型文件已经接近30GB,BF16原版则约56GB,运行时还要额外留出上下文缓存和工作空间。
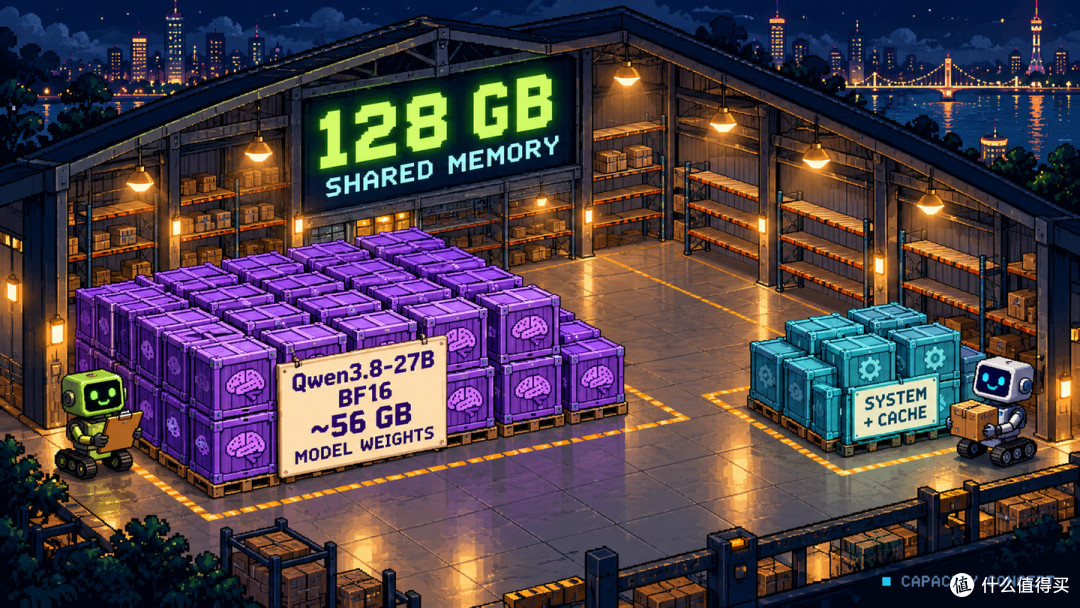
如果希望将模型完整放进24GB显存,就需要选择更低精度的量化版本,或者调整部署方式。而128GB统一内存为BF16权重留下了足够的容量空间,让用户有机会保留原版权重精度,不必仅仅为了装得下模型而进一步压缩。模型什么水平就是什么水平,不用打折。
这就是大内存带来的选择权:可以优先保留精度,也可以继续使用量化,为更长上下文和其他任务留出空间。
不过比起「能装多大的模型」,我更关心多出来的空间能干什么活。
本地无限免费出图,降低反复试错的门槛
做产品测评封面时,AI生成第一张图往往只是开始。构图合适了,背景可能不对;产品位置对了,光线和文字留白又要调整。一张满意的封面,可能需要反复尝试十几次,甚至几十次。
云端按张收费,一次头脑风暴几十块就没了,试错成本高到不敢放开手脚。而本地出图,只需要付出电力成本就可以了。再也不用因为按次数付费而妥协效果,也不用时刻盯着剩余额度、决定要不要继续修改。
或许有朋友说,现在在普通的RTX电脑上装上ComfyUI,也能做到类似的效果。但RTX Spark的价值在于,在更好、更快地完成生图和视频生成工作的同时,还能继续执行其他任务。因为我们使用生成工作时,还要挂参考图控制模型,处理生成出来的高分辨率图,以及通过图片继续生成视频等多个模型的工作流协同。这个时候,普通RTX显卡的电脑就无法完成了。比如我自己在使用ComfyUI生图的时候,就不敢同时进行视频剪辑或PS图片处理工作。必须等生图工作完成之后,关闭ComfyUI服务,才敢继续进行接下来的工作流。
当然,节点多也不一定等于内存一定占得多,还得看工作流怎么跑。对经常生成、修改、筛选素材的人来说,流程能不能完整跑通,和单张生成速度一样重要。
让本地模型帮忙做些具体的事
除了出图,我也关心本地模型能不能帮忙干粗活和杂活,比如批量整理素材、建立语义搜索索引以及整理素材工具。
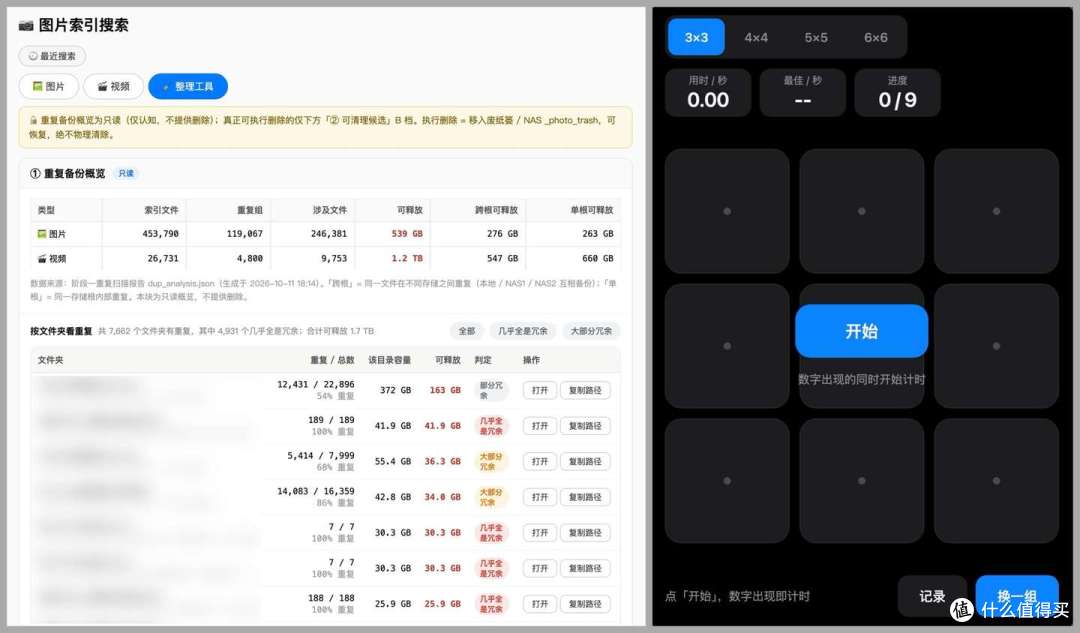
另外,它还能帮我生成一些非常实用的小工具。这两天正好我想给我儿子做舒尔特方格训练,想提高他的注意力。结果我在网上找了一圈APP和小程序,都有非常多的广告。使用两次就要弹出好几秒的广告,才能继续进行。然后我就用AI直接自己生成了一个无广告的纯净版,效果非常好;想要什么功能,还能自己加。如果这些任务能交给本地模型,就完全不用担心消耗token额度。
有兴趣的朋友也可以点进去玩一下:
https://schulte-grid-82062.app.workbuddy.host/
养一个全天在线的本地AI智能体
AI智能体是今年最热的AI形态。它不是简单的一问一答聊天框,而是能自己拆任务、调用工具、连续干活的数字助理。现在OpenClaw、Hermes Agent这些开源项目的爆发,也说明大家都想拥有一个自己的智能体。
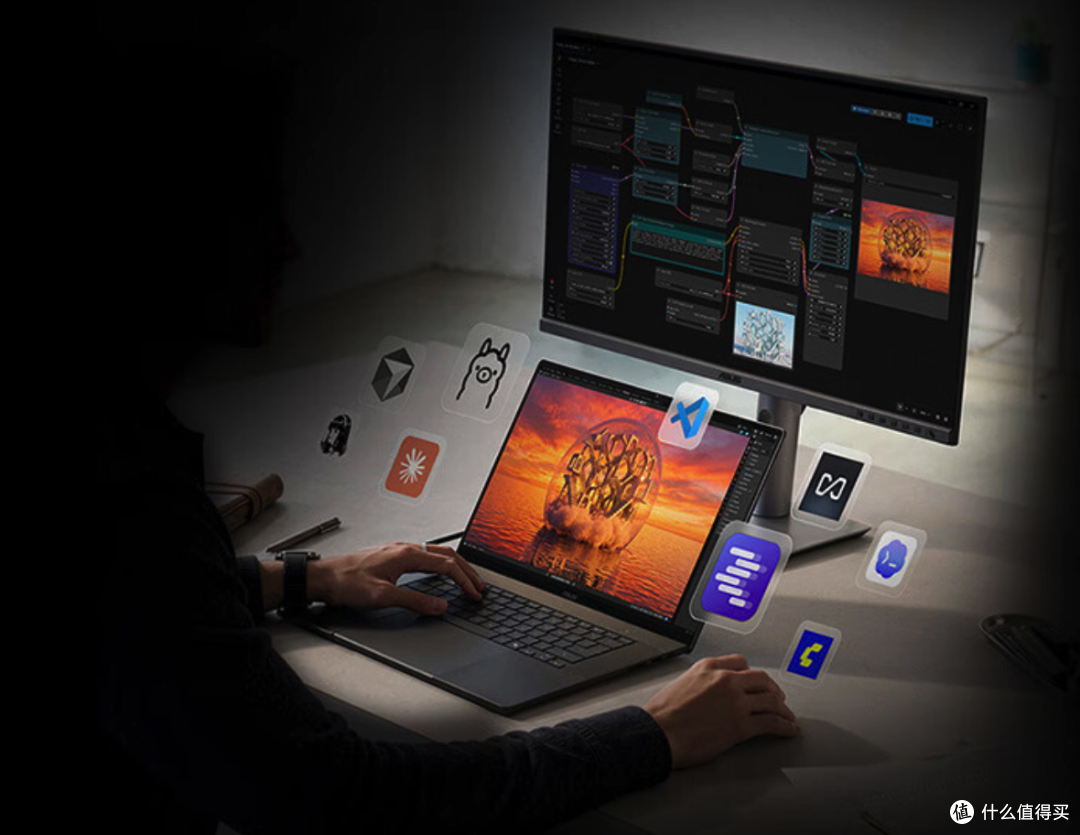
但智能体是内存大户。模型权重、长上下文、工具进程都要常驻,普通PC跑聊天模型够用,跑智能体就捉襟见肘。很多人最后还是得回到云端API,按token交租。
RTX Spark就是冲着这个场景来的。英伟达和微软合作,给Windows加了新的安全机制,配合NVIDIA OpenShell运行时,智能体可以安全地常驻本地后台。让这些能够操作文件、调用工具的 AI 智能体使用起来更可控。
官方的定位说得很直白,这是第一批为个人智能体打造的Windows PC。数据留在本机,不按token计费,桌面主机甚至可以直接当7x24小时在线的智能体机器用。
我自己现在的选题、资料整理、多平台发布流程,背后都有智能体在跑。痛点很明显,要么烧云端额度,要么占一台主力机。如果一台低功耗的本地机器能干完这些活,数据还留在本地,方便快速整理,这个场景比单纯跑大模型更能打动我。
三、AI创作这条链,第一次能在一台机器上闭环
对创作者来说,生成素材只完成了前半段。拿产品测评视频来说,本地模型辅助整理脚本,ComfyUI调分镜和封面,选定素材后还要修图、剪辑、调色、加字幕,最后导出成片。这条流程要经过好几个软件。
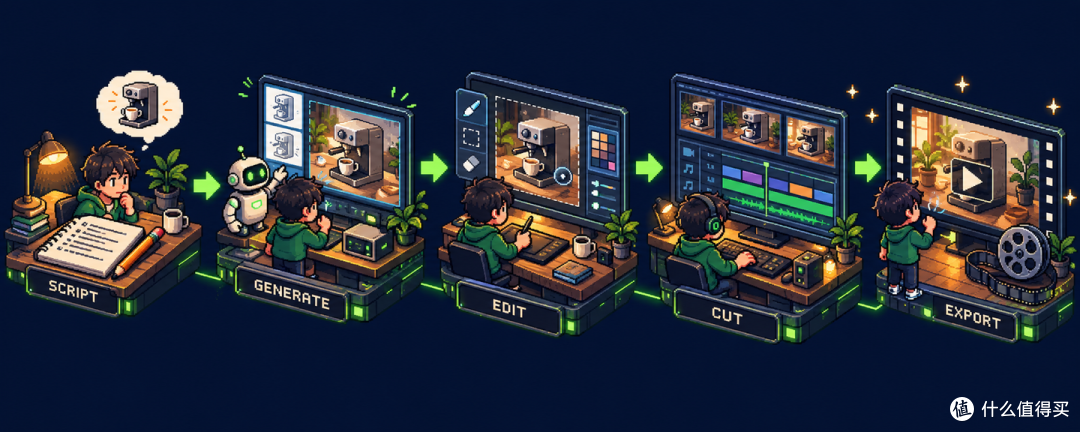
很多人以为剪视频吃的是显卡算力,其实吃的是专用硬件单元。Blackwell的NVENC/NVDEC是我认为对创作者最实在的升级,支持AV1编码与解码,也补上了H.264、HEVC的4:2:2硬件支持。
对我的日常工作而言,现在基本都是4K素材。尤其涉及4:2:2素材时,硬件解码支持就有实际意义:剪辑过程中反复拖动、预览和调整,都会用到素材解码能力。
英伟达也在与Adobe合作,针对RTX Spark优化Premiere和Photoshop,让统一内存、GPU与TensorRT更好地参与编辑、调色和图像处理。不用在「渲染缓存」和「系统流畅」之间二选一。
因此,RTX Spark是真正能够把出图和剪辑串起来,ComfyUI出封面和分镜,图生视频拿到动态素材,拖进同一台机器的时间线剪辑调色,NVENC导出AV1成片。前面反复试错在本地免费,后面加速处理有RTX,一台机器完成闭环。
四、游戏体验:做完工作,还能玩3A吗?
RTX Spark搭载Blackwell RTX GPU,支持硬件光线追踪、DLSS 5、Reflex和G-SYNC。简单来说就是传统RTX显卡有的,它都有。因此它可以借助这些RTX技术,在1440p分辨率下实现超过100FPS的3A游戏体验。
不过,虽然GPU支持RTX技术,但RTX Spark 毕竟采用的是 Arm 架构,Windows 游戏生态的兼容性问题还是绕不开。
好消息是,这次英伟达并不是只准备好了硬件,游戏厂商也开始跟进。比如《心灵杀手 2》《永劫无间》等作品已经被列入官方公布的兼容游戏阵容。10 月 6 日,鹰角网络也确认,《明日方舟:终末地》即将支持 RTX Spark 笔记本。此外,《绝地求生》《英雄联盟》《无畏契约》等热门游戏也在推进适配。
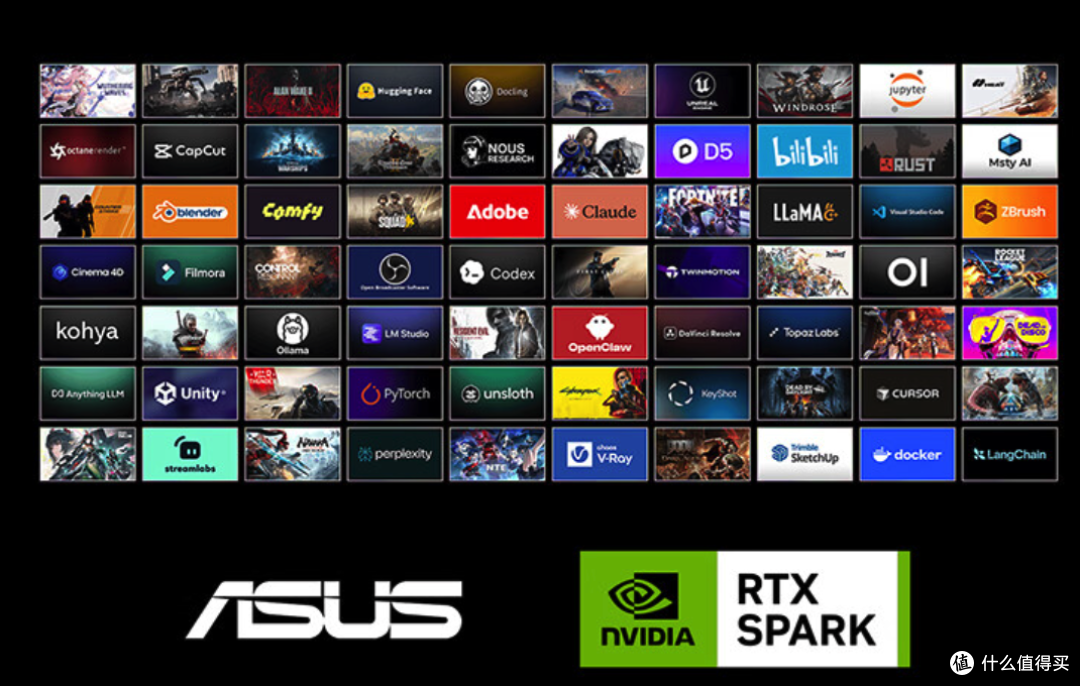
当然,这不代表所有 Windows 游戏都能直接运行。部分 x86 游戏需要通过 Prism 转译,而涉及反作弊驱动的网游,以及一些老游戏、小众游戏,仍然可能遇到兼容性问题。
所以,如果主要是为了打游戏,同价位的传统 RTX 独显电脑依然是更稳妥的选择。但如果你本来就需要一台运行本地 AI、处理视频和图片的生产力电脑,工作之余还能玩一些自己喜欢的 3A 游戏,那 RTX Spark 就是当下最佳的选择。
总结:RTX Spark适合什么样的人?
回到开头那笔账。三个需求:“模型跑得快、剪视频出图不卡、游戏玩得爽”,占两个以上的,RTX Spark值得进候选清单。统一内存解决"装得下"和“跑得快”,RTX体系解决"干得了"和“玩得爽”,尤其是「本地大模型加创作闭环」这件事,Windows阵营确实第一次有了自己的答案。
如果只是轻度AI绘图、普通剪辑,或者主要玩游戏,传统RTX电脑仍然有成熟的选择。
但如果经常需要运行大模型、尝试复杂AI生成流程,同时又依赖RTX创作工具,希望一台设备兼顾工作与游戏,RTX Spark绝对是一个新的版本答案。
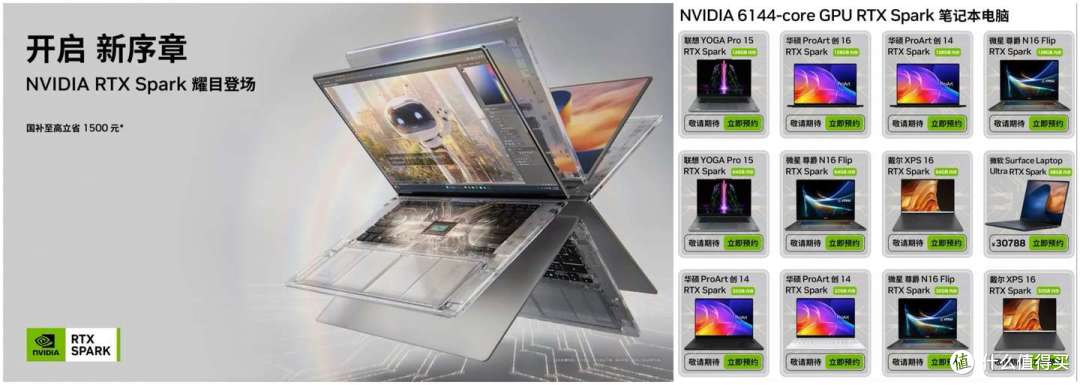
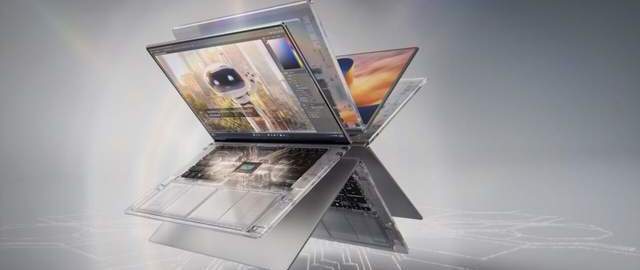
首批机型已经就位:Surface Laptop Ultra、华硕ProArt P14/P16、戴尔XPS 16 Creator等。笔记本产品大约在10月16日开始陆续上市,而桌面主机会在11月跟上,基本能赶上双十一活动,大家可以期待一波。










校验提示文案
校验提示文案