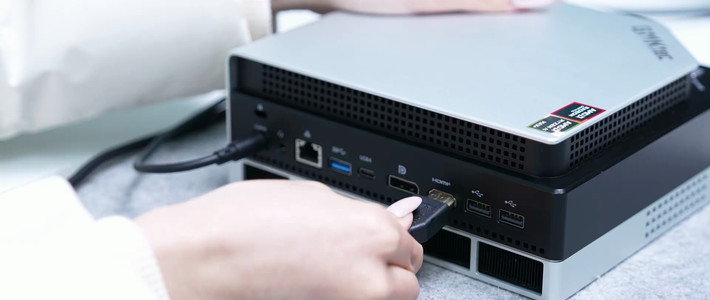
这波“本地千亿大模型落地国产PC”的宣传潮里,机器上真正跑起来的基本都是深度量化后的MoE总参数模型,生成速度多在十几tokens/s量级,而宣传引用的性能数字几乎都经不起第三方复测。十月上旬,极摩客官方渠道发布EVO‑X5 Pro,宣称它是“全球首台可适配完全离线运行320B参数大语言模型”的桌面AI超算,192GB+2TB版定价46999元。 联想YOGA Pro 15 RTX Spark机型在开启预约时的口径则是“本地运行超千亿参数大模型”,而它随机器实际交付的是35B。 以下三个坑,付款前逐个核对。哔哩哔哩知乎
第一坑:宣传的“千亿”“320B”是总参数,不是机器实际扛着的负载
这批“千亿级”几乎全是MoE(混合专家)架构:总参数很大,每次推理只激活一小部分。蚂蚁10月15日开源的Ling-3.1-flash标称560B参数,实际是“72层、512个路由专家、每token只激活8个”。 微软十月初展示的MAI-Code-1.1-Flash也披露了同样的折算:拥有1370亿总参数,但每次推理仅激活约68亿参数。 也就是说,“本地跑千亿”的真实含义往往是跑一个激活规模只有几B的模型,而不是大众想象中的满血千亿。同一款极摩客机器自己也在参数口径上漂移过:IFA期间通稿宣称的是“可完整离线运行300B参数大语言模型”,不到一个月后的国内发布会改成了320B。36氪知乎知乎
第二重折算来自量化。微软把MAI-Code-1.1-Flash压到约53GB的本地版本,但微软在 Surface Laptop Ultra 上的测试数据显示,MAI-Code-1.1-Flash 开启 256K 上下文时,峰值内存占用可达 75.5GB;微软也建议使用 120GB 以上内存的设备,才能获得最优性能。 文件体积、运行时内存是两回事,长上下文的KV缓存要再吃掉几十GB。蚂蚁也在发布材料里自注:4卡是特定测试条件下的数字,不能直接当采购清单。 普通用户只需记住通行的配置梯度:8GB显存适合4B—7B;16GB可跑9B—14B;24GB进入24B—27B;120B模型通常需要80GB以上显存或大容量统一内存。 低于这个门槛却宣称跑千亿的,跑的必然不是宣传里那个模型。知乎36氪36氪
第二坑:速度上限写在内存带宽里,“装得下”和“用得爽”隔着一个数量级
国内媒体拿到EVO‑X5 Pro后的独立实测给出的体感是:DeepSeek V4-Flash:启动约1分钟,GPU占用约130GB,生成速度约17 tokens/s,首token延迟2.1秒。 另一篇“实测”的数字更低:14 token/s 属于「能用但不算快」,预填速度也慢,长上下文的首字等待需要一点耐心,而作者也在文首自述是受邀到发布会现场的嘉宾,测试机预装了配套推理引擎。 打开投机解码能冲到约27 tokens/s,但那是推理引擎的加成,不是这台硬件的本事。哔哩哔哩知乎
瓶颈的位置很明确:495平台把统一内存带宽推到约273GB/s,而上一代128GB平台对同一款模型是“根本启动不了”。 横向评测同样显示:DeepSeek R1 671B Q4(256GB 内存):6–9 tok/s,而128GB的锐龙AI Max+ 395跑120B级MoE只有约11 tok/s。 核数、TOPS、NPU算力都不决定这件事,输出速度的上限写在内存容量和带宽里。知乎知乎
国产CPU信创平台的水位又低一档。龙芯3A6000的公开实测是7B模型纯CPU推理4.6tokens/s,加装RX580独显后约16.2tokens/s;那是2025年初的数字,之后新平台的“跑通”内容大多停留在演示、没有公开吞吐数据。 真正有量级差距的是服务器产品:国产加速卡海光BW1000部署Qwen3.5,实测峰值600+token/s,但那是数据中心DCU,不是PC。 “国产算力适配千亿”和“国产PC跑千亿”,目前是两个世界。哔哩哔哩哔哩哔哩
第三坑:数字越精确,越可能没人复测过
信创本的宣传数字是这一坑的典型:长城N90 Pro(飞腾D3000M 8核+力擎LQ50 160TOPS)被广泛引用的“本地35B约30 Tokens/s、接近云端API”,唯一出处是一段宣传通稿:根据公开的技术白皮书数据,N90 Pro在本地运行35B模型时,推理速度可达约30 Tokens/s,这一水平已与云端轻量级API的响应性能相近。白皮书原文并未公开,也没有任何第三方复测流传,量化精度、上下文长度这些决定数字的条件同样没有披露。 政策面今年5月的官方表述也只是“指导国产大模型加大力度适配国产算力芯片”——“适配”意味着过了兼容的门槛,把它外推成体验达标,是这批宣传共同的修辞手法。知乎
所以看到“本地千亿”,先要齐五件事再说:总参数多少、激活参数多少、量化几bit、运行时峰值内存多少、稳态tokens/s和首token延迟由谁在什么条件下复测。这五项缺任何一项,数字参考价值都要打折——模型的总参数量,已经无法直接等同于部署时的内存门槛,这句话值得贴在每台AI PC的产品页上。36氪
回到消费决策:冲着“千亿”买46999元的192GB旗舰版,你大概率买到的是十几tokens/s的生成、两秒级的首字,和一个激活规模远小于宣传数字的模型;本地化省下的API开销,多半已经预付进了硬件账单。“千亿落地国产PC”目前的准确表述是:硬件刚刚够到门槛,性能尚未兑现。30B级量化模型倒是先到了“可用区”,等各家独立实测攒够,再按自己的使用场景决定是否为“千亿”标签买单也不迟。