「超GPT-6」这句话有具体出处,但不是一句可以无限延展的结论。10月24日凌晨,月之暗面发布了迄今能力最强的 3 万亿级参数模型 Kimi K3.1 Pro,支持 100 万 token 上下文。在考察编程智能体真实终端任务能力的 Terminal-Bench 4.0 中,官方成绩单显示 K3.1 Pro 得分 65.7%,超过 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 仅有微弱差距。但在第三方机构 Artificial Analysis 的综合智能指数里,它以 55 分排名全球第四,前面还压着两个 Claude 和一个未开放 API 的模型。也就是说:它在最能兑现“写小游戏”这件事的编程与 Agent 赛道上确实超过了 GPT-6,而不是全面反超。至于真香还是噱头,这两天社区“一句话让它做个小游戏”的实测,把两边都摆得挺清楚。央视财经知乎DeepTech深科技
一句话写小游戏:能跑通、会自查,但“一次出片”仍是错觉
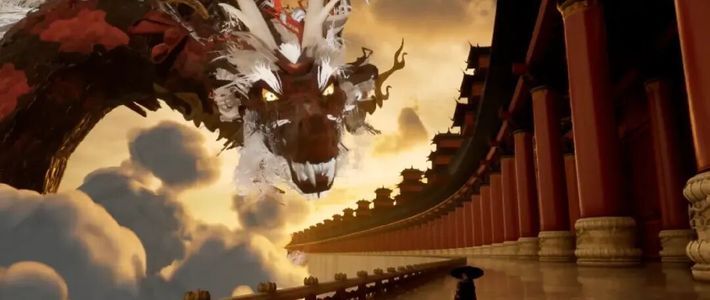
官方这次宣传的主角就是游戏。除了用虚幻引擎 5.8 搭建云海天宫场景,它在另一个案例中从零构建完整游戏工程。从探索区域、Boss 战到昼夜循环和快速传送,都由模型自己写出来。游戏开发者圈子的复刻热情也很高——B站上有人用一句提示词生成了可玩的 3D 跑酷游戏,从建模、写代码到自查 bug 全程没人插手,成品直接挂了在线体验链接。也有完全文科背景的三人小组,用 K3.1 Pro 加 Blender 和虚幻引擎组队搓出了游戏 demo。36氪哔哩哔哩小红书
能跑通、bug 少、会自己 debug,是这批实测里最常见的正面评价。泼冷水的证据同样具体:流传最广的“鹈鹕骑自行车”3D 测试里,一位游戏开发者复刻后发现它并不是一次提示词就给出最终结果,而是需要多轮追加指令才逼近完整版,换成 Claude Opus 5.5 一次提示词就能拿到更完整的成品。还有观众逐帧对比后说“跟宣传差距有点大”。同题不同命,评论区里“神区二相性”的调侃与失望同时存在。36氪哔哩哔哩哔哩哔哩
换一套尺子就是另一张表:跑分是真的,边界也是真的
“超GPT-6”的传播里,数字口径的松散程度比分数本身更值得注意。同样是 Terminal-Bench 4.0,Artificial Analysis 独立复现时给出了 67.2%,并认定这是所有模型里的最高分。官方口径的 65.7% 与第三方口径的 67.2%,对手集合、重试策略、测试框架都不相同,0.7 分的排序精确但不牢靠,前提得是大家都在同一套框架里比。知乎知乎
把尺子拉满看全貌,K3.1 Pro 的“偏科”很明显:知识推理与科学计算类只小幅提升,提升幅度明显小于 Agent 类指标。在测 3D 重建的 BenchCAD 中它带工具拿到 92.7%,而在科学计算、部分知识推理和 3D 重建测试里,GPT-6 Astra 和 Claude Opus 5.5 仍保持优势。在真人盲投的 Arena WebDev 榜上,它从 K3 的第 17 名跳到第 8 名,是明显的进步,但离最头部仍有肉眼可见的距离。反过来,官方主推的长程任务才是这代模型真正的增量区——人体行走仿真案例里,它经历 167 项任务、420 次独立评审,调不动手臂时回头查出模拟器里 36 处肩部力臂计算错误再重训,最后让原本几秒就摔倒的虚拟人连续走了 11.2 秒。36氪DeepTech深科技知乎
两本账:API 单价降了三分之一,额度墙与“开源”还悬着
K3.1 Pro 的 API 定价是每百万 token 输入 13 元、命中缓存 1.3 元、输出 68 元,比上代 K3 降约三分之一;同步上线的高速版输出快 2 到 3 倍,价格翻倍。但用量结构变了:它在相同评测中的输出量比参与评测模型的中位水平高出一大截,被 Artificial Analysis 直接评价为“非常冗长”。实测输出速度约每秒 73.5 个 token,也低于同类模型的平均水平。知乎36氪DeepTech深科技
两项抵消后,完成一项智能评测的平均成本约 2.11 美元,依然只有 Claude Opus 5.5 的三分之一左右、GPT-6 Astra 的三分之二。单价降了、单任务成本没涨,这本账其实不亏。36氪
真正扎心的是订阅侧:有 99 美元套餐用户报告,一个普通会话大约 47 分钟就触发了 5 小时额度限制。B站作者的直观记录更狠:拉满思考档和高速版跑一个任务,就蹬掉了近九个百分点的月度用量。36氪哔哩哔哩
另一件悬着的是“开源”二字的状态。官方公告写得很清楚,完整模型权重将于 11 月 4 日前发布。但许可证尚未公布,在此之前,它更准确的身份是一个可用、不可本地部署也无法独立验证的闭源服务,“最强开源模型”目前是将来时。知乎知乎
发布材料里还有一个容易被漏掉的细节:月之暗面主动披露在中期训练和强化学习阶段删除了网络安全攻防数据,最终发布版在漏洞利用测试 xdev-bench-hard 上比未削减的检查点低了 9.5 个百分点。开源模型主动贴出自己“削弱了什么”和削弱前后的分数,这确实是头一回。知乎
回到标题那个问题:说“超GPT-6”是噱头,忽略了它在编程 Agent 基准上被官方自测和独立复现分别确认过的真实领先;说全面真香,又对 WebDev 盲投第 8、3D 重建落后、订阅额度焦虑这些事实不公平。眼下最靠得住的判断方式,恰恰是社区正在做的这件事:拿你自己的活去测。做前端、搓 3D、跑长程编码任务,它是当下最划算的国产选项之一;指望一次提示词出一个能直接发布的成品,它还不是那个答案。11 月 4 日权重落地、独立复现跑起来之后,这些跑分才会迎来第一次真正的检验。