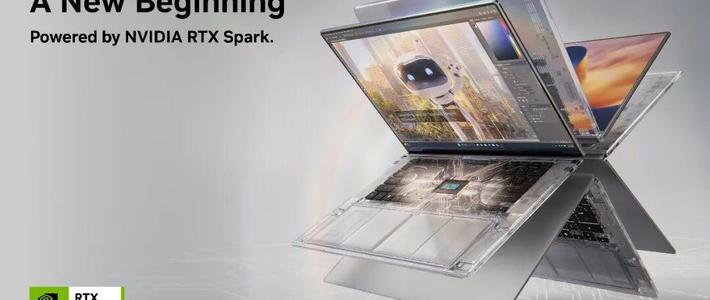
10 月 15 日,搭载英伟达 RTX Spark 芯片的首批终端深度评测集中放出,"消费级电脑本地跑大模型"第一次变成了可查证的实测数字。而就在 10 月 8 日,华硕、微软、戴尔、惠普、联想、微星六家厂商的首发机型同步开启预售,10 月 16 日陆续发货。首批实测给出的答案是:统一内存确实把"模型装不进笔记本"这块天花板掀掉了——27B 级模型可以边跑智能体任务边从容对话,AI 出图 1.64 秒一张;但"本地跑 1200 亿参数"只对 128GB 顶配成立,消费级普及真正卡住的地方,已经从算力换成了价格阶梯、内存带宽和 Arm 生态这三道门槛。知乎
128GB 统一内存实测:装得下,也跑得动
RTX Spark 的初代芯片 N1X 由英伟达和联发科合作设计,台积电 3 纳米工艺,把 20 核 Arm 架构的 Grace CPU 和 Blackwell 架构的 RTX GPU(高配 6144 个 CUDA 核心)集成在一颗芯片上,两者共用一块最高 128GB 的统一内存池,不再区分"显存"和"内存"。GPU 能分到多少内存,在 NVIDIA App 里用滑块设置,最高 96GB 划给 GPU 当作显存用。微软还在 128GB 机型上做过演示:任务管理器显示约 110GB 可供 GPU 寻址,其中 79.9GB 列为独显内存。知乎专栏知乎知乎
首批实测里最有信息量的是智能体负载。联想 YOGA Pro 15(6144 核/128GB 版)用 Qwen3.8-27B 跑 Artificial Analysis 的 AgentPerf Local 基准——这是一套回放真实编程与协作对话、总输入超 200 万 token 的开源测试。在这台机器上,168 轮对话的高负荷压榨下,最后完成时间约为 20 分钟,解码输出速度约 34.39 Tokens/秒。知乎
同一批测试还给出了这代芯片的日常成色:出图在 1024x1024 分辨率下平均 1.64 秒一张、每分钟约 36 张;轻量模型 PHI 3.5 平均首字延迟 0.27 秒、输出高达 73.45 tokens/s;用无代码工具给 Qwen3.5-9B 做 3 轮 LoRA 微调,全程大约 3 分 40 秒。这些数字背后是一笔容量账:一个 27B~32B 稠密模型 FP16 权重就要约 50GB,加上长上下文 KV Cache 很快逼近 60~80GB——传统消费级独显那点显存装不下,这正是过去"本地大模型"只能待在工作站和云端的原因。知乎
图形侧也能对上现有硬件坐标系:3DMark Steel Nomad 得分 3010,略超 RTX 5070 笔记本 GPU;Blender Cycles 中小场景基本持平桌面 RTX 5070,只有高负载的 Monster 场景受带宽拖累落后;1440p 最高画质加最高光追、配合 DLSS,多款 3A 大作实现或接近 100+fps 的帧率表现,1080p 下所选八款游戏全部破百。一台 16.7mm、约 1.75kg 的笔记本做到这一步,说明 Blackwell 第五代 Tensor Core 和 NVFP4 低精度加速是实打实的——代价则是 CPU 和 GPU 共享同一块内存带宽,混合重负载下会先摸到吞吐上限。知乎
官方口径与实测之间:哪些数字要打折扣
"本地跑 1200 亿参数"这句官方话术,只写给 128GB 顶配,举的例子是 125B 参数的 Qwen 3.8 Flash Next,24GB、32GB 的入门机型根本装不下。"128GB 全给模型"也不成立:微软自己公布的数据里,137B 总参数、6.8B 激活参数的 MoE 代码模型 MAI Code 1.1 Flash 量化后占 53GB,在 256k 上下文下峰值内存仍达 75.5GB,系统和运行时都要从同一个池子里扣。知乎知乎专栏
被广泛引用的宣传数字同样需要限定条件。"对比 16 英寸 M5 Pro 版 MacBook Pro,首 token 时延效率 2.1 倍、AI 图像生成 4.3 倍、AI 视频生成 6.2 倍"来自英伟达自测,基准条件未公布。媒体普遍引用的约 300GB/s 内存峰值带宽,英伟达官方资料中并未确认。知乎知乎
还有一层不确定性在量产机上:此前流出的工程样机测试里,出现过开发版驱动不稳定、CUDA 路径未跑通、Arm CPU 满载接近 100℃ 的情况,这些问题是否已在量产版解决,要等 10 月 16 日发货后的第一批第三方长期实测收口。知乎
价格阶梯:谁先拿到普及的第一张票
这轮预售把消费级"本地 AI 整机"的价格坐标系一次性立住了。Surface Laptop Ultra 起售价 2599 美元,128GB+1TB 顶配 5899.99 美元。国行方面,微软笔记本起售 21,988 元,明显高于按汇率折算的美版,差额主要来自税费。联想 YOGA Pro 15 的 128GB 版参考价为 42,999 元,微软迷你开发机国行合 40,200 元、对应美版 5999 美元档位。知乎专栏知乎知乎
对照之下更有意思:去年以 3999 美元发布的 Linux 版"火柴盒超算"DGX Spark 一路涨价,64GB 新报价 4999 美元、128GB 版涨到 6950 美元。同一方向的硅,Windows 消费版上市价反而更低,还附带游戏和创作能力——这个倒挂本身就是普及信号。知乎专栏
涨价根源在上游:128GB DDR5 5600 内存条市价已冲到约 1.4 万元,大容量统一内存想便宜很难。所以"普及"的第一步不会是人人买得起,而是先落进明确人群:要长期本地跑大模型、需要数据不出本地的开发者和创作者;评测也直言,普通游戏玩家没有强 AI 需求的话,同价位游戏本仍是更优解。知乎
趋势的变量:带宽短板正被软件绕开,生态在补课
统一内存架构公认的死穴是带宽——几十 GB/s 的共享带宽伺候不了高吞吐逐 token 生成,早年按 FP8 粗算,DGX Spark 跑 27B 模型只能得到约 10 Tokens/s 的尴尬数字。但这个判断正在被两类软件进展松动:一类是 Flash 系 MoE 模型,激活参数小、对带宽依赖低;二是社区推理引擎,比如 TensorFold 已让 DGX Spark 单机跑 Qwen 3.8 27B 的普通文本解码达到每秒 58.3 token,编码模式 136.9 token,首字延迟 0.1 秒。同样的引擎与 NVFP4、投机解码会平移到 RTX Spark 上,意味着"装得下"之后,"跑得快"也在逐月兑现——不过这条路径的证据目前全在 Linux 版 DGX Spark 上,RTX Spark 的同类实测还要等量产机。知乎
生态是另一场补课。RTX Spark 跑 Arm 架构 Windows,x86 程序靠 Prism 转译,但 GPU 代码无需转译、直接在本地执行,CUDA 生态与数据中心和 GeForce 同源,现成框架可平滑迁移——相比高通 Snapdragon 阵营,这正是英伟达最大的底气。但 Windows on Arm 目前验证应用约 7000 款,距离"无感兼容"还有距离;实测里 GPU-Z 等个别 x64 工具仍然跑不起来。竞争也会替它把门槛磨低:AMD 的 Ryzen AI Max+395 走的是 x86 统一内存的同一条路,社区里两家"都是统一内存、一个 Arm 一个 x86"的对比早已吵开。知乎专栏知乎新浪微博
所以 RTX Spark 首批实测对"普及趋势"的读数很清晰:容量之门已被实测踹开,价格、带宽、兼容三道门槛决定了接下来两年谁能走进来。值得盯的观察点有三个——10 月 16 日后量产机的第三方长测成绩,24~32GB 入门档的国行实际到手价,以及下一批低激活参数模型会不会把 32GB 机型也拉进"本地 AI 可用"的范围。