10月20日,DeepSeek把自家最不愿外传的“后厨”端了出来:内部大规模推理框架DeepInfer全面开源,Token编解码组件deepseek-recipe一起给,许可证是Apache 2.0。模型权重早就开源了,这次开的是“模型怎么跑得起、跑得便宜”的那一层。36氪GitHub
最抓眼球的是账本:基于DeepInfer,V4.1 Flash单集群日吞吐达到155万亿Token;按谷电价算,每卡每小时收入38美元。数字一出,社交平台上有人直接喊出“DeepSeek才是真正的OpenAI”。36氪第一财经小红书
但先别把38美元当成利润。官方口径是“收入”,不是毛利,而且还是按谷电价算的;它没把训练成本、闲置算力和电价波动算进去。它更像一张“满级账号的成绩单”,不是谁照着抄就能复现的日常。第一财经

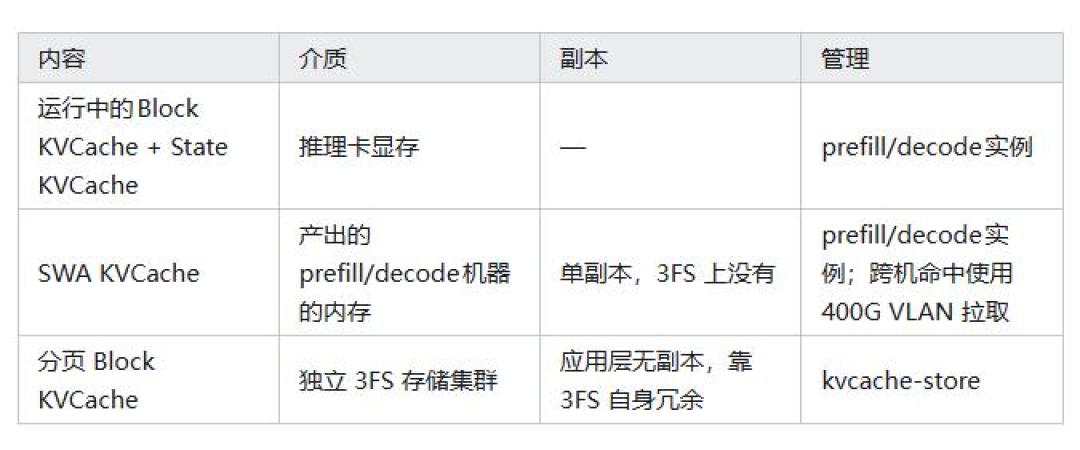
这套系统确实有硬功夫。生产集群里,Prefill和Decode分开部署,8卡机器负责预填充,64到128卡超节点负责解码;Agent流量的KVCache保留3天,聊天机器人留7天;3FS缓存池约100PiB;SWA缓存只在内存里留180秒,命中率却超过98%;投机解码采用变长验证,吞吐还能再提6%。36氪
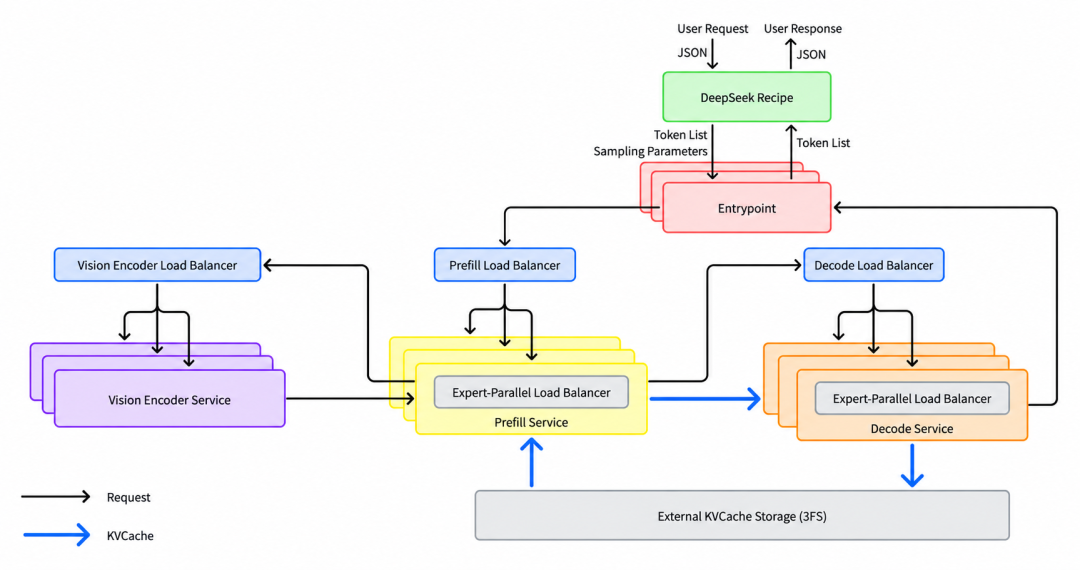
可开源也有边界。这次放出来的是核心推理引擎和工程经验;要搭完整的在线服务,KV缓存系统、推理阶段分离部署、跨副本负载均衡仍要自己补。官方性能基准是在4张SM100上跑预填充、64张上跑解码。个人开发者拿几张卡跑离线推理可以,想替掉官方API,基本不现实。第一财经GitHub
这恰好解释了DeepSeek为什么敢开源。今年10月15日,它的网页和APP曾“服务器暂时不可用”近5个小时;有媒体粗略统计,DeepSeek今年至少宕机18次。用户不会等机房建好再来调用,把推理框架开源,让云厂商和企业自己部署DeepSeek模型,等于把一部分流量压力分出去,也把“怎么跑”变成行业标准。蓝字计划
它并不缺钱:第二轮融资约1000亿元,投前估值约5000亿元,内蒙古数据中心计划部署至少16万枚华为高端AI加速器。独角兽早知道
更微妙的是,DeepSeek的API业务其实很赚钱:2026年前七个月,API毛利率高达82.9%,综合毛利率44.6%,但仍净亏损约7.15亿元。因为七成以上算力拿去做训练,留给推理的不足三成。36氪
对普通用户,最实际的变化不是“赶紧自建”,而是接下来用DeepSeek可能更便宜、更快,选择也更多。真正值得盯的,是那三块没开源的组件什么时候补齐,以及昇腾平台上的部署能不能跑顺。38美元的账本很好看,但它是DeepSeek的满分卷;抄作业之前,先看看自己有没有上百张卡。