
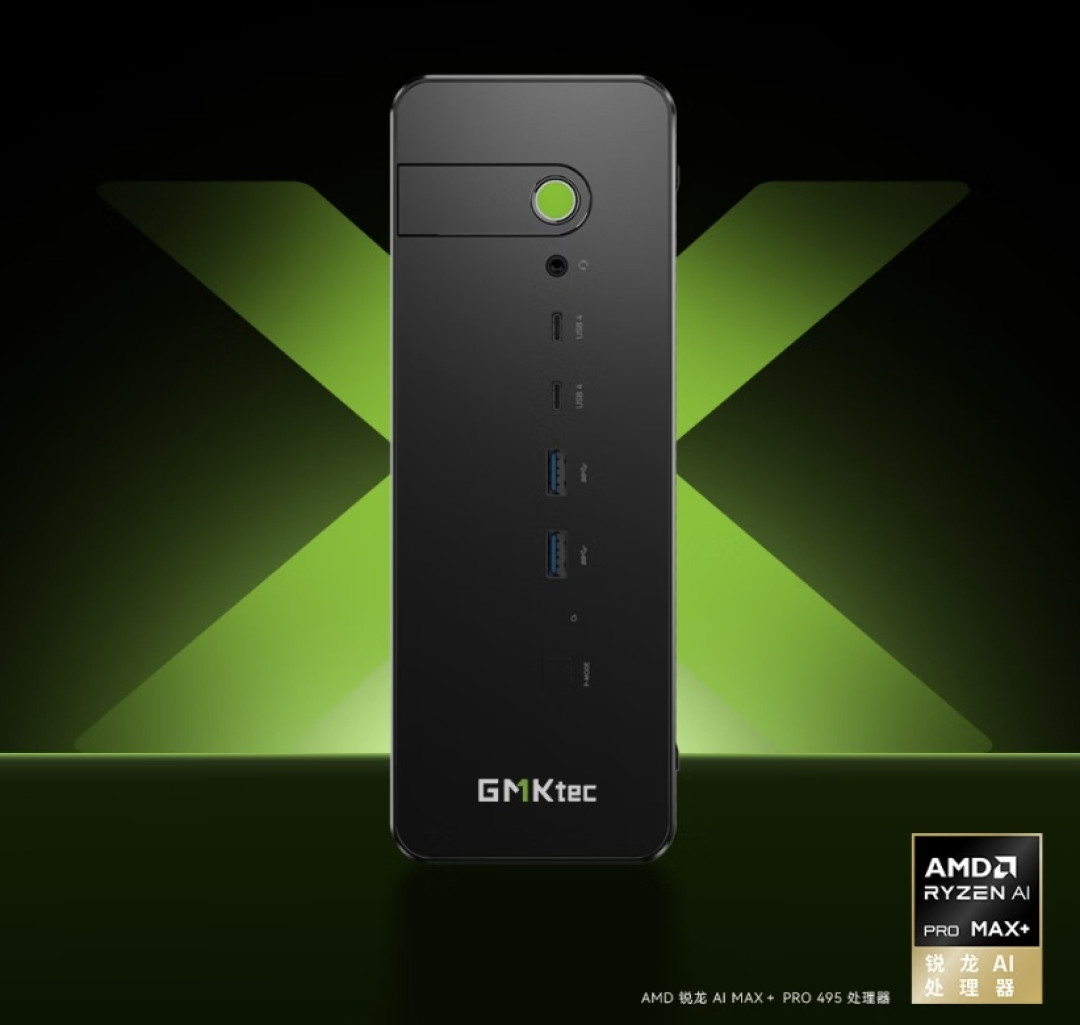
10月10日,至顶AI实验室放出了AMD锐龙AI Max+ PRO 495跑DeepSeek的国内首测。机器是极摩客刚开卖的EVO-X5 Pro,192GB统一内存,整机46999元。哔哩哔哩微博
哪派对?先看实测,再算账。
实测:能跑,还挺顺
Q4量化的DeepSeek V4-Flash,llama.cpp部署:启动约1分钟,显存占用130GB,生成速度每秒17个token,首字延迟2.1秒;开启DSpark投机解码后提到每秒27个token,提速约60%。作为对照,Qwen3.8 Flash Next加草稿模型能跑到每秒34个token、首字1.4秒。哔哩哔哩
每秒17个token什么概念?比你扫字幕还快,聊天、写代码、挂Agent都完全够用。而130GB的占用也解释了为什么必须192GB内存起步——128GB的机器连入场资格都没有。

但注意:跑的是"上一代"
9月10日DeepSeek正式发布V4.1 Flash:552B参数的MoE,公开口径是速度暴涨3倍、价格降90%。老V4 Flash的API也已下线,官方deepseek-flash名称已改指新模型。那本地开源权重这边呢?192GB迷你主机塞得下的,只有上一代V4-Flash的Q4量化。想本地跑V4.1 Flash,目前的公开玩法是双DGX Spark,到手的人实测优化后"99%的活都丢给它"。另一条路是服务器:EPYC插1TB内存配双3090,跑出30+ token/s。都不是迷你主机的回合。知乎微博知乎哔哩哔哩哔哩哔哩

换句话说:这46999元,买到的是"上一代模型"的本地运行权。预算党倒是有条野路子,有人用2080Ti加156GB内存的缝合机把V4-Flash跑到每秒40个token,成本零头都不到。哔哩哔哩
回本账:别抱期待
按本地党最理想的剧本算:每秒27个token、24小时连轴转、一刻不歇,一个月输出约7000万token。对照的标尺是V4-Flash官方输出价:每百万token两元。折算下来,上述token的API价值约140元/月。46999÷140≈336个月,28年——这还没算电费和内存涨价。知乎
有人会抬杠:矿卡服务器不是12个月就回本了吗?对,但看看人家怎么跑的:4张CMP 170HX,短提示稳态解码10并发压到每秒518.5个token,按每天2000次重度调用算,API要花126元/天,电费只要4元/天,硬件投入约12个月回本。回本的钥匙是并发吞吐,不是单机速度。迷你主机单流27 token/s,撑不起这个量级。哔哩哔哩

更扎心的是,缓存命中价已经跌到一毛级。API越便宜,本地的回本周期反而越长。知乎
所以谁该买?
三类人值得掏钱:数据不能出内网的企业用户、要离线调试Agent应用的开发者、以及真享受折腾部署过程的极客。对他们来说,46999元买的不是省钱,是控制权。
而如果你只是想省订阅费,说句实话:API才是你的token自由。28年的回本周期,够你换三代新机器了。











