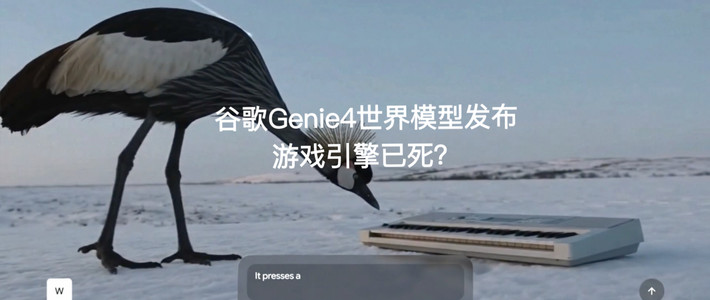
北京时间10月28日凌晨(美东时间27日),谷歌发布了新一代人工智能世界模型Genie 4。 官方称其为「迄今为止最逼真、交互性最强的世界模型」,与此前只能观看的AI视频不同,用户既能用键盘控制角色和镜头在生成的世界里移动,还能随时输入自然语言改变天气、添加物体、引入新角色,观察整个场景如何随之变化。 不过入口目前很窄,它以研究预览版形式向少量经过筛选的测试者开放,未来才逐步向AI Ultra订阅用户和部分开发者推出。微博知乎微博
这类游戏demo,普通人玩出来的答案不是"画质追没追上3A",而是模型能不能实时运行一个世界:按键之后画面跟不跟得上,转过身去它还记不记得你,东西掉下去摔得合不合理,声音跟不跟得上剧情——这四件事只有进了游戏才会现形,也正是世界模型和文生视频的分水岭。这一代交出的分数是,模拟场景最长可以持续两分钟,约为上一代Genie 3的两倍。 但官方这次给的硬数字少得可怜:分辨率、帧率、延迟、价格一个都没说——够验证一个想法,不够做一款游戏。知乎知乎
发布会的考题集体换成游戏,因为榜单装不下真本事
世界模型是一类能够模拟环境及其变化的人工智能模型。 而一个"可玩"的游戏demo,恰好把实时渲染、空间记忆、物理规则、音画同步、指令跟随同时压上台面——哪一环断了,玩家第一眼就能看见,这是任何文字榜单都伪装不出来的。微博
今年10月,这条赛道的发布节奏几乎排满了。15日,昆仑万维上线Matrix-Game 4.0,官方的新范式是由游戏引擎维护世界状态与交互规则,由视频生成模型实时呈现精细画面。 22日,GitHub冒出挂着米哈游、清华等多方名字的开源项目"Scaling in Games",经核实这大概率是崩坏项目AI团队的几位实习生联合发布的研究成果,论文也只是未经同行评议的预印本。 24日,Kimi K3.1上线,官方说明它针对3D建模、游戏、金融分析这些特定领域的任务和场景做了进一步的后训练。知乎36氪微博
更早的时候,"做出游戏"就是文本模型的通用考题:有人用1条提示词,让Opus 5一次性写出一款带完整倒计时、圈数和排名系统的水上快艇竞速游戏,烧掉6.9亿token、约423美元。36氪
另一位网友随后用GPT-5.6 Sol复刻出同款,只花了5美元——虽然那是订阅额度的折算而非独立账单,两份成品的完成度差距也一眼可见,但"能不能做出一个工程上站得住的游戏",已经成了新模型发布时最直观的自我介绍。36氪
游戏还测出了文字榜单量不出的短板。Scaling in Games实验发现,有些大模型只需学习50小时的游戏数据,成绩就超过了学习1600小时的小模型。36氪
可一旦游戏持续运行,慢半拍的操作就可能错过最佳时机,"脑子"跟得上的大型通用模型,"手速"反而输给专门训练的小模型。 响应延迟这种要命的短板,只有游戏这种不给模型"暂停思考"机会的场景才测得出来。36氪
拿到demo的普通人,实际是在做六项体检
第一测反应速度:从按下键到画面作出响应,要等多久。Genie 4没公布这个数,昆仑万维的对比表给出了行业标尺——学术方案动辄秒级,112毫秒才第一次落进"实时可玩"的区间。 百毫秒级才配叫游戏,秒级只是幻灯片。知乎
第二测记性:推开一扇门,转身离开30秒再走回来,那扇门是否依然开着——官方把这种空间记忆当成视频模型与世界模型的分水岭。 但测试记录里的反面细节同样具体:Genie 4里的虚拟人,其实转个身就会把自己的脸给忘掉。知乎小红书
第三测物理:推一下桌上的东西看它怎么摔,盯一颗枫树种子旋转着落下。Google表示,Genie 4改进了对空气动力学、碰撞等物理现象的模拟,尤其提升了人物运动的自然程度。 复杂物理交互、空间精度和场景里可读的文字,则还留在官方待改进的清单上。知乎
第四测听觉:Genie 3的世界是静音的,Genie 4相比上一代增加了同步生成环境声音及互动对话的能力,风声、配乐、人物即兴对白都随画面一起生成。 但海外社区的实测讨论直言,语音仍然是最薄弱的环节,听起来甚至有些像老式的文本转语音——“能出声"和"出声自然”,中间还隔着一代模型的距离。微博知乎
第五测听话:真正的增量是"边玩边改"——用户可以在模拟运行的过程中输入提示词来修改场景,换天气、挪镜头、加角色,世界不停下重来。 更细的观察是"到底谁在玩":部分演示里角色的运动更像模型自主决定,键盘方向控制似乎并不那么直接,所谓操控感和demo观感之间还有缝隙。 拿它测手感时,不妨先确认自己是不是真的在"操纵"。微博知乎
第六测时间:挑一个复杂场景从头跑到尾,掐表看它什么时候开始"忘事"。Genie 3的场景稳住1分钟就算到头,Genie 4按简报说法能到2分钟左右。 DeepMind也没把话说满:模拟运行时间较长、经过多次复杂的提示词修改或持续探索移动时,视觉细节和物体的持续存在性仍会发生变化或偏移。 两分钟既是这一代的进度条,也是它此刻的寿命。知乎知乎
B站评论区有一句话说得挺准:一个能自己走、能改天气的世界,只活两分钟,“有点替它舍不得”。哔哩哔哩
demo能证明方向,证明不了产品
先说能证明的:路线。谷歌把这个技术方向称为混合世界模型——Gemini负责逻辑推理、任务规划和事件组织,Genie负责生成世界的视觉、声音和动态反馈。 昆仑万维把"谁说了算"写得更直白:现有路线把"世界"寄存在模型的记忆里,而游戏需要的,是一个可以被读取、被修改、被验证的世界。 两条路线殊途同归:规则交还给代码,呈现交给模型。知乎知乎
再说证明不了的:产品。普通用户要排进最贵的那档AI Ultra订阅,起价每月一百美元,还要排等待名单。 海外社区最直接的诉求,是官方别只发精心挑选的片段,放一场接受观众随机要求、不加筛选的直播,看看模型在没有提前筛选的情况下究竟能表现得怎么样。 还有成本——有财经分析把"只做限量预览、不开放商用"归因于推理成本远高于普通大语言模型,谷歌未证实这一说法。知乎知乎知乎
行业的定位判断趋于一致:对游戏开发,它改的是原型阶段的成本结构,不是引擎本身。 几分钟的一致性够验证一段手感、镜头和氛围,够不上验证一个关卡的节奏设计;谷歌自己列出的早期用途——影视预演、历史场景重建、游戏原型制作、工业模拟——也全是"验证"性质,没有一个是"成品"。知乎知乎
真正的重头戏反而在机器人:演示里,Gemini 4 Argon与Genie 4合作,模拟了Apptronik Apollo人形机器人下国际跳棋的过程——先在假世界里摔够跟头,再去碰真机器,模拟里摔一百次的账单和真机摔一次完全是两回事。 但边界同样清楚:环境供给一旦变便宜,瓶颈就整体挪到数据质量那一侧——两分钟的模拟撑不起需要成千上万次长时序交互的策略训练。知乎知乎
所以普通人玩这类demo,看的是它划出的那条及格线:延迟百毫秒、转身还记得、声音跟得上剧情、世界撑得住两分钟。四条全过,才谈得上"可玩的世界";缺一条,demo就只是发布会的布景。真想现在就上手,国产路线已经开了口子——Matrix-Game 4.0的代码、权重、白模同步开放,一张消费级显卡就能搭起自己的考场。 接下来值得盯三件事:分辨率、帧率、延迟这些硬数字何时公布;API与AI Studio的定价和使用条款何时落地;第三方对长时序稳定性的实测何时出现。它配得上"里程碑"三个字,取决于这三件事;至于配不配得上"时刻"——所谓"GPT时刻",成其为时刻从来不只因为演示惊艳,而是普通人当天就用得上。知乎