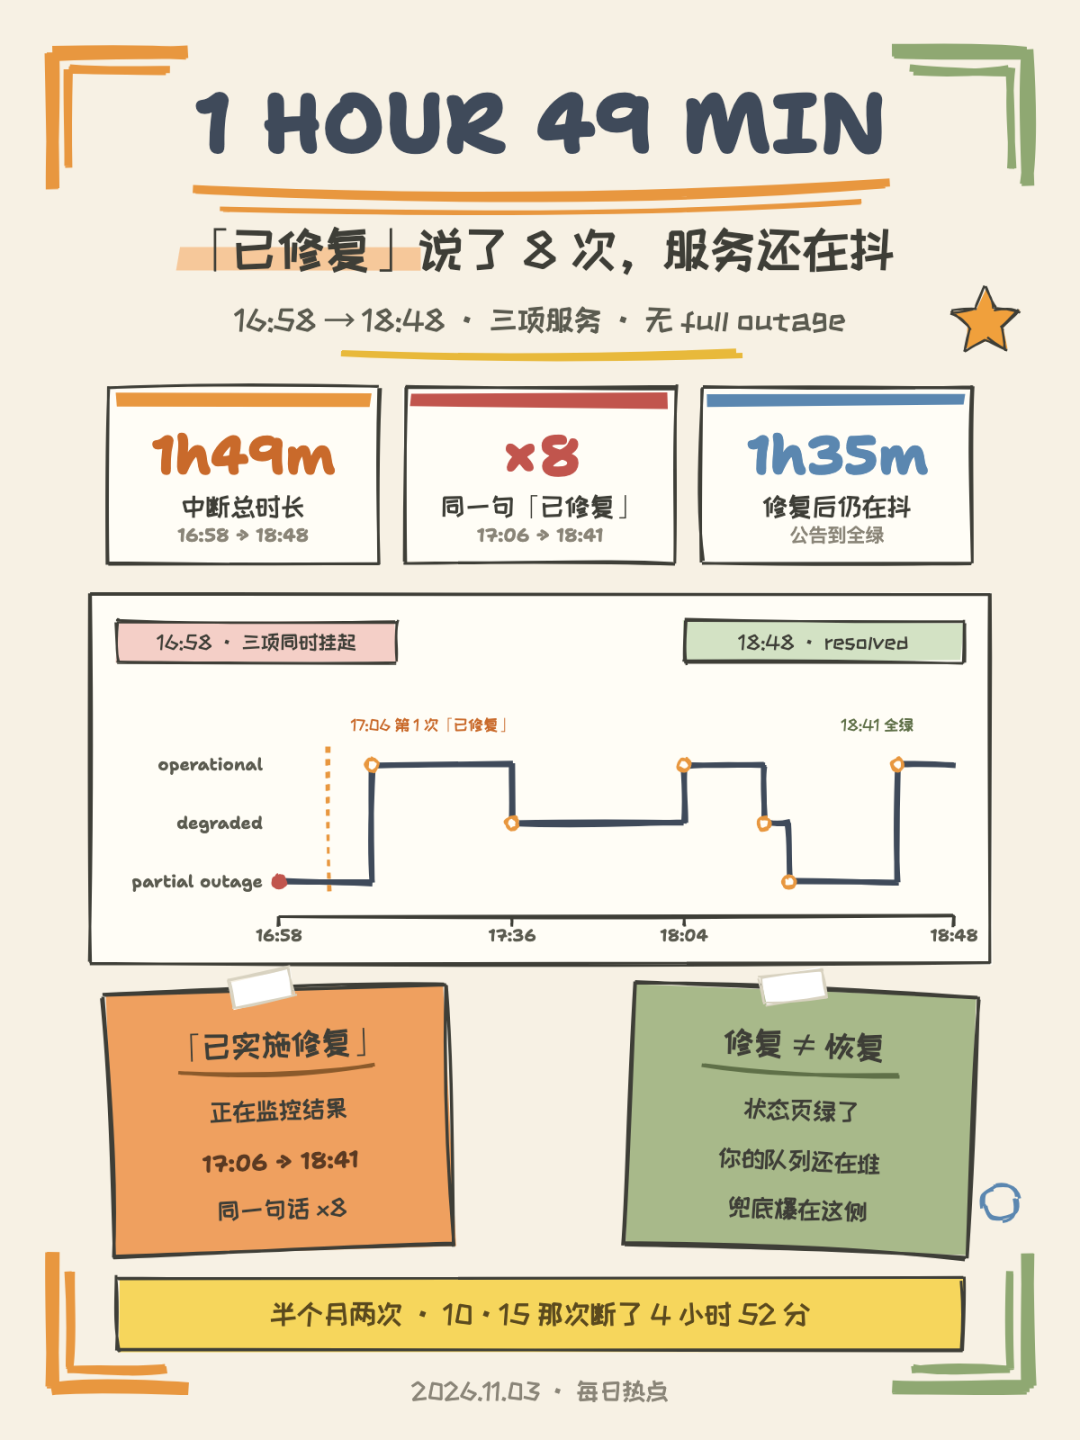
11月3日下午4点58分,DeepSeek又崩了。 网页、V4 Pro API、V4.1 Flash API一起挂,18:48标记修复,前后1小时49分钟。有媒体统计,这已是它今年至少第19次大面积异常。#DeepSeek崩了#冲上热搜,评论区却没多少人骂,高赞清一色在喊:“4.1 Pro来!token来!”——今年AI圈最魔幻的一次"催更"现场。知乎华尔街见闻
大家等一个新模型,同一天,产业链人士还传出一条更重的消息:DeepSeek下一代大模型V5,计划用华为昇腾芯片做预训练。 消息指向明年落地,截至发稿华为和DeepSeek均未正式确认,细节有待核实。但它之所以比发一个新模型还大,是因为踩中了整条产业链里最难的那一步:国内算力的角色正被从推理侧推向更具分量的训练侧,这被视为检验国产芯片生态能否支撑顶尖大模型全流程开发的一次关键尝试。微博半导体产业纵横
先捋时间线,昇腾和DeepSeek早不是"绯闻":
2025年春节DeepSeek爆火,华为除夕到大年初二紧急部署3000多张昇腾芯片救推理,任正非整个春节都在指挥应对流量海啸。半导体产业纵横
2026年4月V4发布后,DeepSeek官方API页面写了句大实话:受限于高端算力,V4-Pro吞吐有限,等昇腾950超节点批量上市,Pro价格会大幅下调。微博
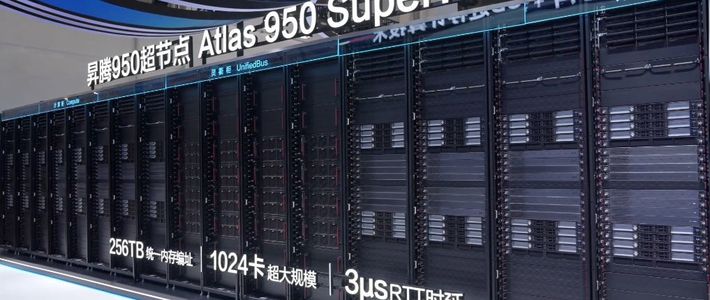
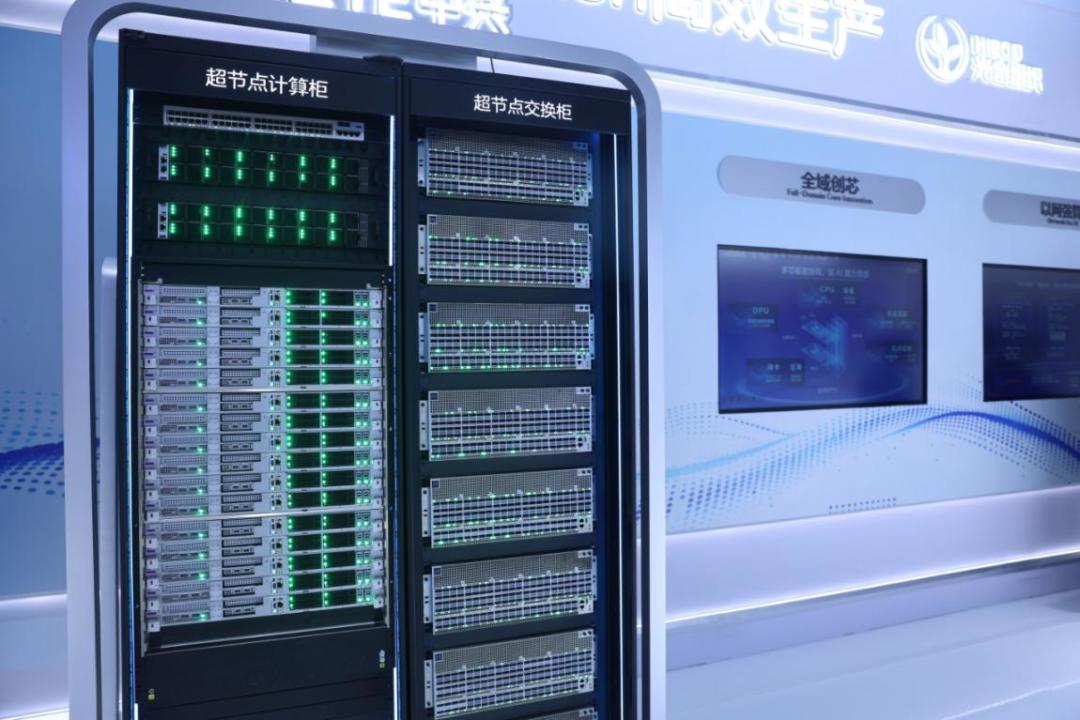
9月华为全联接大会上昇腾950超节点正式上市,9月30日智算集群服务在国内市场商用,随即950DT千卡超节点落地中国移动北京算力节点。界面新闻界面新闻
同样在9月底,DeepSeek把面向英伟达的开源组件"复刻"了一份给昇腾:TileLang编译器、计算库、通信库一一对应,DeepGEMM-Ascend连FP8/FP4和MegaMoE都支持。微博GitHub
10月中旬,华为CANN官方公开了基于950超节点的万亿参数MoE预训练参考实践。知乎
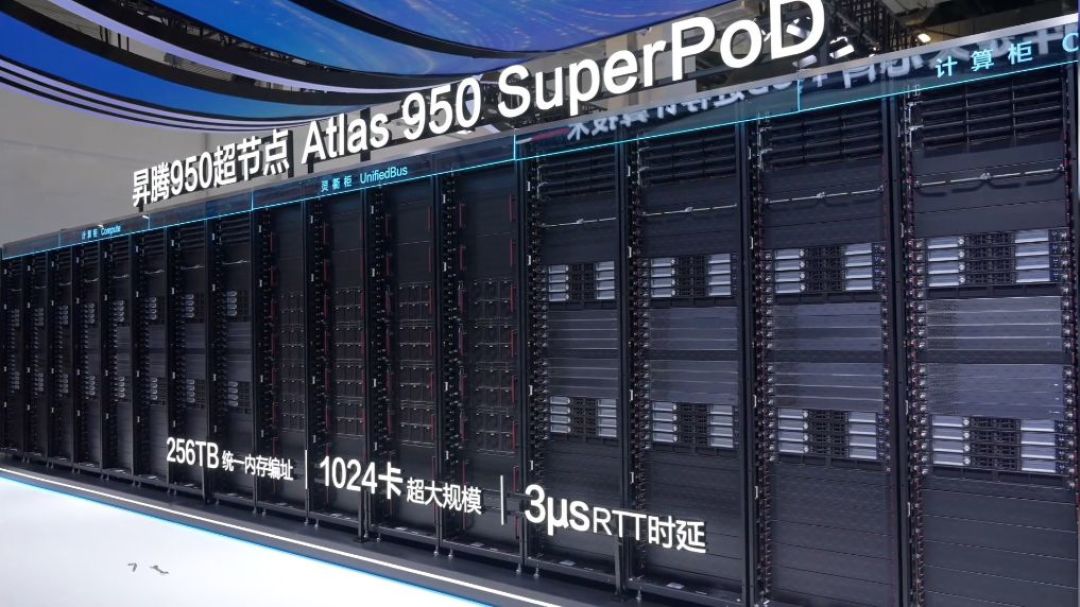
注意:这些还都停在推理侧和训练外围。预训练是"从零造车"那道工序——互联带宽、集群稳定性、通信库性能、编译器成熟度,哪一样都糊弄不了。如果V5真在昇腾上跑出来,等于第一次回答那个只有质疑、没有答案的问题:中国顶尖大模型,能不能全程用国产算力生出来。而刚拿下世界互联网大会领先科技奖的950超节点,正让这场针对国产算力生态的公开压力测试更早开跑。半导体产业纵横光明网
质疑也得摆上桌:一是参数传闻,网传V5约2万亿参数,且据称是其首个完全在华为昇腾芯片上训练的模型,难度指数级上升。有博主算了一笔账,称4张950才抵1张GB300。于是有从业者判断,2T以上参数的基模全量训练昇腾明年未必扛得住,大概率先出中型参数性价比版本。二是发布信号,10月27日网友发现DeepSeek换了大模型指纹,官方库中直接出现了V5代码。"快了"的猜测没停过,也有人担心V5不再开源,走OpenAI收紧的老路。目前这些都是推演。微博微博微博微博
回到普通人最关心的:换芯片,最先变的是价格。 950超节点已经商用放量,V4-Pro降价是DeepSeek官方自己许下的承诺;国产训练算力一旦真正接住大模型,token只有往下走的通道。这条看着只属于产业圈的消息,最后都会落到你的AI账单上。
眼下一切还是传闻。等华为和DeepSeek点头,等V5真跑出来——今年的AI十一月,瓜管够,悬念留到这儿。