







3
2
拆解了一下 LobeHub 架构,竟然和 Super-Agent 出奇一致
2026-11-05 17:42:05
1点赞
5收藏
0评论
点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
上一篇内容《通了个宵,终于把 Super-Agent 架构玩明白了》发出来之后,大家认可度比较高,同时也有不少小伙伴在**问到 DeepSeek Harness 的这套 Super-Agent 机制,有没有上手实现?
老实说这个问题我也挺感兴趣的,毕竟 Router/Worker、事件驱动、上下文管理、计算与环境分离,单拎出来讲理解起来不难,但要是串起来一起聊,难度还是有点大的。
于是我这两天我找了几个开源项目研究了一下,我发现 LobeHub 比较适配。
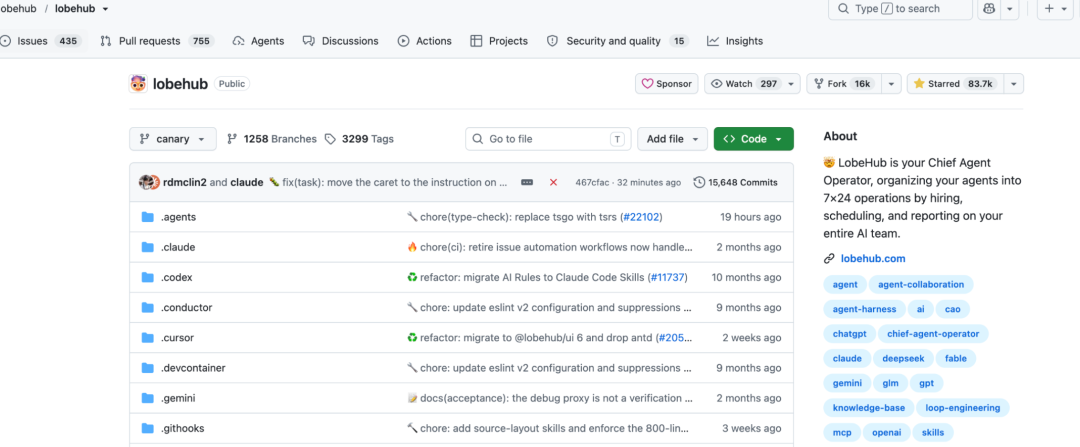
这是一个拥有 8 万多个 GitHub Stars 的开源项目,早期叫 LobeChat。
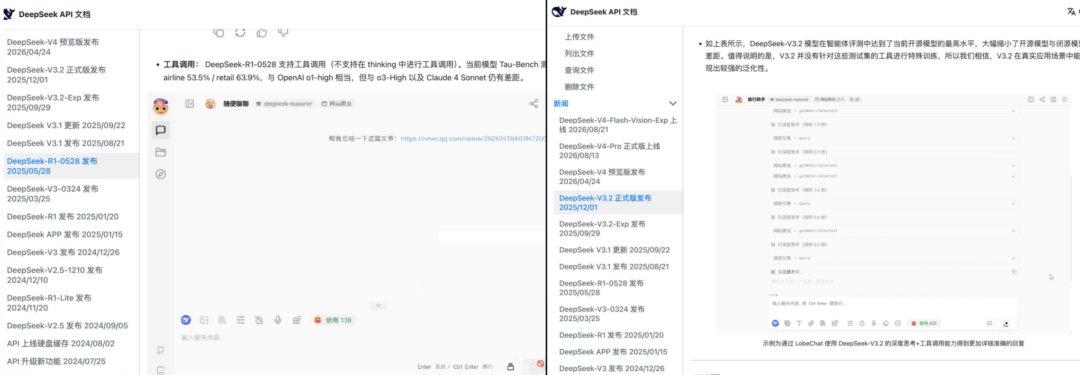
DeepSeek 在 V3 、R1 等重要版本发布的时候,就经常用 LobeHub 做演示。
现在 LobeHub 已经发展成了一个多 Agent 协作平台了。主管 Agent 可以安排任务,下面接入 Codex、Claude Code 等执行工具,再通过 Task、Goal 和 Workspace 管理长期工作。
更有意思的是,LobeHub 团队已经在用 LobeHub 开发 LobeHub 了。
他们的主管 Agent 会在团队聊天群里分派任务,专业 Agent 负责开发、测试、提交 PR,最后再由人来审查和验收。
于是我就想,既然他们已经这么用,我能不能自己也搭一套?
这次我直接拿了一个实际开发任务来测试:让 LobeHub 帮我做一款 Web 端 3D 游戏,名字叫《断电前 180 秒》。
要求也比较明确,玩家需要在限定时间内,从空间站不同区域找回能源芯,再返回逃生舱。
我让主管 Agent 负责规划,Codex 负责开发,另一个 Agent 负责游戏验收。
接下来,我们看看这几个 Agent 是怎么协作的,以及最终遇到了哪些问题。
我们先前情回顾一下 Super-Agent 架构的特点:
• Router/Worker 双层架构:常驻 Router 负责与用户沟通、分发任务给 Worker,而 Worker 负责具体任务的执行。
• 事件驱动与两级过滤:根据 Trigger 主动发现任务并执行任务,根据 Fast Path 和 Slow Path 做路由。
• 面向信道的输出:支持全双工通信,异步 ReAct 。
• 计算/状态/环境分离:存算分离,计算和状态分开,计算和环境分开。
• 上下文边界:划清上下文共享与隔离的边界。
大家可以基于这几个观点,来看一下后面的 LobeHub 的实际执行流程。
通过 LobeHub 看 Super-Agent
接下来,我们通过一个具体的任务来印证一下 LobeHub 是怎么玩的。
我布置了一个 Web 端的 3D 游戏《断电前 180 秒》,主要是让玩家在 180 秒内,将分散在空间站三个区域的能源芯,逐一搬回中央逃生舱,随后进入逃生舱获胜。
我的 LobeHub 主 Agent 叫 June ,我们可以 trajectory 一下它的链路流程。
Router 和 Worker
它拿到任务后会做任务拆分,创建开发 Agent ,随后再安排验收方。
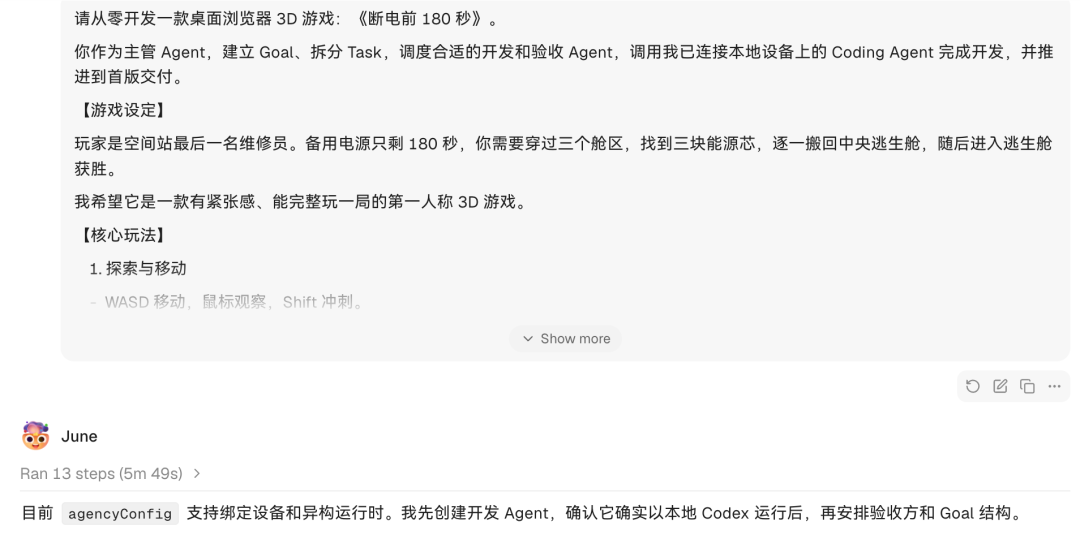
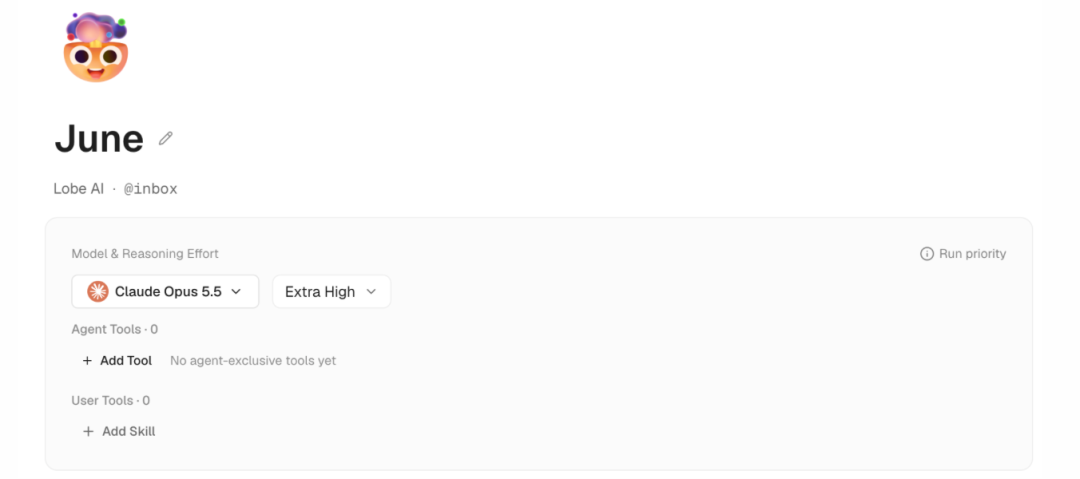
我们的 June 的模型是Opus 5.5 。
然后 June 安排了开发方和验收方,开发方是创建了一个 Codex 开发工程师,验收方是一个游戏验收工程师。
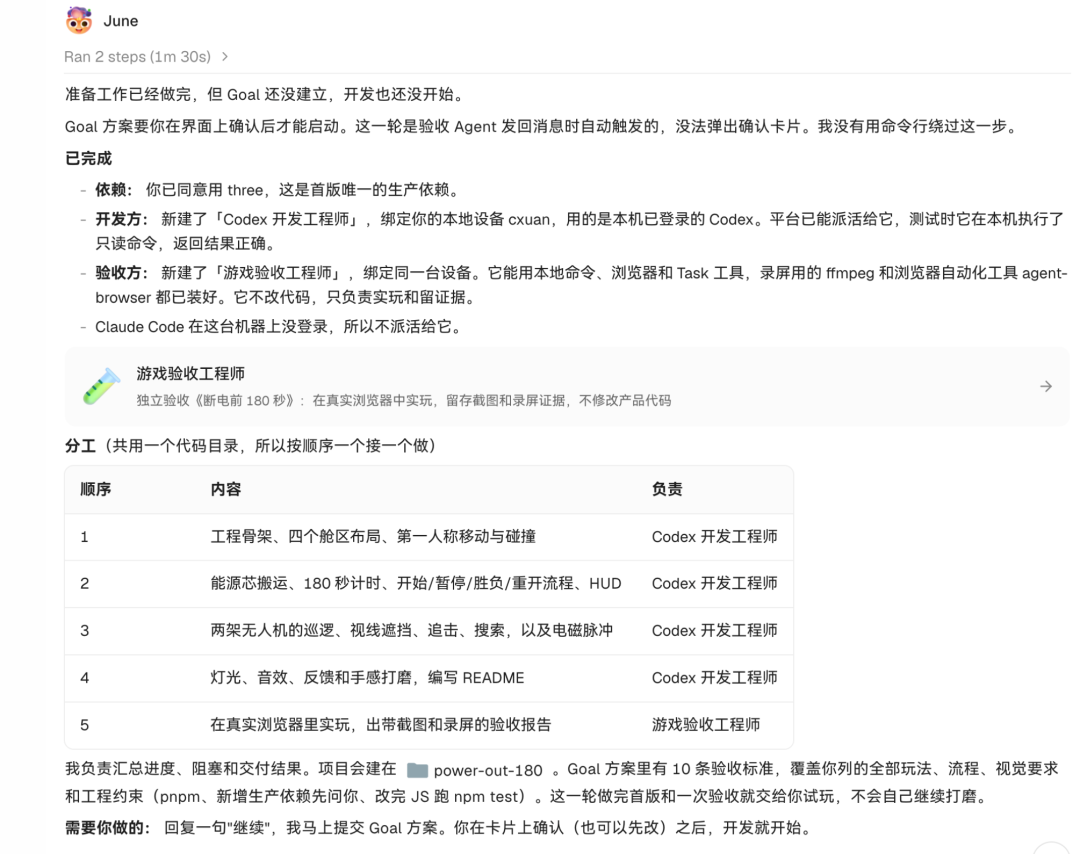
随后 June 把任务拆分为了几个步骤。
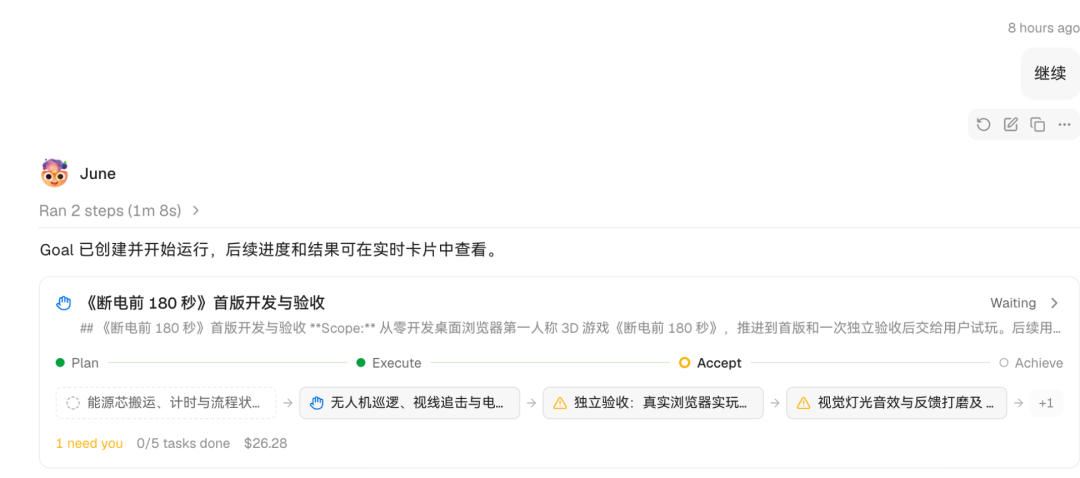
我们可以在 Codex 开发工程师的 Tasks 中看到对其分配的任务。
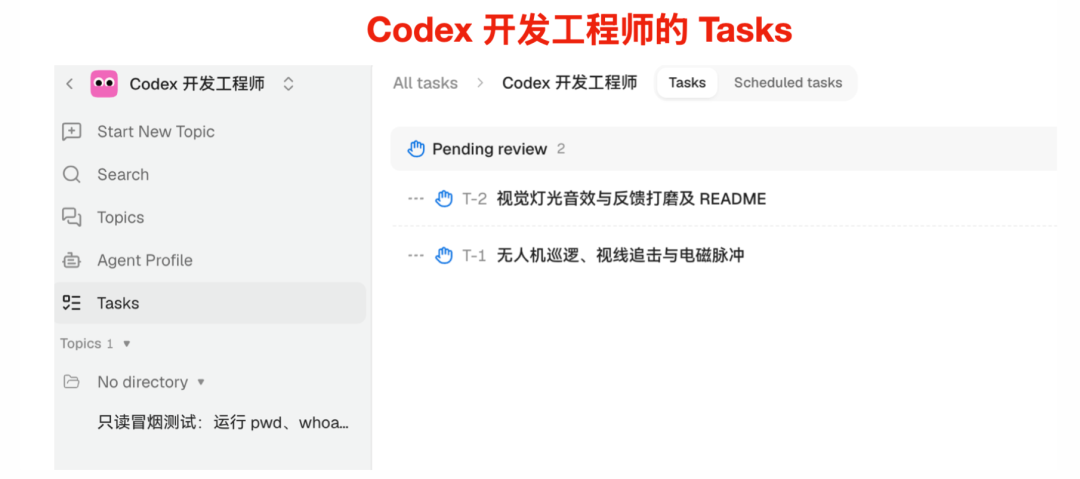
从 June 的任务布置上,可以看到它的需求调研、指派情况。
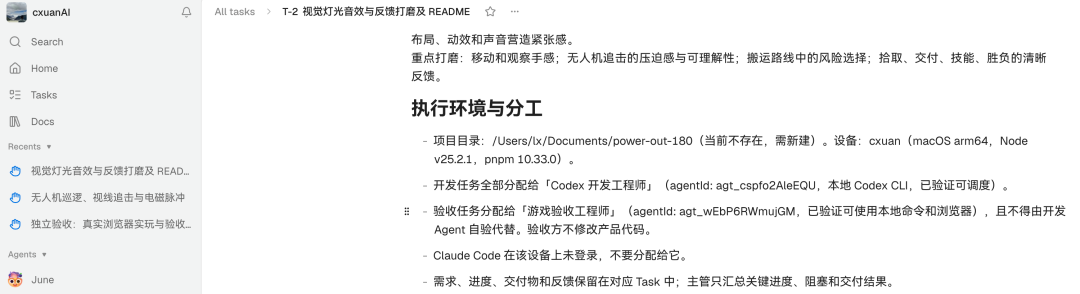 image-20261102171427084
每个 subagent 都有自己的任务执行边界和情况说明。
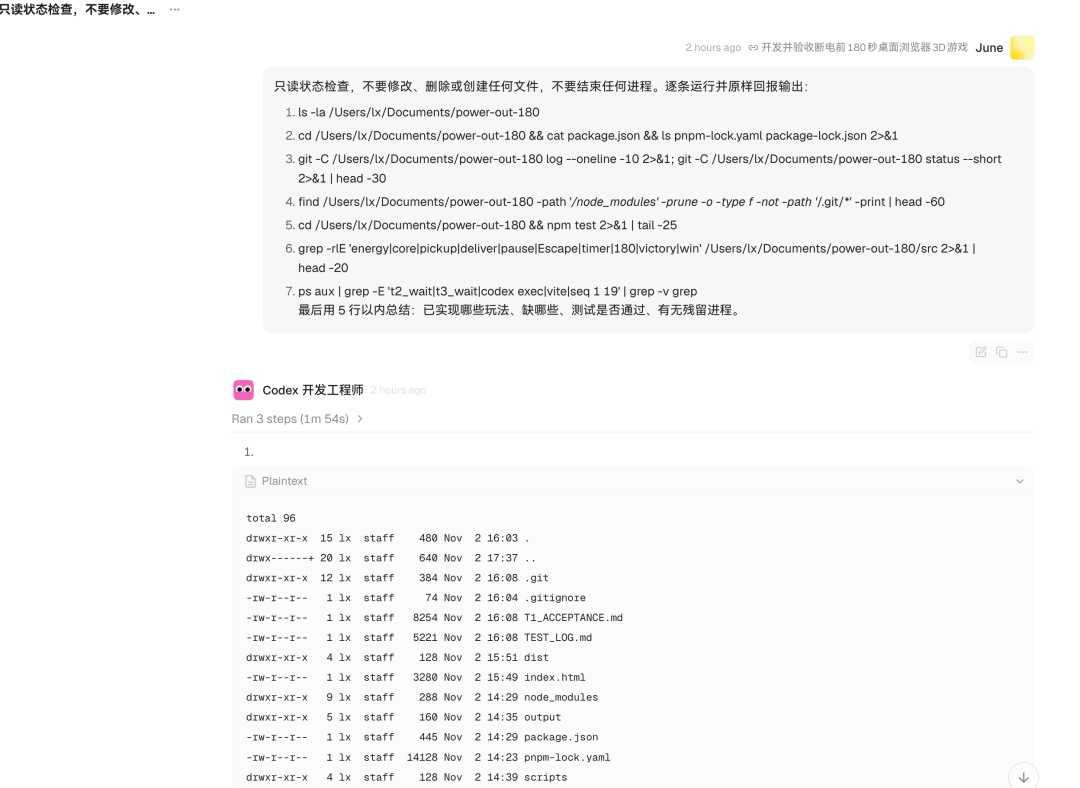 image-20261102204229819
在做 goal 等长任务的过程中,所有上下文和评论沉淀在同一个 Task 里。
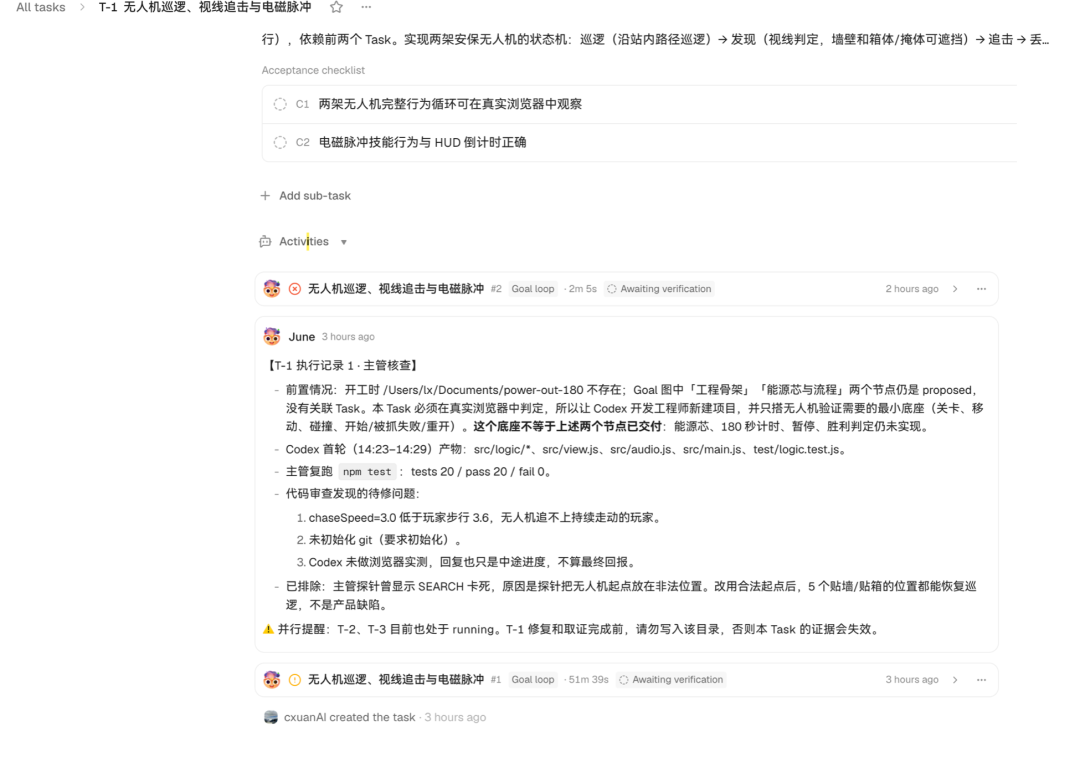 image-20261102173706437
在具体的任务执行过程中,可以看到每一轮的执行内容和结果。
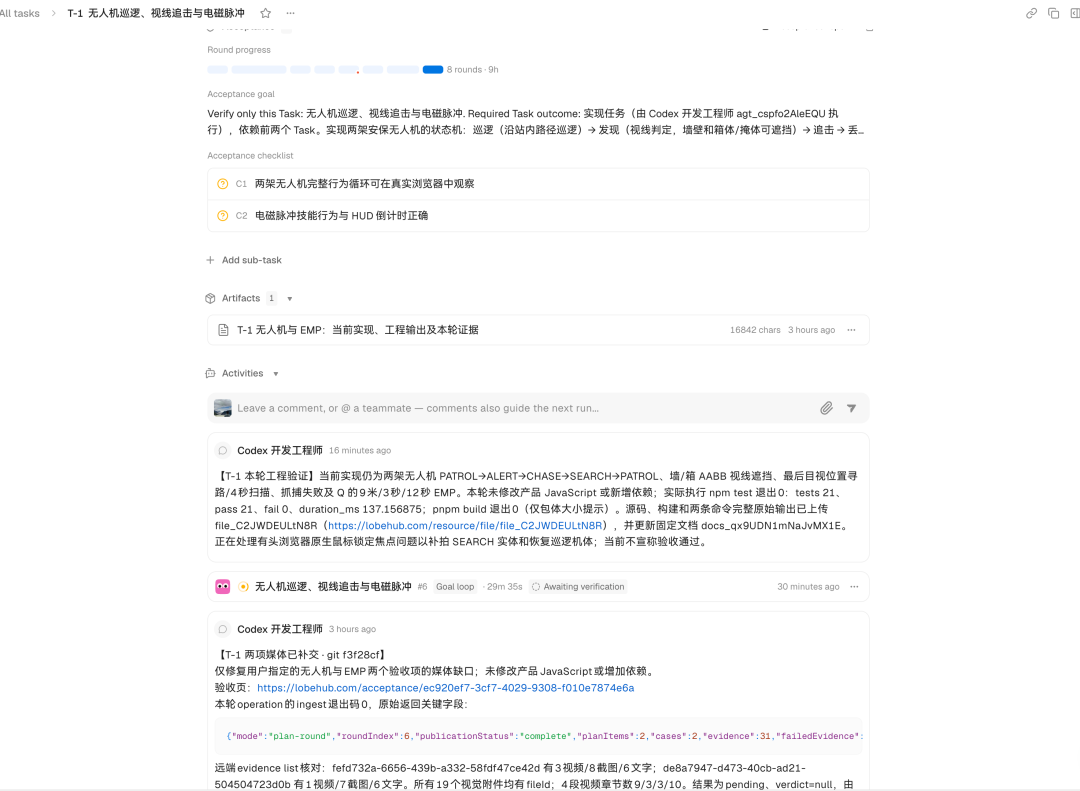 image-20261102231704543
任务执行完成后,会由主 Agent June 与用户交互汇报结果。
这里需要跟大家说一个有趣的事情。
例如 LobeHub 团队自己就在用类似的方式开发 LobeHub。
他们在 Discord 里部署了一个叫 Nasa 的主管 Agent,负责管理任务、协调不同的执行 Agent,并跟踪交付结果。
比如此前有一个 T-1149 任务,Nasa 将它分配给了名为 Dario 的 Coding Agent。Dario 随后完成开发、测试,并向 GitHub 提交了 PR #21852。
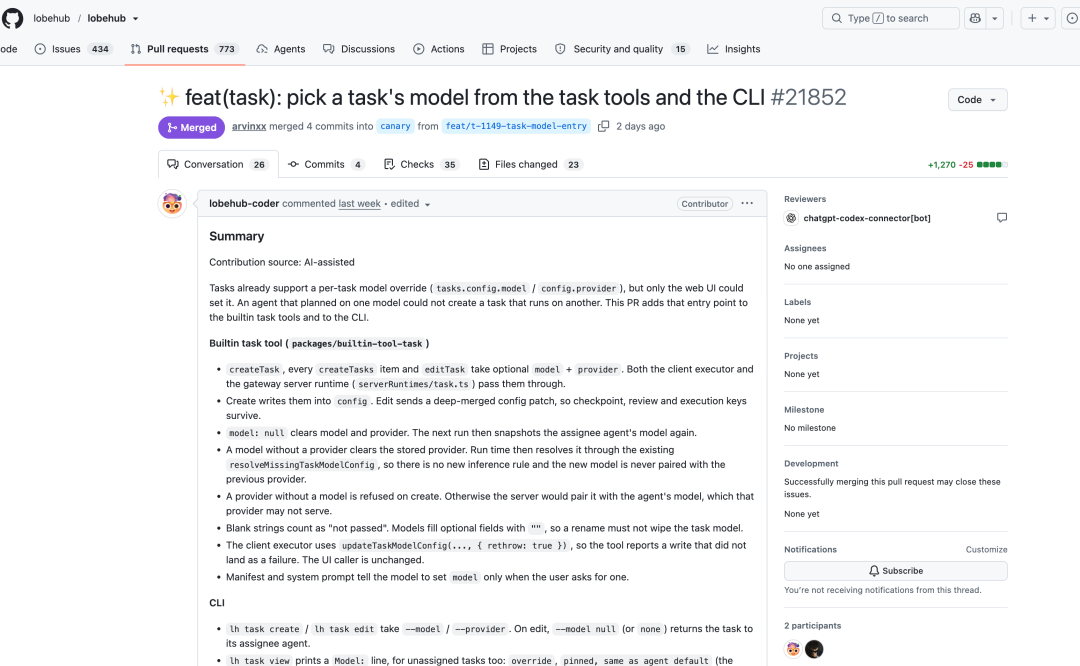 image-20261103034015130
这也解释了为什么 LobeHub 要把 Agent、Task、Goal、Workspace,以及外部 Coding Agent 的执行环境整合在一起。
因为他们已经在自己的研发团队里,用这些能力组织真实的软件开发工作了。
这是我认为 LobeHub 这个项目有趣的地方,它早已经被自己的 Agent 持续开发和迭代了。
事件驱动
DSH 团队的提出了 Trigger 机制,根据 Trigger 主动发现任务并执行任务,根据 Fast Path 和 Slow Path 做路由。
同样我们演示一下这个在 LobeHub 中该如何实现。
在 Agent 中,可以对其配置 IM bots 。
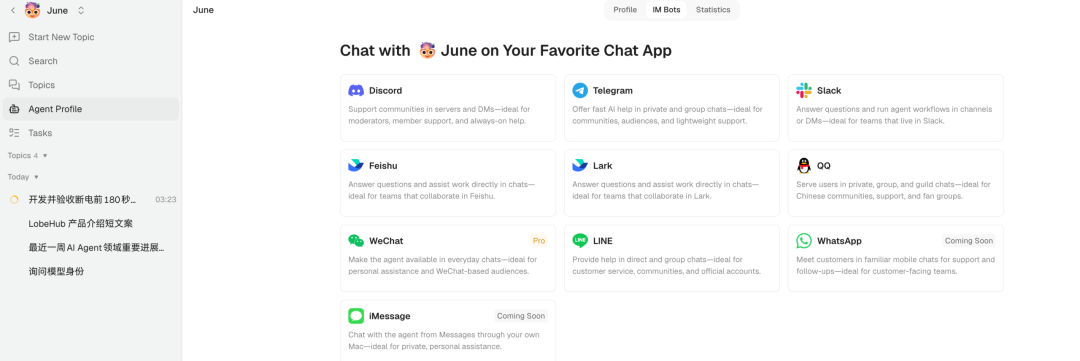 image-20261102190246714
比如我们直接配置了 Feishu bot ,当然配置别的 IM 终端也行,Discord 、WeChat 、Slack 都是可以的。
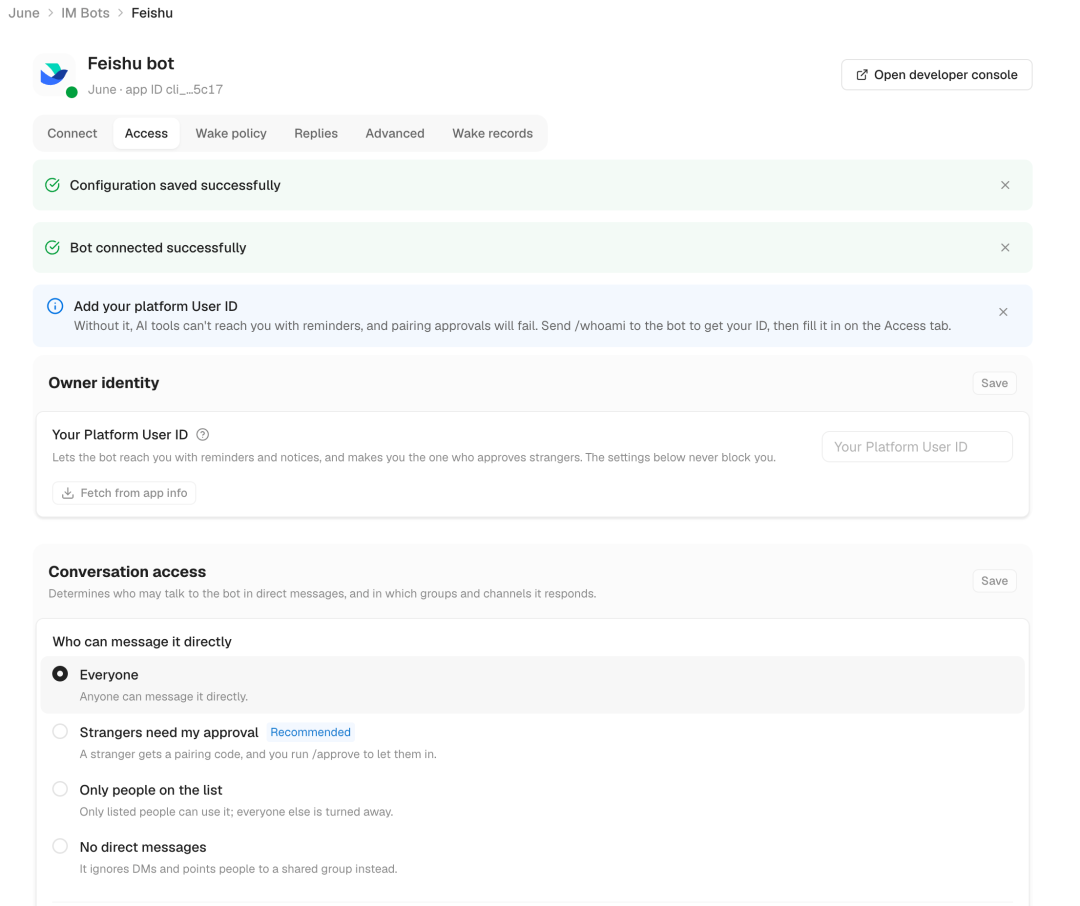 image-20261102191159754
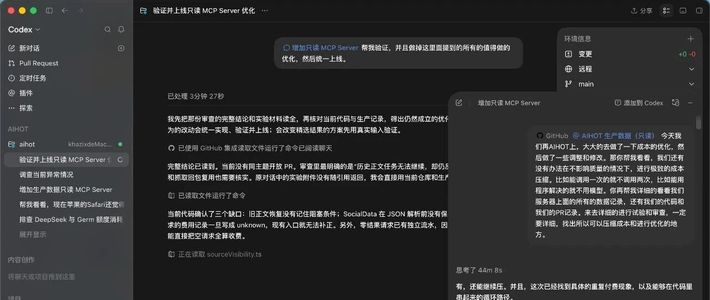
比如我拉了一个群组,这里面有三个 bot,分别是 June、Codex 开发工程师和游戏验收工程师,如果你问项目优化相关的内容,会由 June 进行汇总上报。
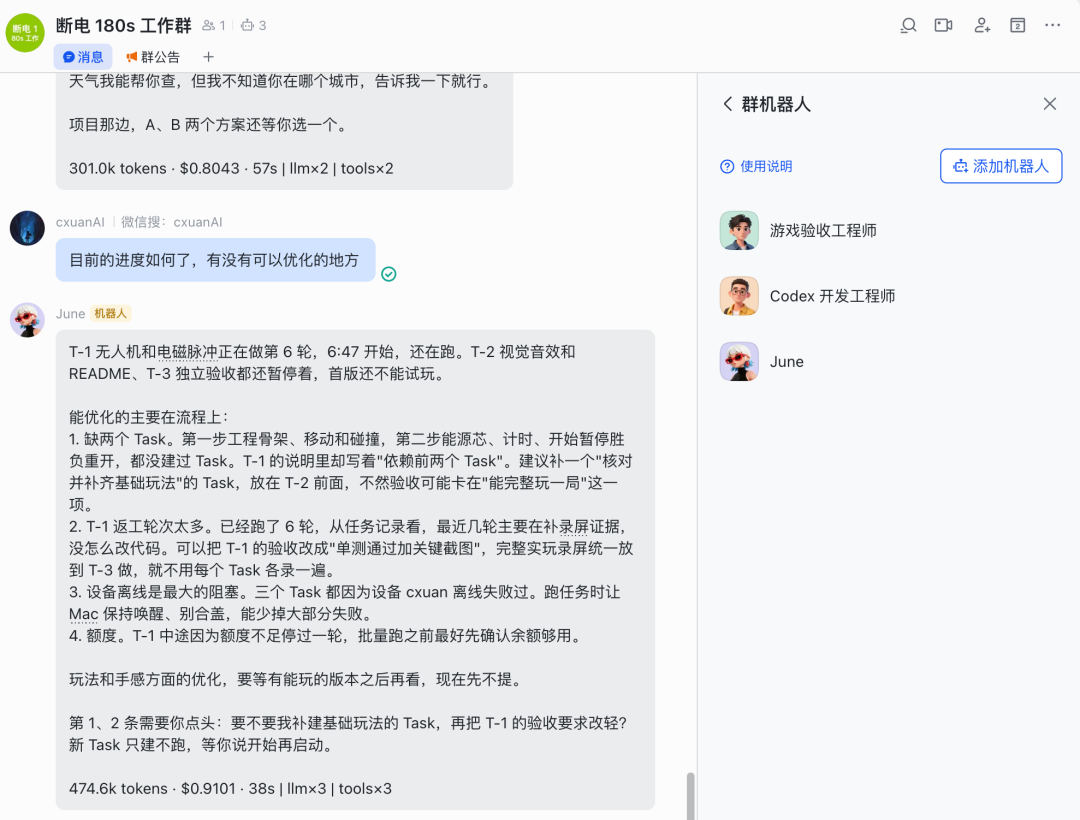 image-20261102231024163
甚至 Codex 这个 Agent 角色可以主动发现任务并执行,比如它就发现了一个 Codex 启动配置警告的问题。
上面这张图是 Agent 自己发现问题。但大多数时候,Trigger 是从外面来的。
点开 Agent 的 IM bot,可以看到 Agent 的 Wake policy ,更像给一个员工写值班规则:
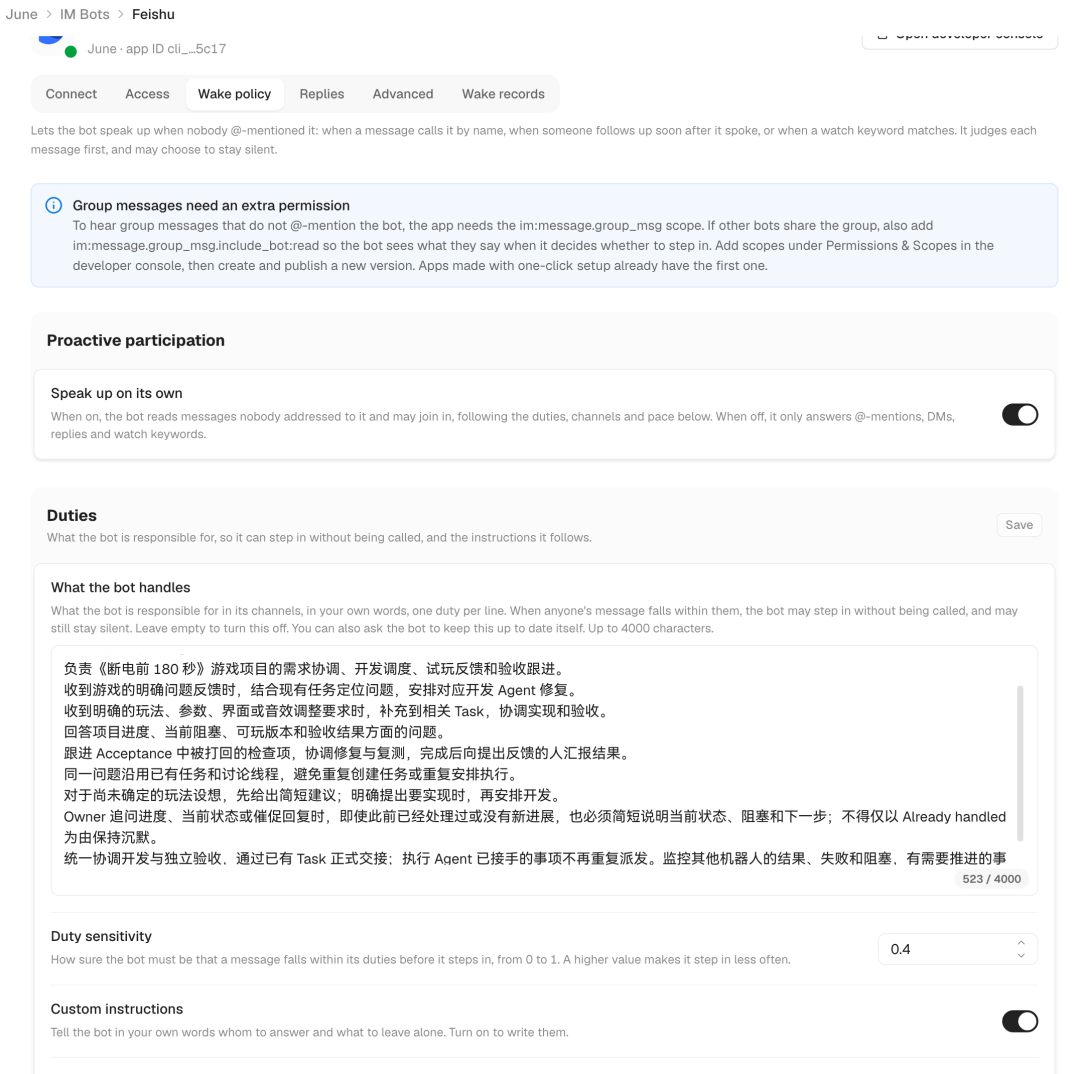 image-20261103044306230
Wake policy 其实分成两个环节。
第一层是规则。它默认只在几种情况下被叫醒:有人 @ 它、私聊它、回复它,或者消息里命中了 watch keyword。
第二层是模型判断,Speak up on its own 开着的时候,它会去读那些没点名发给它的消息,对照 Duties 里写好的职责频道范围和 Pace,自己决定要不要插话。
这些 wake 最终都会归档为 wake records。
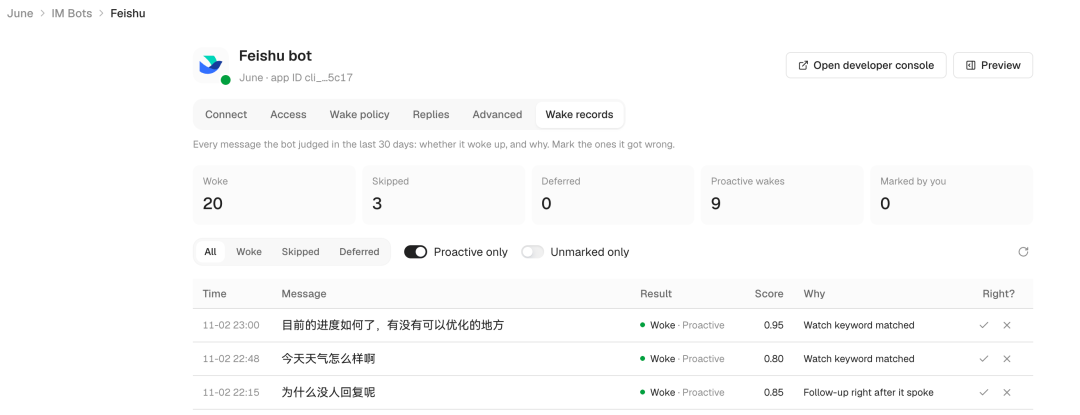 image-20261103044733991
所以它跟 DSH 那篇的两级过滤是一一对应的:@、关键词、追问这些是 Fast Path,先用规则把噪音挡在外面;然后交给模型,结合职责和上下文判断要不要介入,这是 Slow Path。区别在于 LobeHub 把这两层都做成了可配置、可回看、可纠偏的产品。
设备接入
我们可以在设备管理中看到 LobeHub 已经把本地、云端都打通了。
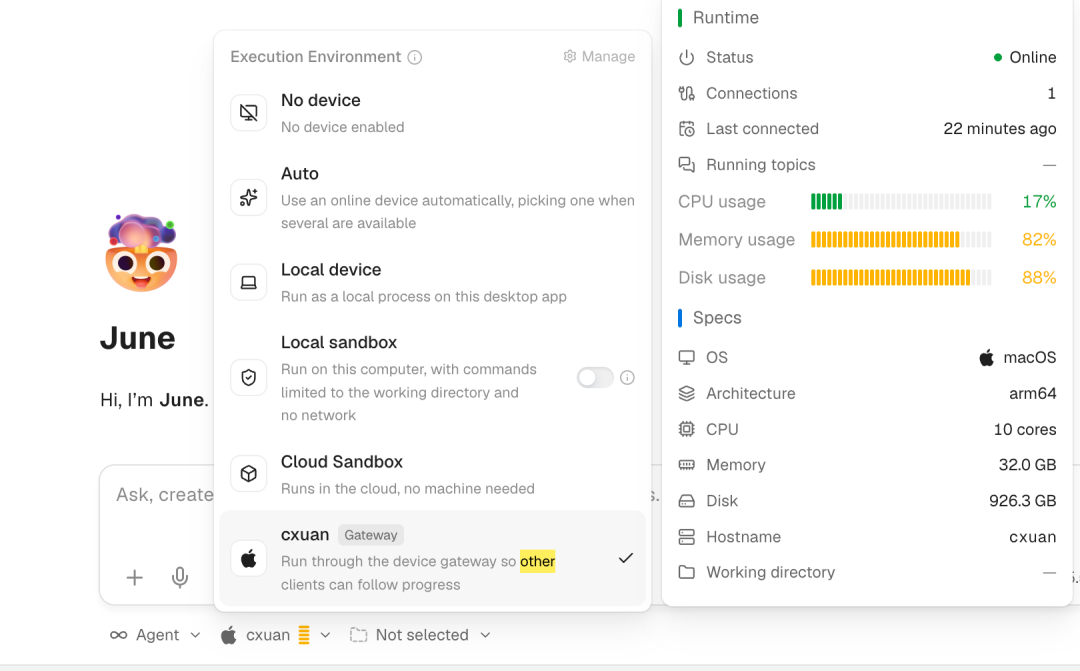 image-20261102174314183
在 LobeHub 中,执行环境是按 Agent 粒度选的,一共六档:No device、Auto(多台在线设备时自动选取)、Local device(作为本地进程直接跑)、Local sandbox(限定工作目录、断网情况)、Cloud sandbox(云端跑,不需要自己的机器),最后一个是通过设备网关来跑。
然后在 Settings -> Devices 这块,可以看到主机的硬件信息、Agent 情况、Topic(任务)情况。
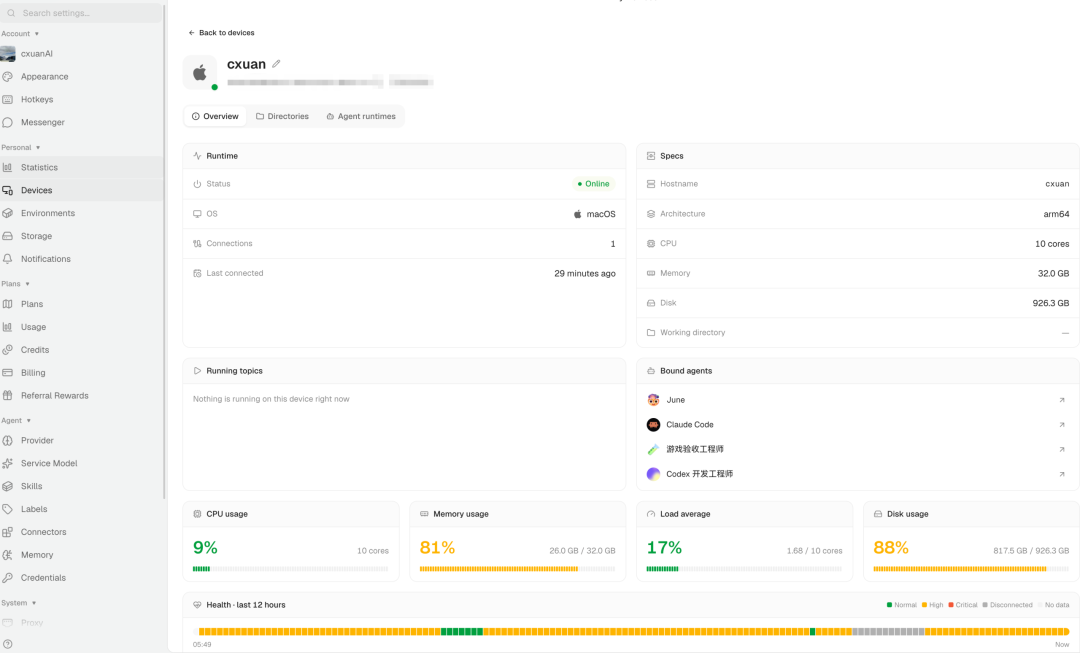 image-20261102175103346
我们可以看出,以云端 Agent 调用本地设备的模式为例,可以分成三部分:
• 计算:云端的 Agent Loop 负责调用模型、规划任务和决定下一步;
• 状态:对话、Task 进度和执行记录保存在平台里,供后续继续跟进;
• 环境:代码、文件和工具链留在 Mac mini 上,本地 daemon 接收工具调用,执行后把结果返回。
串起来就是:云端 Agent → 设备网关 → 本地 daemon → 执行结果返回 Agent。
上下文边界
DSH 团队那篇文章把上下文边界列为了开放性问题。
而 LobeHub 的做法是这样的,他们是用 Linear 式 Task 管理 Agent 协作:以上面 Workspace 演示的功能为例,在同一个空间内,任务的上下文、执行进度和所有评论都在同一个 Task 中,信息天然共享、可追溯、易管理。
这就是他们 5 月份刚上的 CAO 机制,目前已稳定运行半年;多任务可并行推进,大量工作由 Agent 自主完成,人只需在关键节点介入,团队在同一 Task 内共享全部信息。
CAO 是 Chief Agent Operator 的缩写,中文圈一般翻成首席 Agent 运营官,别笑 :)
我理解它要解决的是管理层的问题:当一个人手上同时有十几个 Agent,他要的其实不是对话框,而是组织架构和看板。
从上面的实测中,可以看出三条设计:
• 空间:人、Agent、任务在同一个 Workspace 里,信息天然共享,不用来回转发;
• Linear 式 Task:任务不是一次会话,是一张卡片,上下文、进度、评论全挂在上面,可追溯;
• 人的位置:只在关键节点介入,也就是打回或者通过。
这三条恰好补上了 DSH 团队的开放性问题。
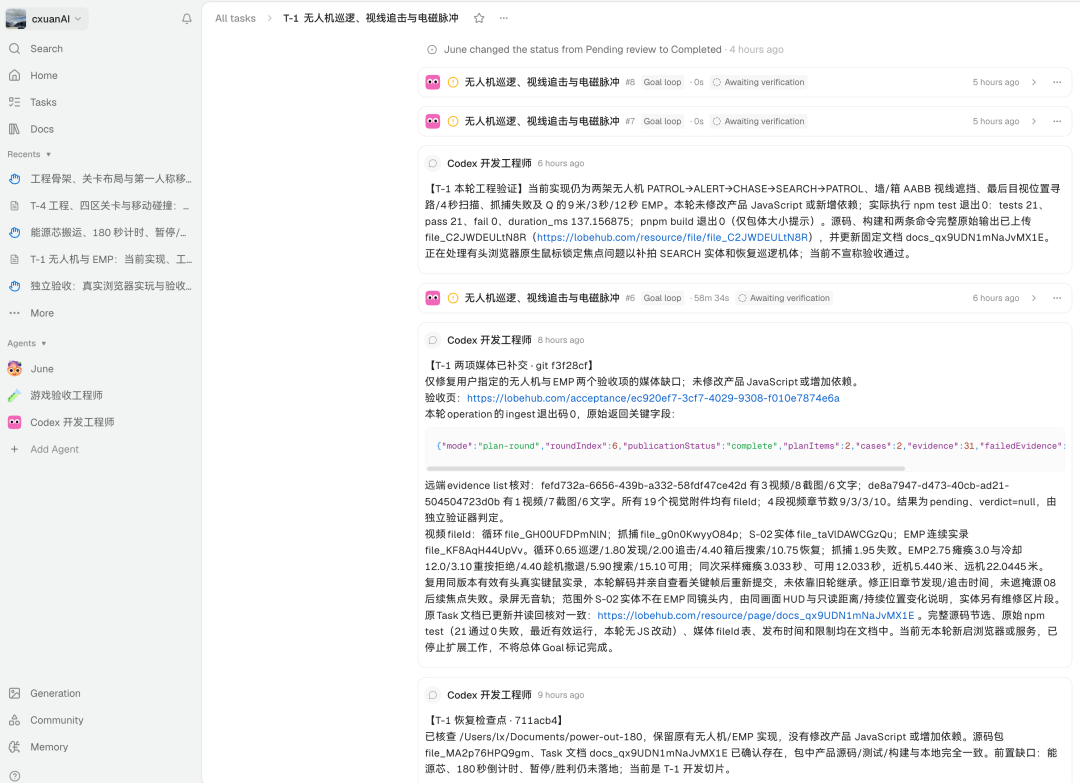 image-20261103045900948
上面这张 Task 详情就是证据:状态变更、每一轮的 goal loop、开发 Agent 的评论、Artifacts 里的交付文档,全在同一个页面里。
LobeHub 通过 Workspace 和 Task,给出了一个已经在产品中运行的任务级上下文管理方案。它让多个 Agent 能围绕同一个任务共享必要的信息,也保留了执行记录与交付依据。
但是 Agent 做完之后不等于就验收通过了。
在正常情况下我们得人工来验收。
不过这一轮跑下来,我觉得这句话得改半句:验收的过程可以交给 Agent,人只保留最后那个“打回或者通过”。
LobeHub 团队也刚刚发布了一个叫做 Acceptance 的开源项目,这是一个基于 Agent Loop 的工具,面向 Agent 的端到端验收测试 Loop,可以再让 AI 交付之前先拿出可以验收的依据。
它们在验收的时候是直接把 Acceptance 给接入了。
接入之后,交付物和验收记录是同时评估的。给大家看一下实际的游戏运行效果。
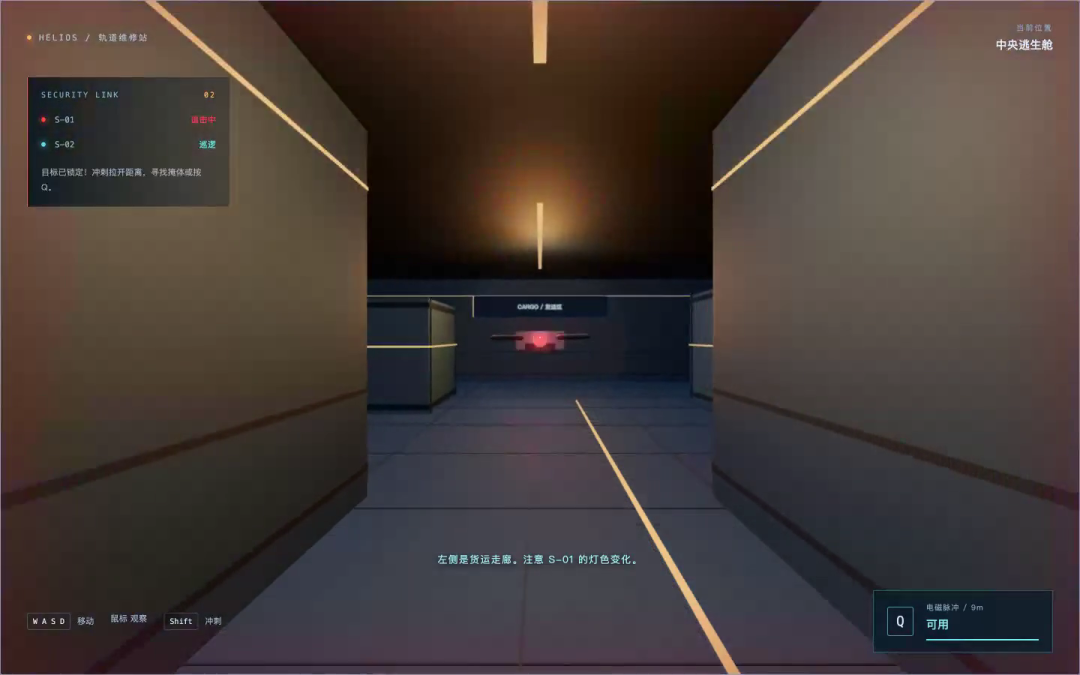 S-01 追击
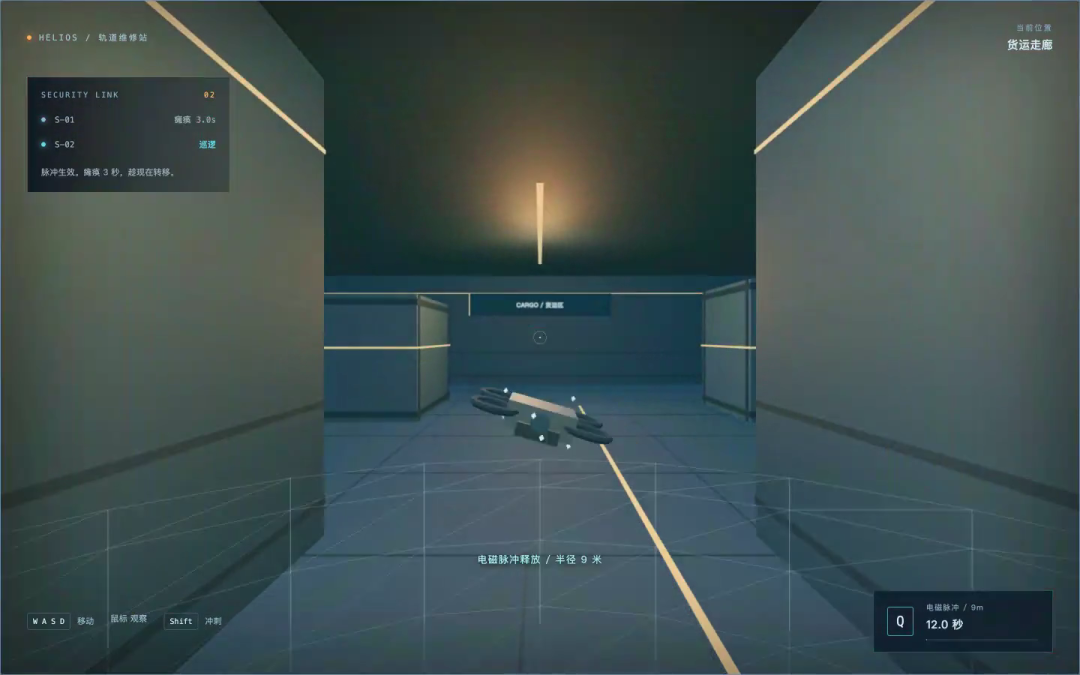 电磁脉冲命中
然后看验收本身。比如游戏验收工程师在验收的时候,会根据 Acceptance 做验收,最后交由人工来判断:
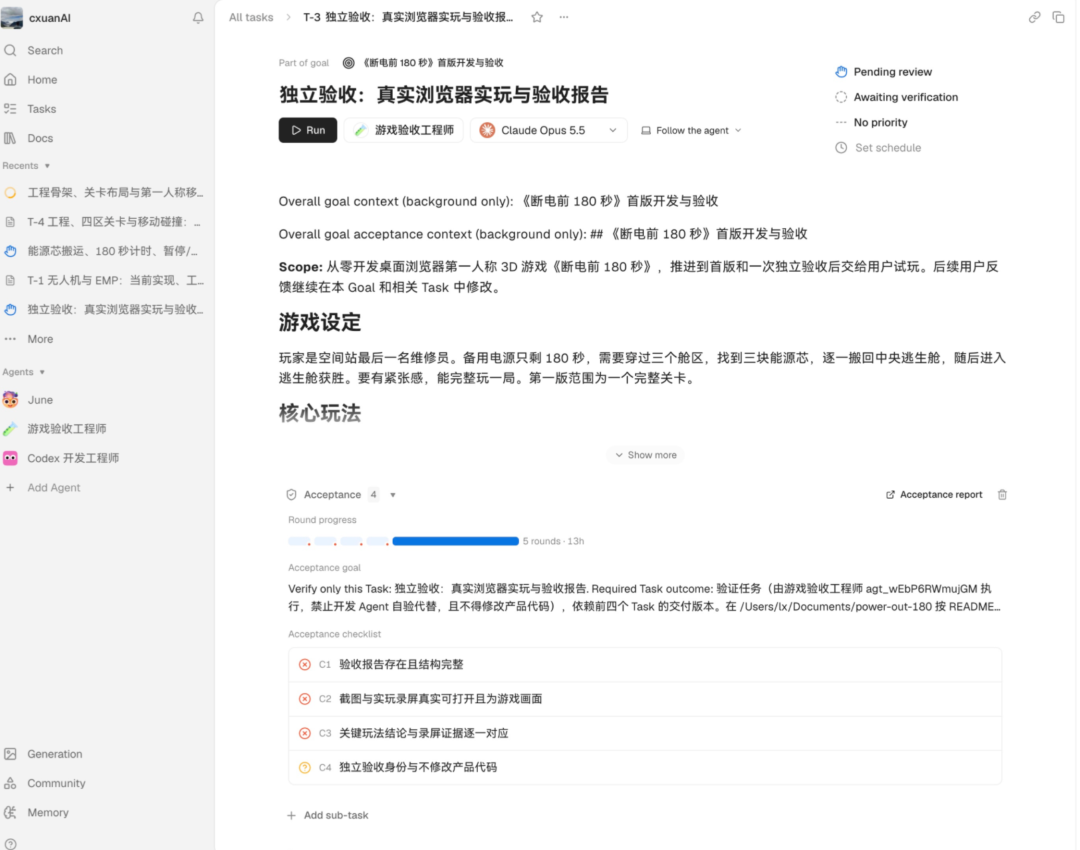
这里有个反直觉的点:验收失败,不等于交付失败。
失败之后再交由开发侧返工。第 6 轮把两项媒体补交上去:
判定完了之后,能够看到 C1 和 C2 已经验收完成了。
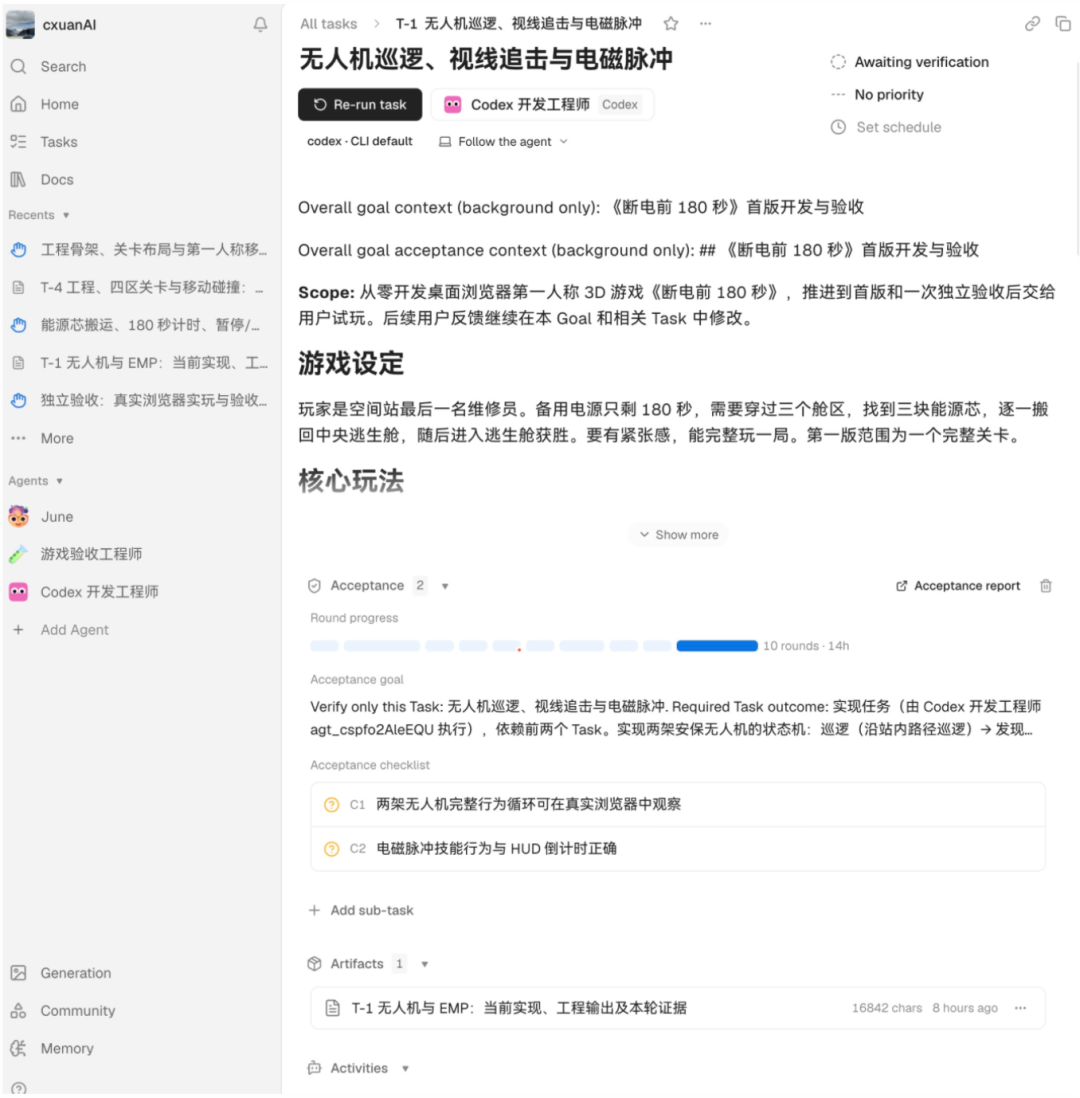
可以看到上面每一步都有可复核的记录:轮次、原因是什么、都交付了什么、判定了什么。
这才最终通过 Acceptance 完成了验收。
总结
这次折腾下来,我觉得 LobeHub 最有意思的地方,是它开始把多个 Agent 的协作当成一套可以持续运行和管理的系统来做,而不是一次性的任务编排。
以前自己搭 Multi-agent 的时候,解决的大多是一个任务怎么拆分给几个 Agent。任务只要一复杂,新问题就来了:进度、状态、异常如何处理、交接怎么做,如何验收。
但这一轮实测也让我看到,能把任务分派出去和能稳定交付结果之间隔着一大截。
这也正是 Acceptance 这类工具存在的意义:Agent 说它做完了,最终还得用真实的运行结果、截图、录屏、日志和测试记录来测试。
更有意思的是,LobeHub 团队自己就在这么干。他们已经把研发工作流搬进 LobeHub,让 Agent 参与开发 LobeHub,再用任务记录和验收机制一轮轮往下改。
所以要说现阶段的 Super-agent 已经成熟,我觉得还远远谈不上,但至少,我们已经能在真实项目里观察、甚至亲手测试一下整个流程,而不是对着架构图想象。
我觉得,LobeHub 这次实测给 Super-Agent 提供了一个可以丝滑上手的产品参照。
如果你也是开发者,完全可以拿自己的代码仓库试一把,看看一群 Agent 一起干活,究竟会给工作流带来什么变化。
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。