








 深耕数码兴趣领域






14
5
DeepSeek靠无脑堆内存就能通杀?真的假的
2025-02-21 09:04:34
19点赞
28收藏
57评论
大家好,我是波导终结者。
最近DeepSeek非常火,身边几位小伙伴也都心动了。目前方案无非两种,一种是使用线上服务商的在线接口,途径挺多的,但是都得联网也就会有隐私泄露问题,而且免费也不知道持续到什么时候。另一种就是本地部署,但是民用电脑想跑满671B还是不太现实。之前我试了一下,32B勉强能跑,14B是比较理想的。但最近冒出了不少内容(讽刺的是,看起来很像AI生成的……),号称只要把内存堆上去,比如搞套洋垃圾再插满192GB内存,就能本地跑671B啥的。我有位朋友不死心,问我说真的假的,我一看那些内容甚至连具体的实测都没有。于是这次我现场跑给这位朋友看。

这次的平台是之前配的12700K,Z690,因为现在还冒出不少用核显跑DeekSeek的内容,所以这次我把独立显卡拔掉,一起测试一下。没有在之前配的265K+Z890跑,因为想完全摒弃NPU的影响。
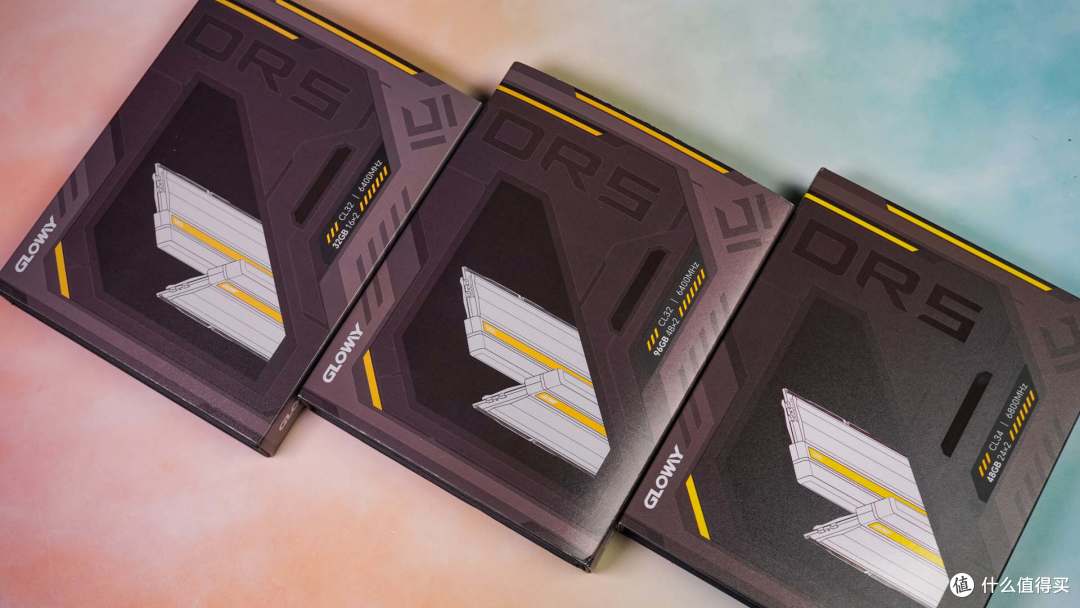
内存我之前已经升级到了光威神策DDR5 6400Mhz 48Gx2,若真的如营销号所说,堆内存就能把模型跑上去,再考虑更大的内存方案。

默认参数如上图,因为没有独显,默认的设置为纯CPU线程池跑。不过这里线程池的设置也没有拉满,先试试默认方案下的效果。
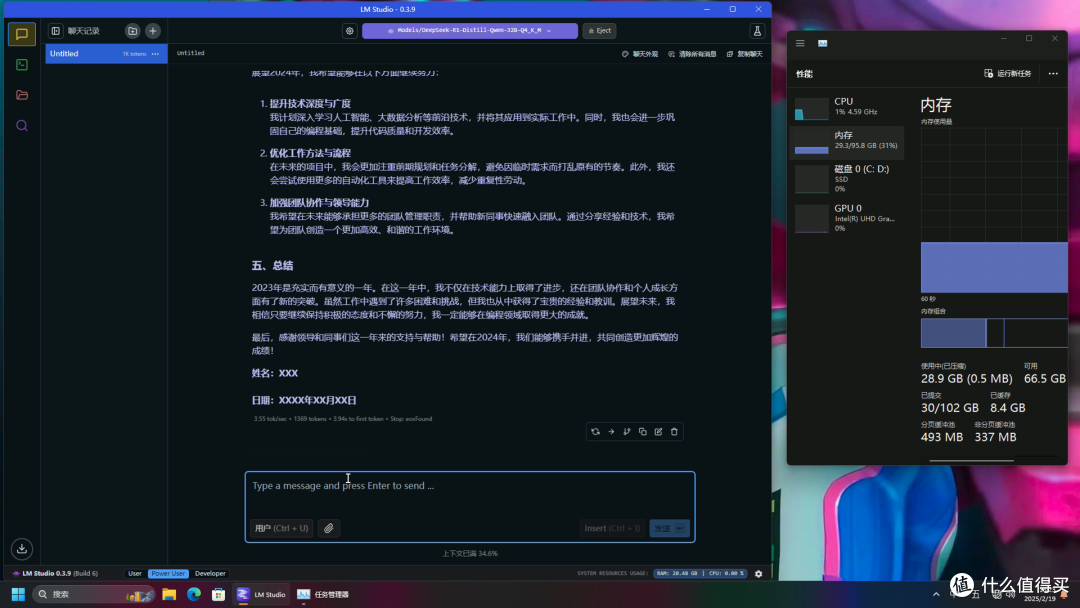
默认设置下,1分35秒出结果,3.55 tok/sec,1369 tokens,3.94s to first token,内存占用29.3G,CPU占用率在50%左右。题目统一为“我是一名程序员,每天上班24个小时,每周上班7天。请帮我写一篇1000字的年终工作总结”。

将设置里的GPU卸载拉满,我当然知道12700K搭载的核显现在很弱,我只是觉得营销号鼓吹的“只要内存堆上去核显也能随便跑”根本就不靠谱。实测11分钟35秒才出结果,而且一个字一个字蹦又要花好久。这种情况下,我认为已经失去可用性。
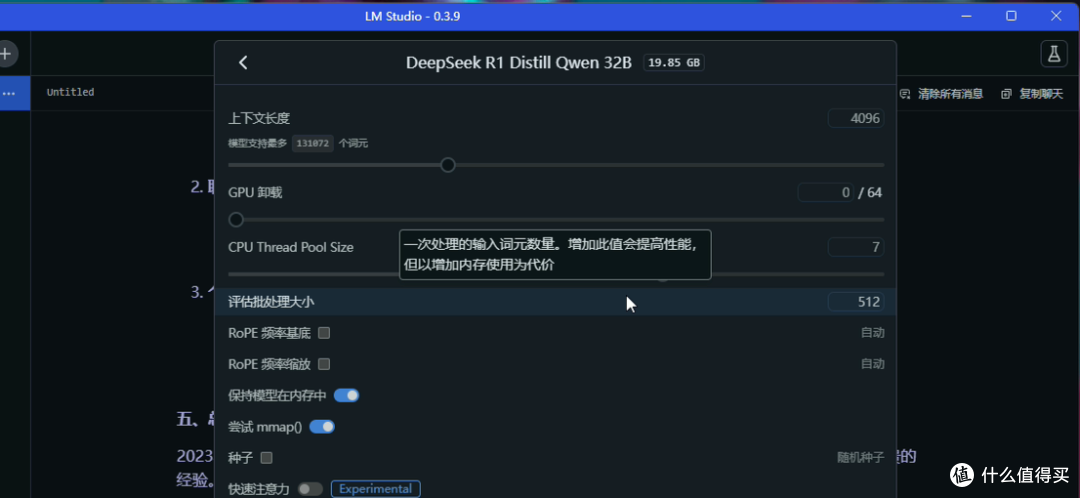
那么,所谓的用内存堆又如何操作呢?我把各个选项和可能性都试了一下,这里明确写明会“增加内存使用”的评估批处理也拉到过最大了。

GPU卸载拉到16,CPU线程池10(均拉满),评估批处理512,内存占用稍微增长到30G,CPU占用25%左右,GPU占用60%左右。5分48秒出结果,1.34 tok/sec,1537 tokens,11.64s to first token。
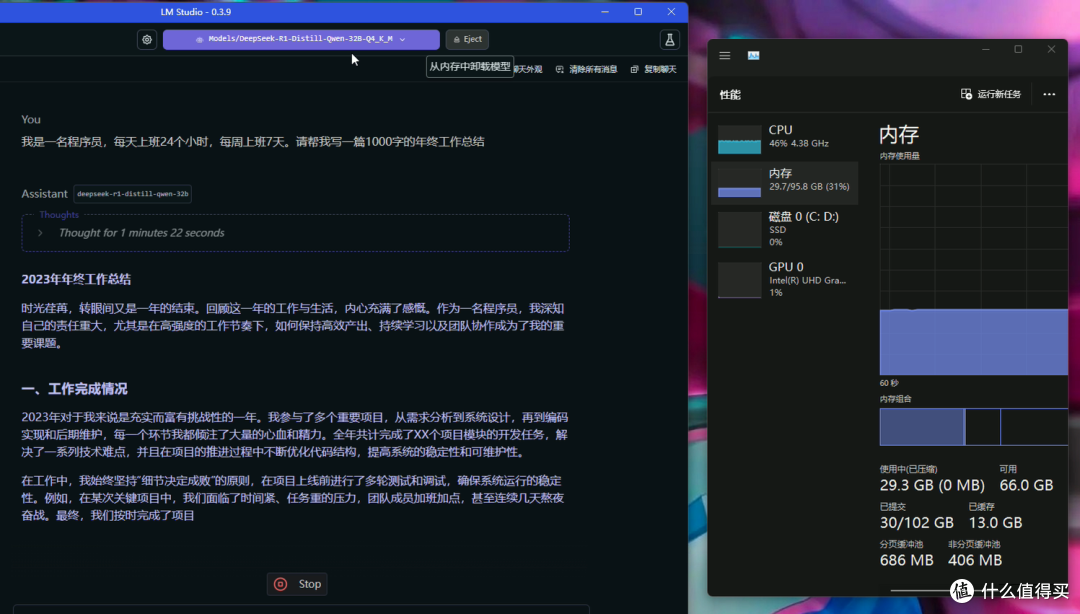
默认设置,单纯把评估批处理拉到1024,3.63 tok/sec,1132 tokens,3.77s to first token,速度和资源占用均无太大变化。把CPU线程池拉满到10,评估批处理拉满到1024,3.65 tok/sec,1225 tokens,3.10s to first token,稍微快了一点。

其他方案我也都试了一下,就不再赘述。我自己以前就是程序员,所以在跑之前,我就知道死堆内存不可能,但小伙伴各种短视频刷多了,不亲眼见识一下不死心。显存或者内存只是最基础的硬件条件之一,而不是堆上去就能随便跑。本地模型仍然需要依靠算力出结果,所谓的什么洋垃圾插满内存,核显插满内存,破独显共享插满了的物理内存等,都只是一场流量狂欢罢了。
感谢大家的观看,点赞和关注,我们下期再见。






校验提示文案
纯cpu感觉是靠avx512或avx2命令跑的,效率感人
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
纯cpu感觉是靠avx512或avx2命令跑的,效率感人
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案