扎克伯格罕见地公开感谢了苹果的新任CEO。10月15日,Meta开源了816B参数的Muse Spark Open,苹果MLX团队同日发布技术博客:这个巨物能用两台M5 Ultra Mac Studio本地跑起来。一对互相捅了五年刀子的公司同台握手,消息瞬间刷屏。知乎知乎小红书
对玩本地部署的人来说,这事值得兴奋——但兴奋之前,先把几组数字摊开看看。
先搞清楚:这是个什么模型
Muse Spark Open是MoE架构:总参数8160亿,每个token只激活420亿,相当于256位专家里每班只叫8个上岗。上下文窗口100万token,原生支持图片、音频、视频输入,主攻编程和长流程Agent任务。权重已上架Hugging Face,Groq、OpenRouter等7家平台同步开出API,官方口径是"迄今能力最强的美国开放权重模型"。知乎
注意"美国"这个定语。有定语,就有故事。
内存账:493GB<512GB,为什么还是装不下
BF16原生精度下,光权重就超过1.6TB,任何桌面机都别想。苹果用NVFP4四位量化把内存占用压到约493GB。看到这你可能想:单台512GB的Mac Studio,不是刚好塞得下?知乎知乎
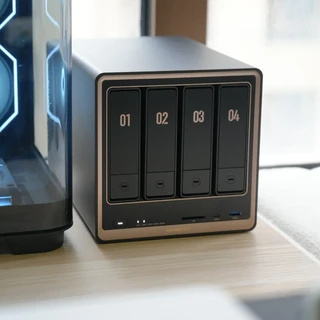
塞不下。加上KV缓存、推理中间状态和系统自身开销,剩下的十几GB不是余裕,而是问题的开始。所以才有"两台"方案:两台512GB的M5 Ultra用雷雳线直连,靠MLX的RDMA通信把模型拆开算——张量并行让两台机器同时干活,实测约25 token/s;流水线并行一台先干完再交给另一台,只有15.7 token/s。知乎
速度与门票:每个数字都带着前提
25 token/s听着能打,但小字部分写着:NVFP4量化、8K上下文。100万token长文和多人并发统统没测,首token还要等8.2秒,四台机器(36.7 token/s)才压到4.8秒。知乎
门票更硬核:512GB顶配M5 Ultra Mac Studio月底才开卖,媒体粗算两台的采购成本超过2万美元。想省钱还有一条路——HuggingFace团队试了单台M3 Ultra(512GB)跑更低的2/3bit量化,实测18~21 token/s。但量化格式和测试条件跟苹果那组都不同,不能直接比优劣,动单机念头之前,拿自己的任务重测一遍再说。知乎
跑分账:“美国最强”,真打不过国产
artificialanalysis.ai上,Muse Spark Open(High档)综合39分:与DeepSeek v4.1 Flash持平,比GLM 5.3 Flash低3分,比Mimo-V2.6-Pro低7分。Meta自己放出的对比表也承认,在Terminal-Bench终端编程、DeepSWE长周期软件工程上落后于Kimi K3和GLM 5.3,领先的主要是JobBench、MCP-Atlas这类工具调用项目。翻译一下:想本地跑个写代码的模型,"更小内存能跑、跑分还更高"的国产开源选项就排在那。Muse Spark Open真正的差异点是100万上下文+全模态输入+长程Agent的原生支持,而不是绝对分数。知乎知乎微博
上手前,还有两句提醒
许可用的是Muse Model License:可以免费用,但产品要标注"Built with Muse Spark Open",高收入API转售商得单独签协议——“开放权重"不等于"无限制商用”。另外模型默认reasoning_effort拉在最高的xhigh档,四个档位里没有"关闭",不手动调低,token会烧得飞起。知乎知乎
这消息到底跟谁有关
Meta今年早些时候买了数百台Mac专门研究本地AI,苹果需要一个标杆负载来卖新机——两家握手,各自的算盘都打得响。但"前沿级模型跑进书房、数据不出门"这个方向,是真的。
个人玩家:先去7家API平台把任务测一遍,别急着下硬件订单。手里有敏感数据、任务利用率高、也有人会维护的团队,才值得把这笔2万美元的账认真算完。