225封勒索信躺了7小时没人拆:软银这场网安喜剧,机房里的人笑不出来
10月7日凌晨3点40分,软银旗下IDC Frontier的IDCF云平台出事了:东日本四个可用区的虚拟机批量起不来,怎么重启都拉不回来,数据难以恢复,495家企业和政府机构被波及。 而攻击者"战报"里的版本更离谱——自称7分钟打穿东日本第1区,在225个数据存储的根目录各放了一份RECOVER-INFO勒索信,然后坐等对方来谈判。 7个多小时里,运维只干了三件事:重启虚拟机、轮换管理密码、拿模板批量关客户工单,关完还追发满意度评价邀请,黑客最后被逼得只能黑掉官网,把勒索信直接挂首页吐槽运维。 微博话题#黑客被日本运维整崩溃#冲上热搜,知乎相关提问242条评论吵翻天:运维手册第一页写的就是重启、改密码。知乎微博微博
笑之前先分清哪些是官方认的,哪些是黑客一个人说的。官方公告确认的只有故障时间、四个可用区(tesla、henry、pascal、joule)虚拟服务器停摆、数据难恢复、495家客户受影响;7分钟突破、239台宿主机加密、1.66万块磁盘报废、3.6PB存储被加密、55万份快照销毁、连41.5PB备份容量也没了——全部是攻击者单方面宣称,IDCF一个字没证实。 但方向对得上:官方让客户靠自己的备份,恰好印证"备份没保住"。知乎
那225封信为什么真没人看见?信就放在每个数据存储的根目录、文件名统一,运维登录任意一台宿主机ls一下就能看到,七个小时没人打开。 可现代云运维的眼睛不长在宿主机上,只长在监控大盘、告警弹窗、工单系统三块屏幕上。虚拟机起不来,工单SOP的标准动作就是重启、重试、拉不起来就升级;管理面疑似有风险,就轮换密码。每一步都合规,每一步都在"做事",但整套流程里没有一步叫"打开异常主机的文件系统看看为什么"。再叠加KPI:工单要按时响应关闭,关闭率、满意度是考核项。于是入侵事件被当成一批故障"结项"了。安全圈把这叫定性错误:故障还是入侵,就差这一个判断——判成故障,动作是恢复服务;判成入侵,第一动作是隔离取证。知乎
而最忌讳的动作恰恰是重启:不确定病因就急着重启,等于把进程痕迹、异常连接全部擦掉,现场没了,取证断了,入侵者撬开的门你顺手帮他关上,他还得再撬一次。这7小时本来是用来隔离受影响主机、保住没被加密的数据、固定证据的。这套剧本跟日本没关系:按工单量考核、运维外包的团队都一样。
别光笑IDCF,那495家客户就是对照组。备份这件事,三个问题比备份容量重要得多:备份跟生产环境物理隔离了吗?同云里的快照、同账号下的备份桶,勒索软件拿到权限后第一个找的就是它们;备份是不可变的吗,能不能被正常权限删改;真演练过一次恢复吗?恢复不出来的备份不算备份,只是"以为自己在保底"。还在用云服务的中小企业,值得拿三个问题问云厂商:宿主机级入侵的检测隔离流程是什么?工单之外有没有独立的安全事件上报通道?备份和产品是否不同账号隔离?没有像样答案的,把"要不要继续把命放在这家云上"列入重新评估。
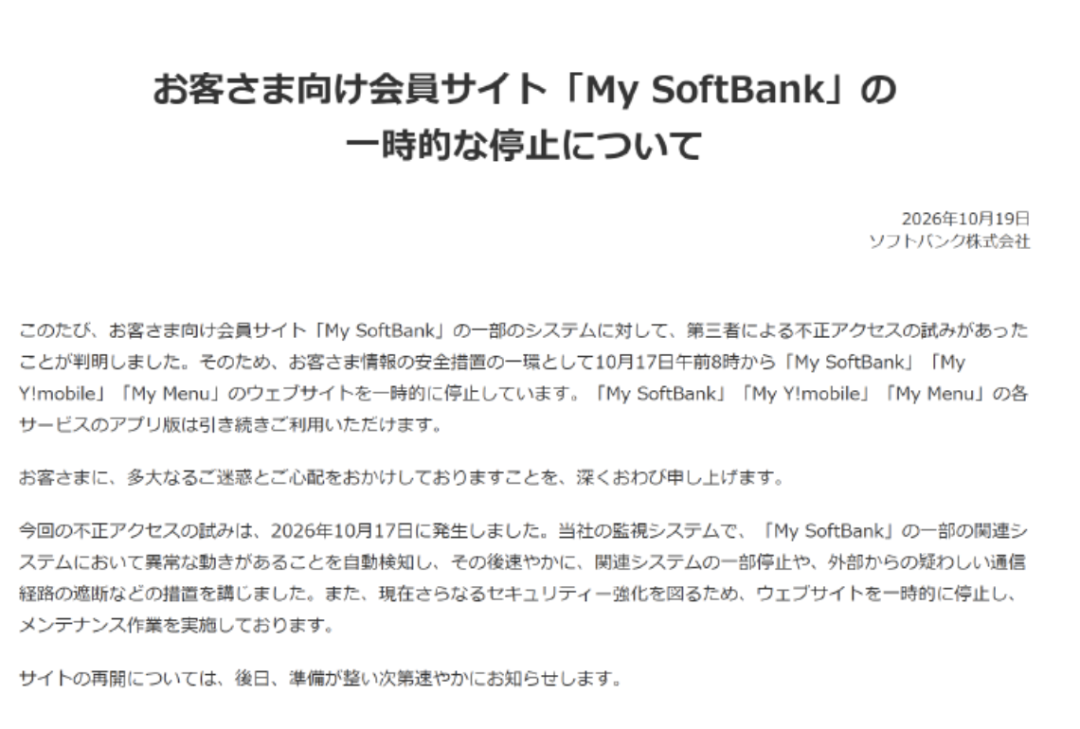
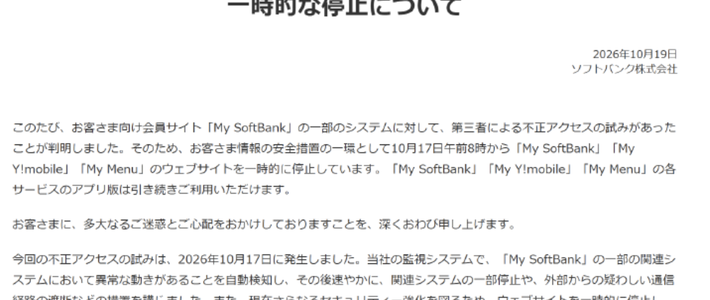
这事也不是孤例:10月19日,勒索组织发布公告,声称已窃取高达10.6TB的敏感数据,针对的是国内某知名分布式数据库厂商,还引用其内部工单嘲讽。 同月,软银表示旗下会员网站My SoftBank于10月17日遭到黑客入侵,随后公司暂停部分关联系统运行,官方公告临时关站。 日本NICT指出,这轮泄露至少部分与A2B攻击有关——云上租户恰恰最容易被流程化运维耽误。接下来值得盯两件事:IDCF会不会正式确认勒索要求与数据泄露范围、495家客户的自备份救回了多少。下次凌晨值班碰到一片批量告警,先停三秒,问一句:这是它坏了,还是有人进来了?这一句决定的是那几个小时之后,你是复盘的人,还是被复盘的人。知乎IT之家