4090 48G,跑个 27B,一轮 30 分钟起。
这不是段子。有人用公司配的 4090 48G 跑本地业务模型,Qwen3.6-27B、35B-NVFP4 跑一遍 30 分钟起步;换成 35B-AWQ 是快了,但 skill 读不明白,写脚本硬兜底都救不回来。看到这,很多人的第一反应是算力不够,或者干脆劝你别自己部署。小红书
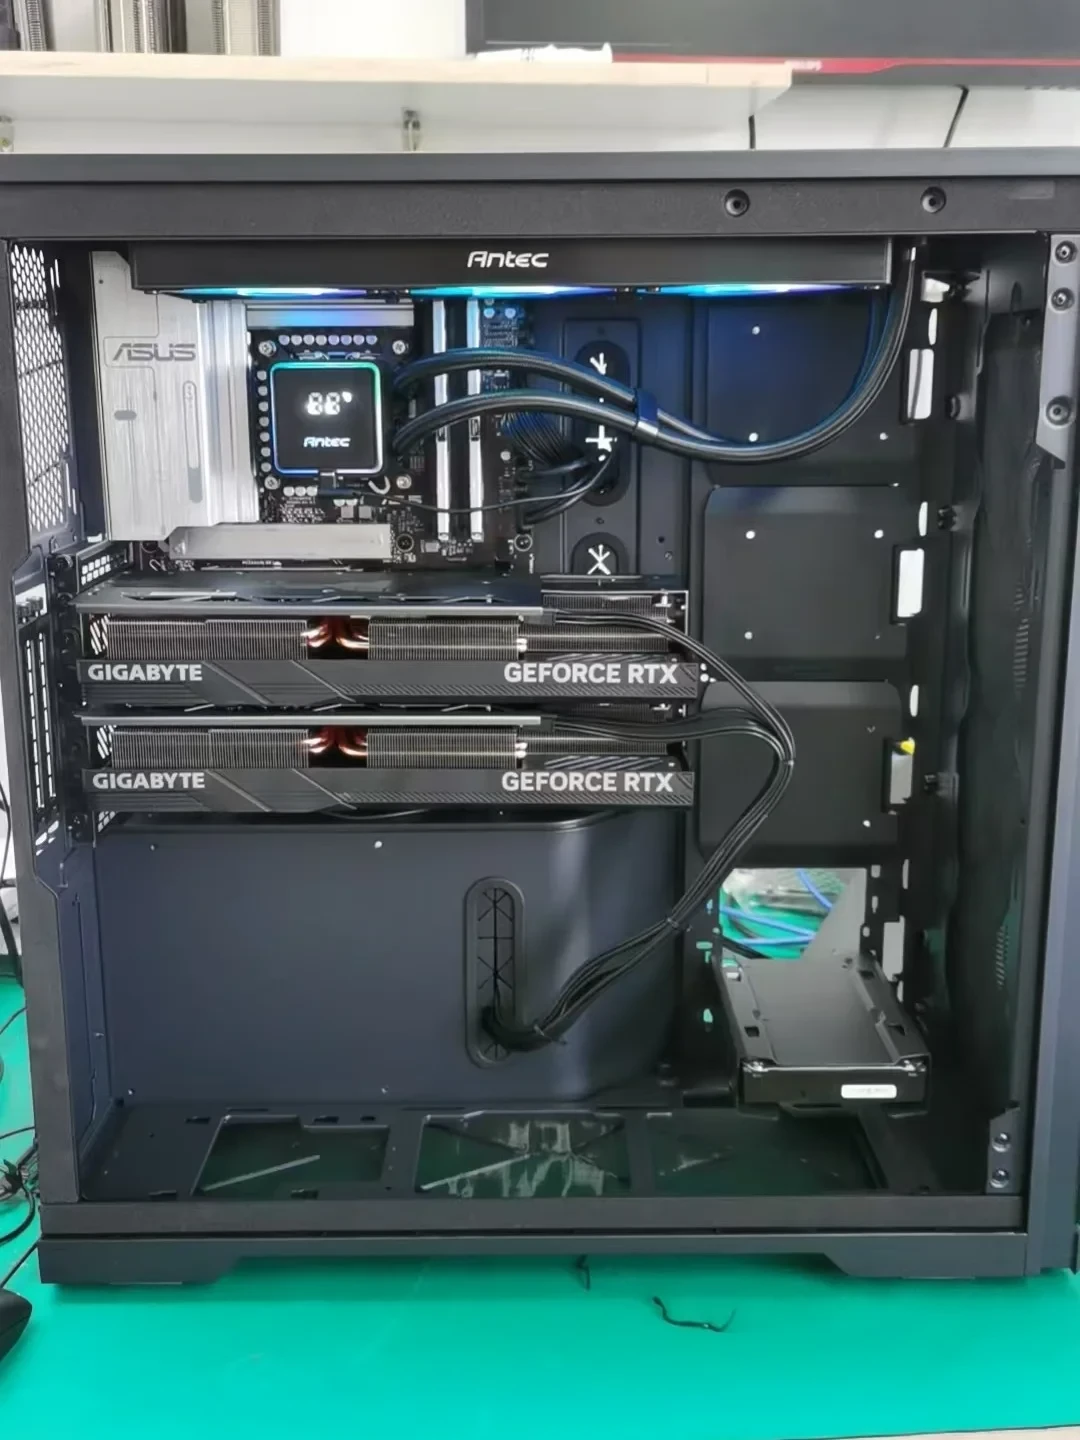
可硬件这边,早就不是瓶颈了。
消费级硬件跑千亿模型已经不是新闻:24G 的 RX 7900 XTX 用 Strata 跑 125B 的 Qwen3.8-Flash-Next,prefill 峰值 2030 tok/s,从 32K 到 262K 上下文显存只多 8MB;12G 显卡加 32G 内存,也能一键跑起 1250 亿参数。小红书微博
第一个坑:Agent 基座,开机先塞给你 4.5 万字。
有人把 workbuddy 的首轮提示词扒出来看:4.5 万 token,相当于开场先让模型读一篇四万字的中篇小说。对云端 API 来说这是一毛钱,对本地模型来说全是干扰项。知乎
同一个 35B-A3B,直接对话不到一分钟就能吐出能跑的 HTML,接上基座折腾半小时还是个半成品。换成首轮只要 2000 token 的轻量基座,27B 才更像能干活的工具,而不是被四万字开场白拖垮的复读机。知乎
第二个坑:为了塞进去,量化压得太狠。
llama.cpp 的量化对比里,Q3_K_S 体积能压掉 77.23%,代价是平均任务分从 69.47 掉到 65.49,PPL 从 7.32 升到 8.96。这不是玄学,是实打实的掉智力。更稳的顺序是:先挑显存装得下的最大参数量,再用 Q4_K_M 压,别反过来。知乎知乎
第三个坑:内存的账,很多人从第一步就算错了。
256G 是标称值,实测 Metal 给 GPU 的硬顶只有 222.7G;105.4G 的权重文件,加上预测头、嵌入层和缓冲对齐,得按 142.3G 留。按标称值买机器,跑起来才发现根本装不下。小红书
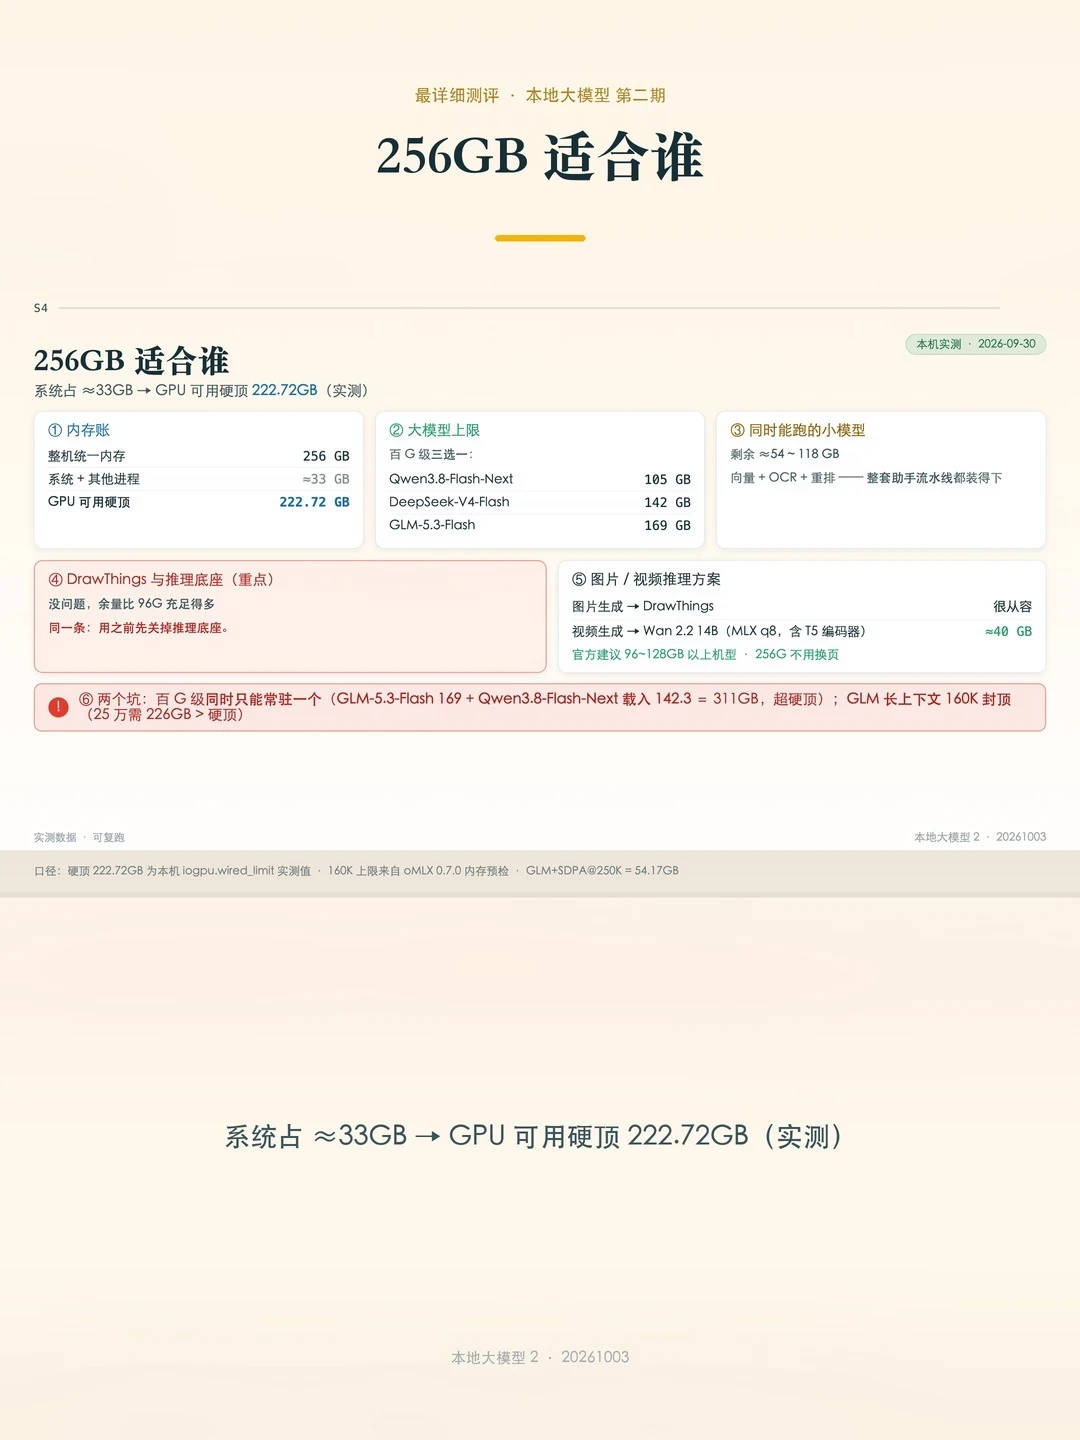
同一台机器、同一个模型,换框架、换上下文长度、有没有命中前缀缓存,读数能差 6.8 倍。所以「哪个引擎最快」这个问题本身就不成立,得看你的活儿是什么。小红书
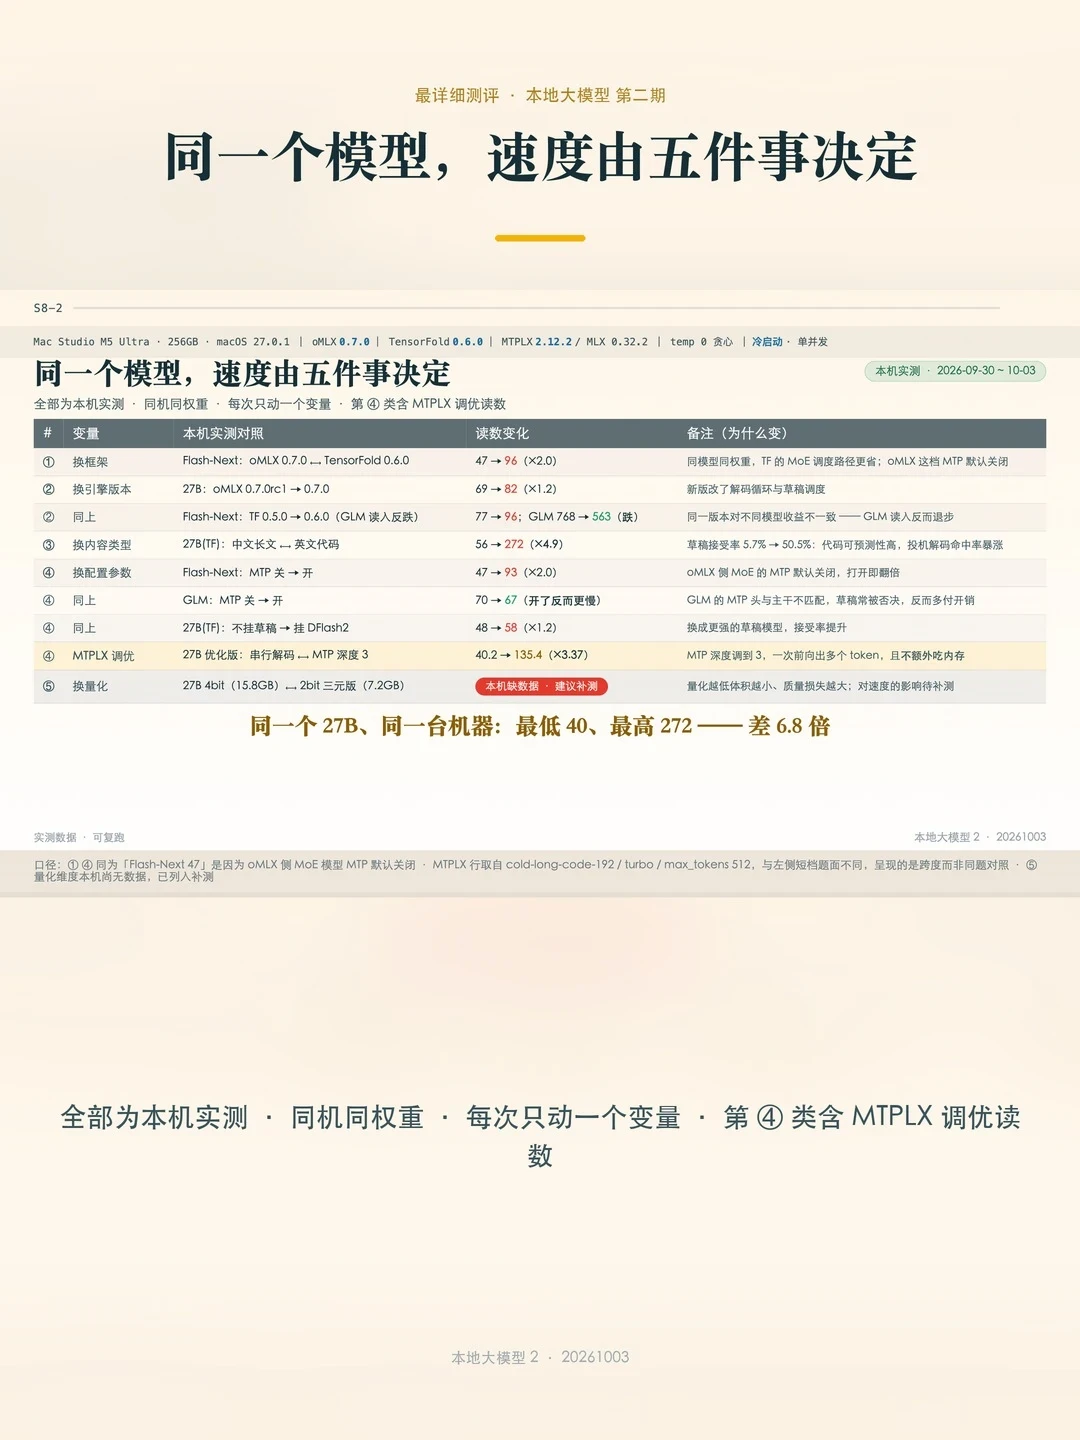
所以顺序是:先换引擎,再换模型,最后才换机器。
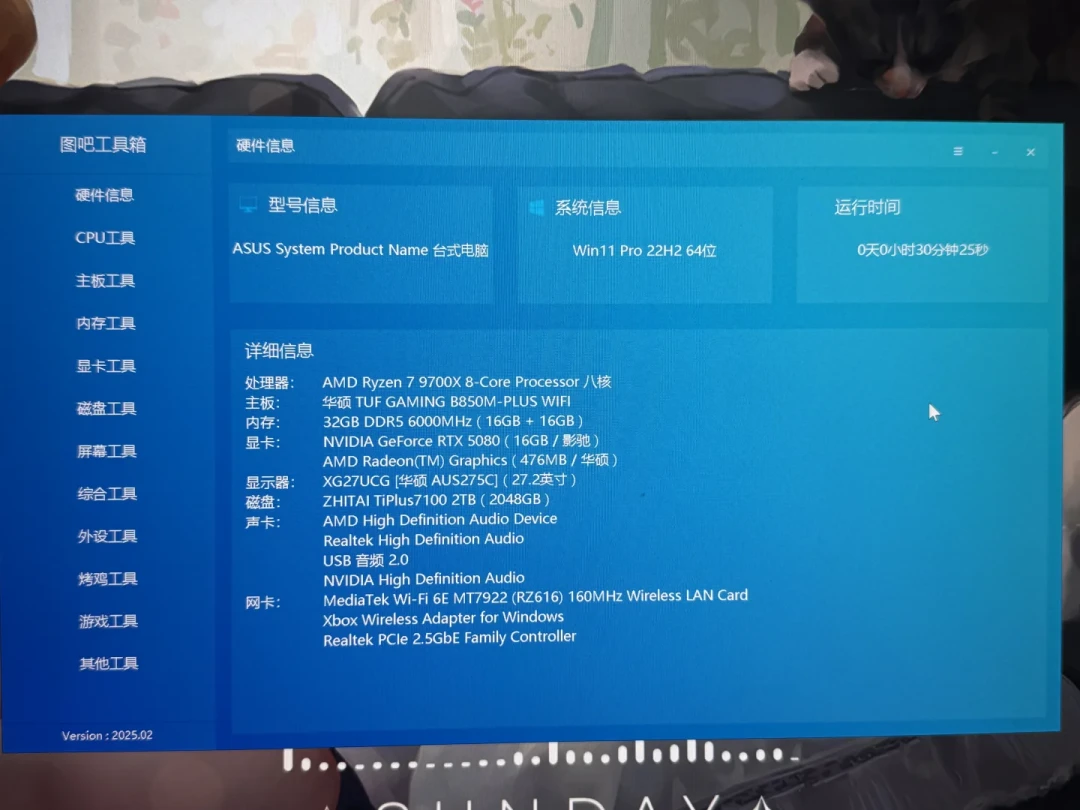
有人自费 3.8 万上 128G Mac Studio,跑完的结论很硬:27B 稠密模型 24G 完全跑不了,32G 只能跑最低 Q4,64G 才流畅。也有人 5080 加 32G 内存装完 Qwen3.8-27B,CPU 和内存拉满还是吞吞吐吐。小红书小红书
本地部署真正的性价比,不是买到多大的显存,而是让模型少读没用的字。先把开场白砍到 2000 token,再谈你的显卡够不够。