Hugging Face 今天(10月15日)推了一场技术直播,主题正好戳在本地党的爽点上——投机解码,官方的说法是“倍数级加速”。不换硬件、不换模型,拨一个开关,机器就快起来,听着像一顿免费午餐。小红书
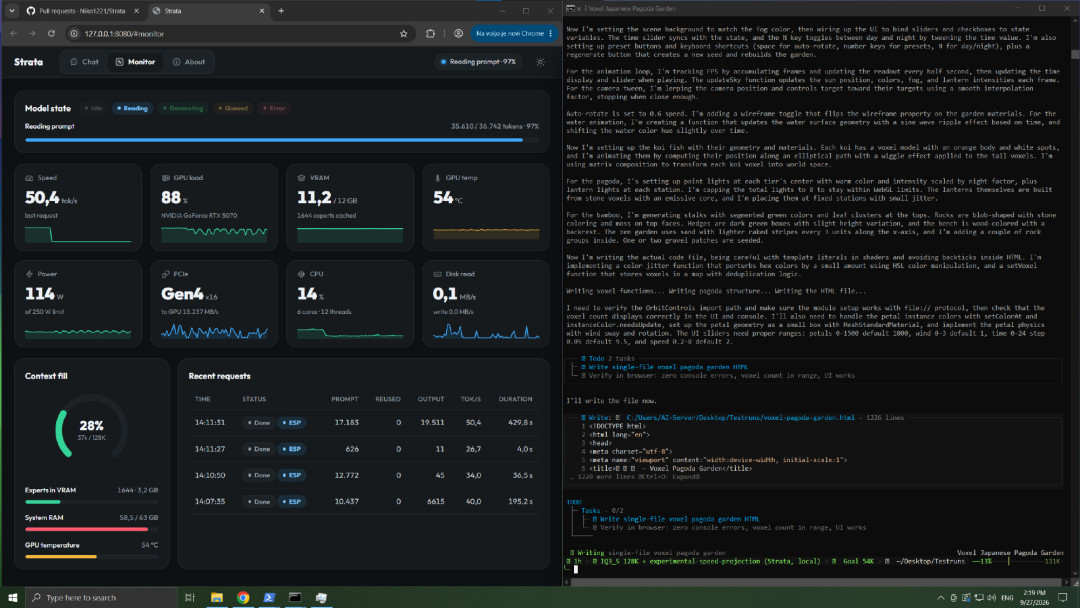
免费从哪来?本地跑模型的生成阶段(decode)不是缺算力,是缺带宽:每吐一个 token,都要把整套模型权重从显存里搬进计算单元一遍,计算单元剩下的时间基本在干等。所以让一个便宜的“草稿器”先猜出几个 token,主模型一次性并行验证——权重只搬一次,摊到好几个 token 头上,额外开销几乎为零。这就是“先猜后验”,也是从2022年论文一路用下来的标准拒绝采样机制:按规则验证,输出分布与不开投机时逐字节一致。知乎小红书知乎知乎
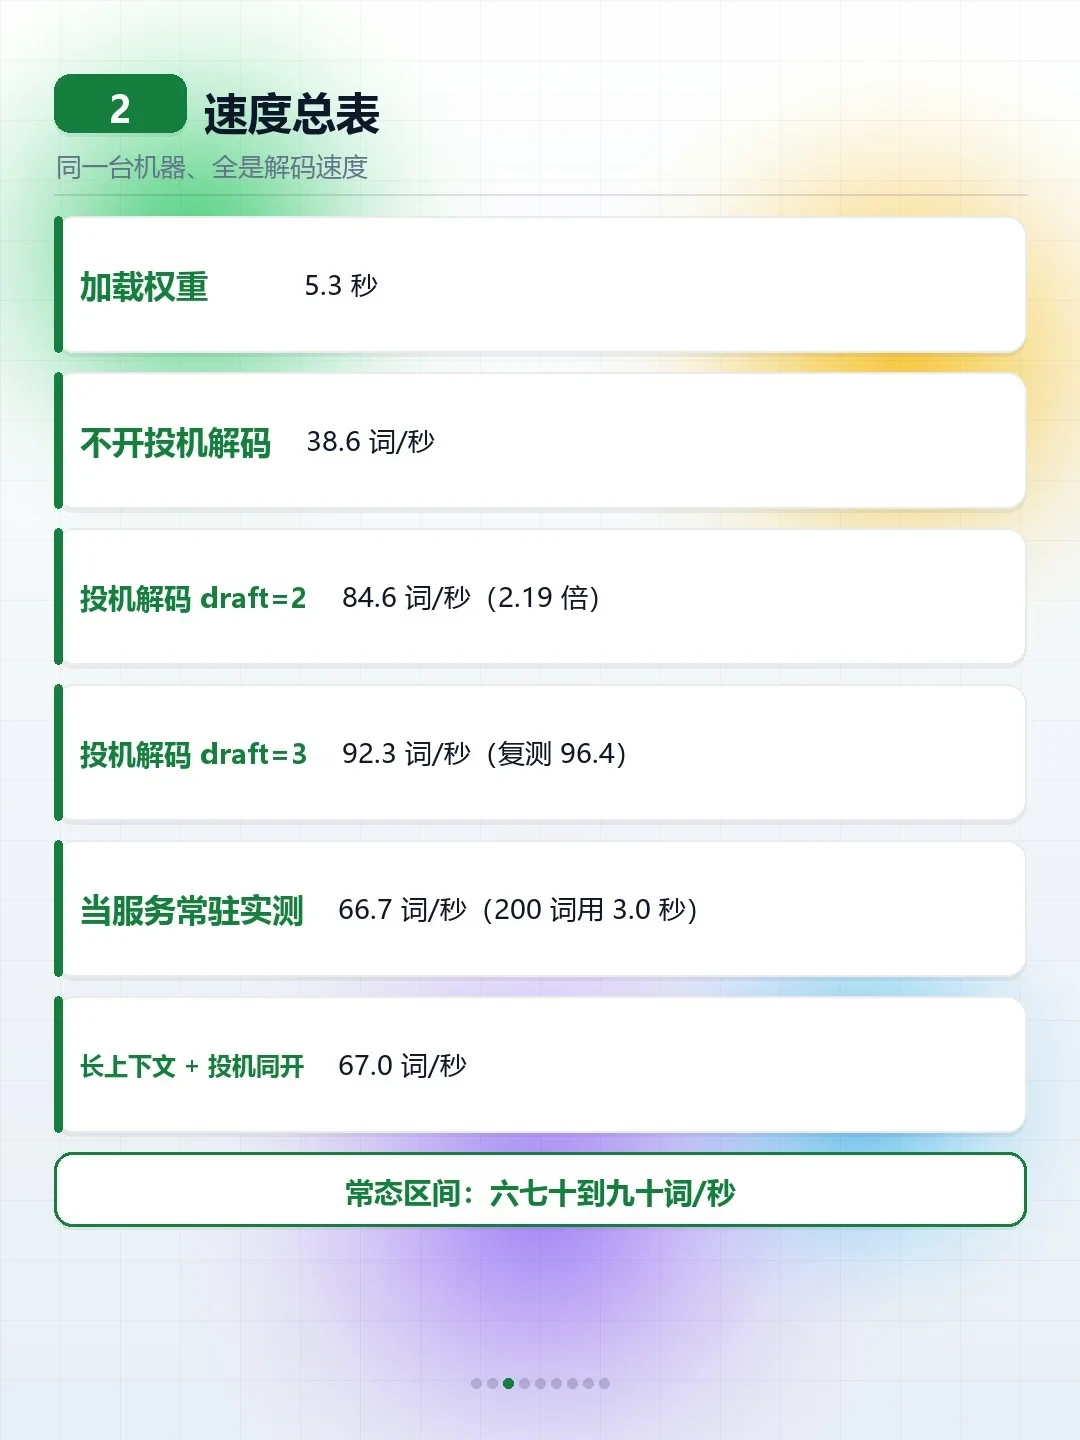
诱人的数字也摆在那。有玩家用 16GB 显存的 5060Ti 实测 27B 三元模型(1.58bit 量化到 7.7GB):不开投机 38.6 词/秒,开投机(draft=2)84.6 词/秒,白捡 2.19 倍。另一篇论文复述里,Qwen3-8B 在十个基准上的平均提速冲到 3.62 倍。B 站的 MTP 本地部署教程上线不到半个月,快 5 万播放、700 多条评论——“8GB 显卡就能跑”,是最勾人的一行字。小红书小红书哔哩哔哩
但手指头按下去之前,三个问题先过一遍。
第一问:你开到多深?还是那台 5060Ti,把投机深度调到 4,速度直接掉到 16.8 词/秒,比不开还慢 2.3 倍——猜错太多,主模型每轮都得返工。猜测不免费,深度有甜点区,多数实测落在 2 到 3。小红书
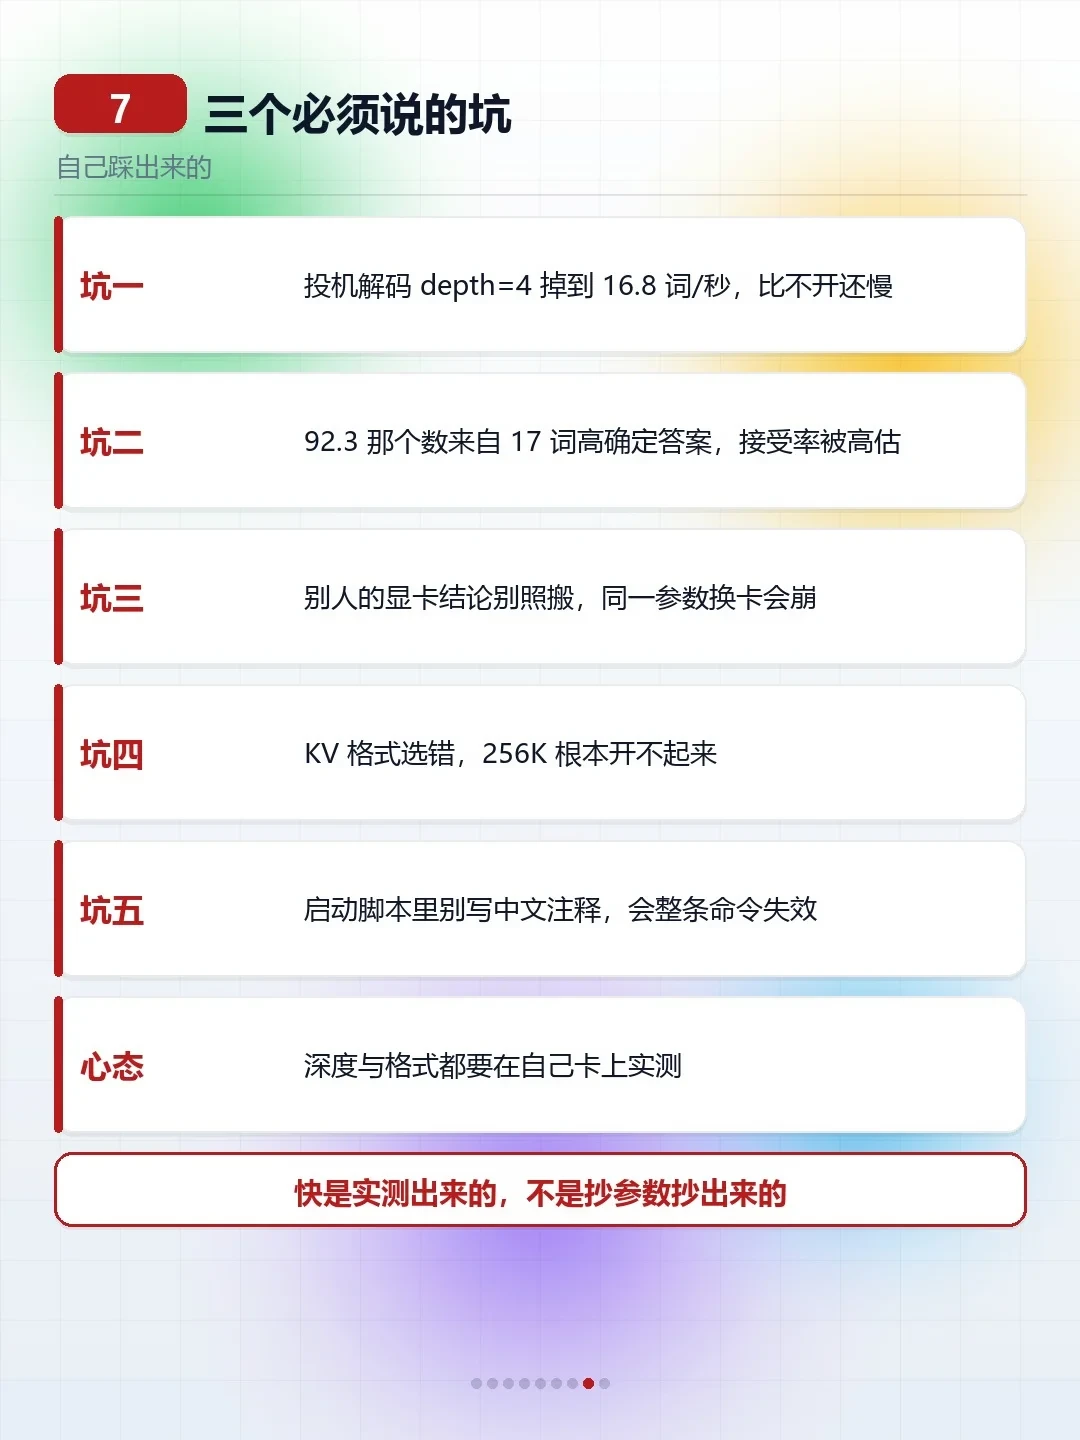
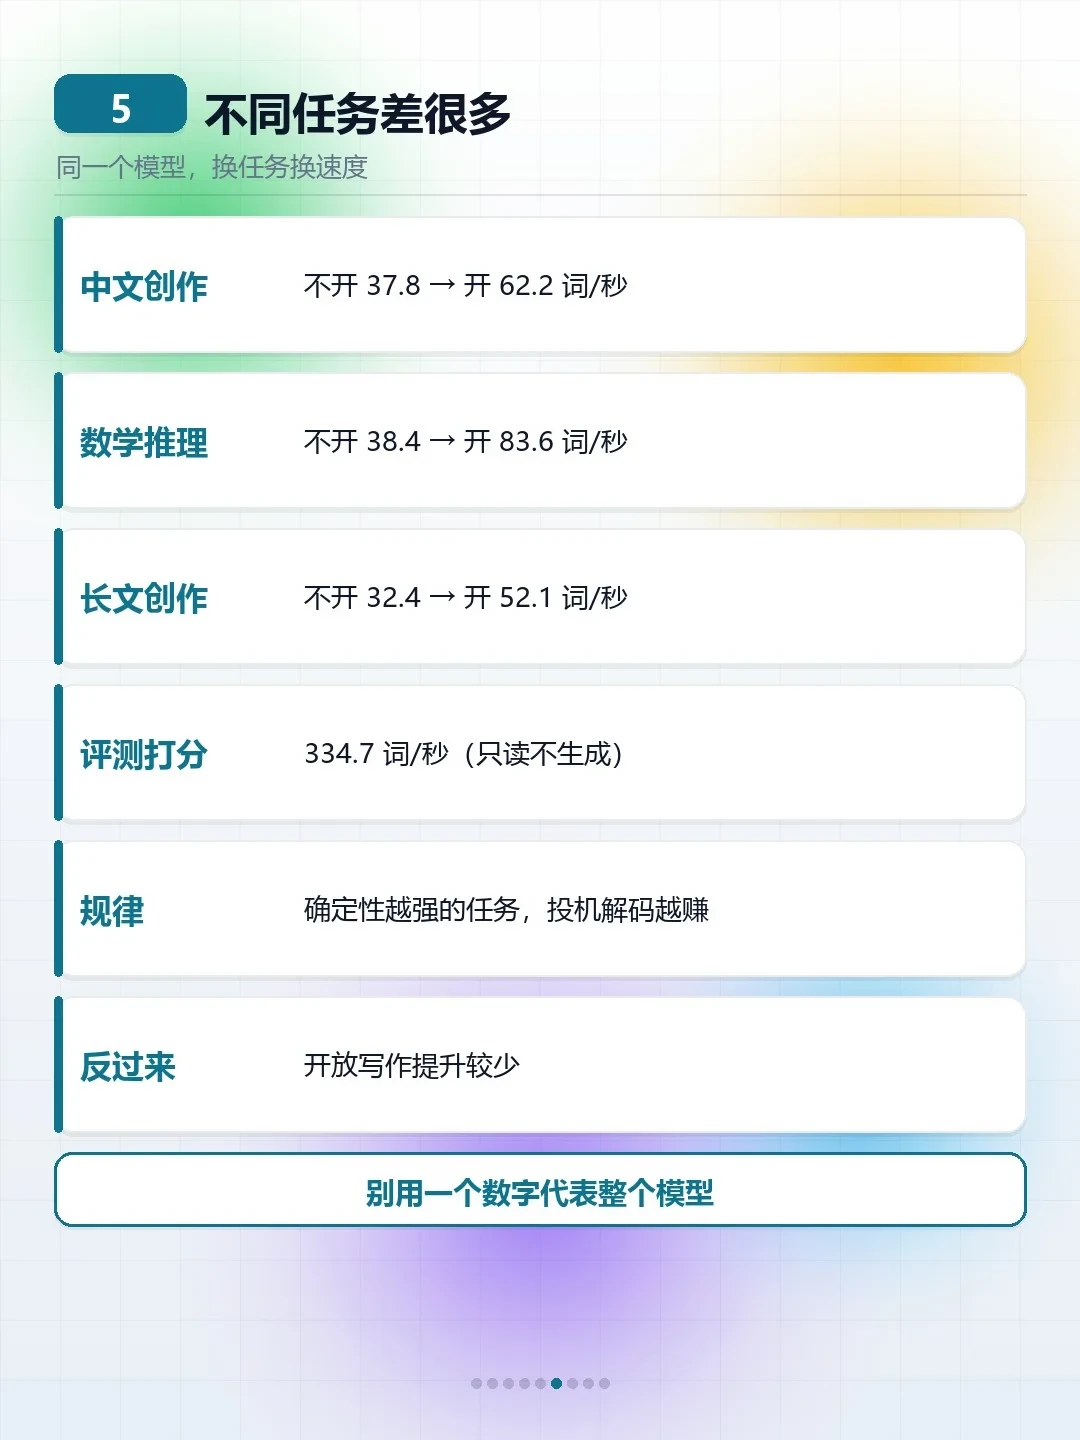
第二问:你拿它跑什么?3.62 倍那种高分是数学、代码这类高确定性任务挣来的,开放式闲聊只有 1.8 到 1.9 倍。而 92.3 词/秒的峰值出自一道只有 17 个词的高确定答案,接受率被题目本身抬了上去,日常内容大约六成。把峰值数字抄进自家聊天框,基本是幻觉。小红书
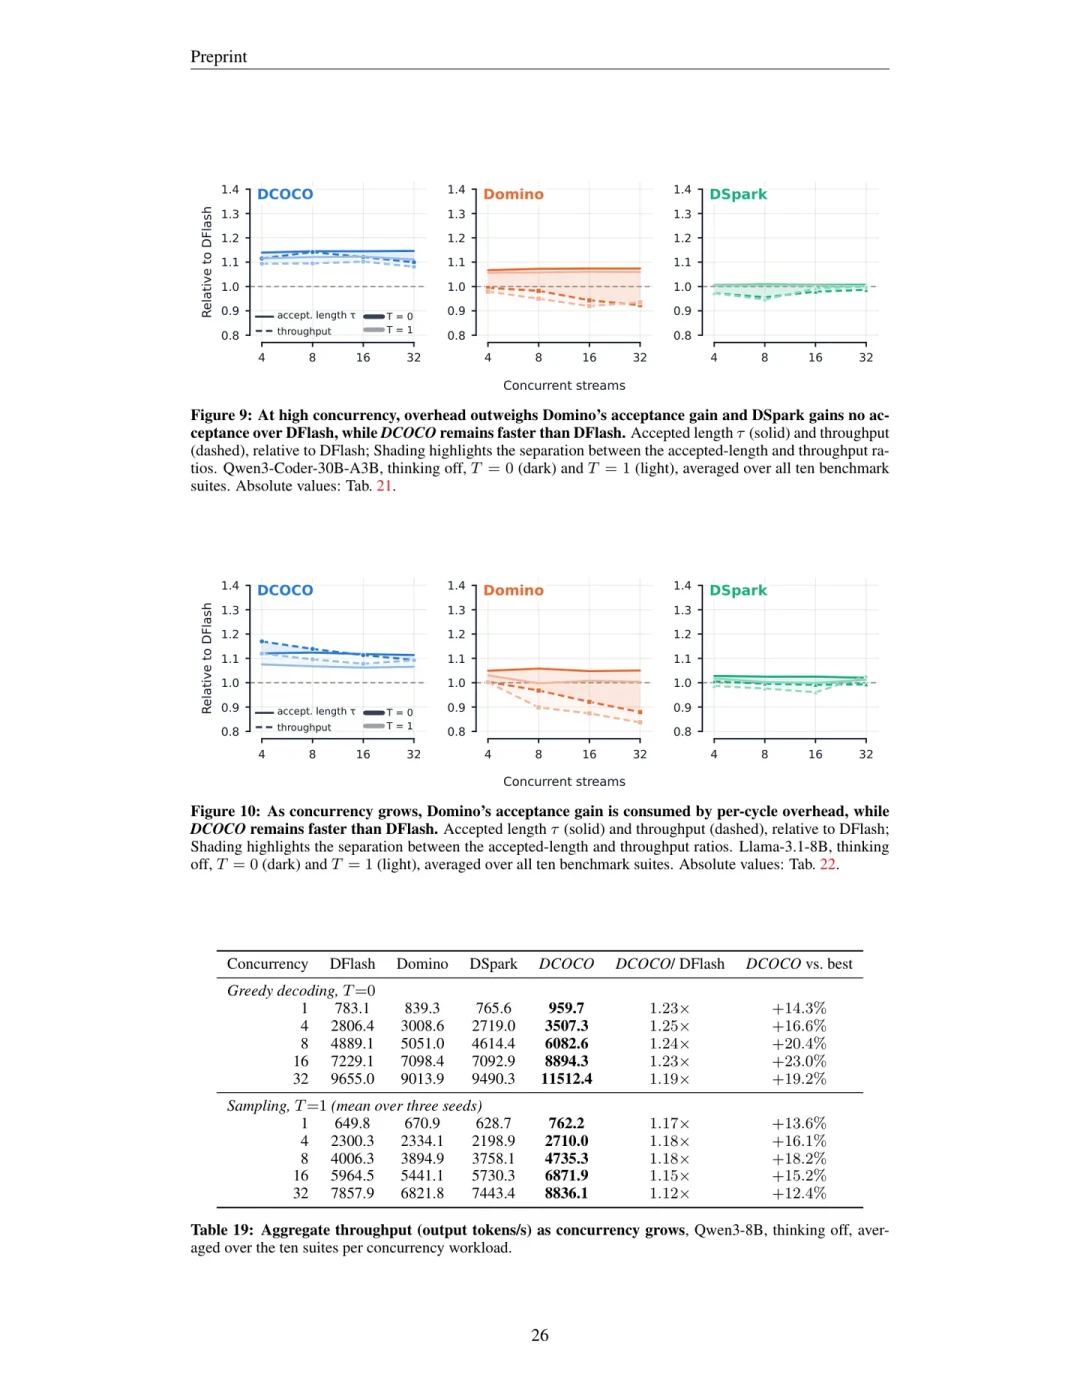
并发也别堆太狠:有人测到 32 路并发时,给草稿器加纠错模块的方案(Domino、DSpark)吞吐反而掉到不加纠错的 DFlash 下面。小红书
第三问,最容易被忽略:你的模型还是原来那个模型吗?提速方案现在流行“放松验证”——10 月初放出的 NSD 论文允许核内草稿直接放行,接受率是涨了,分布也变了:三符号算例里,输出概率从 (0.6, 0.3, 0.1) 变成 (0.8, 0.1, 0.1);HumanEval 的 pass@1 从 84.51% 落到 83.17%。更尴尬的是 Orthrus 的复测:一个宣称“严格无损”的方案,在 BF16 精度下与原模型的输出轨迹匹配率只有 45%,换 FP32 才逐位对上。vLLM 最新的 Adaptive Verification 更干脆,验证前就把预计接受概率低的草稿裁掉——原文也提醒:EAGLE、MTP 这类方案,收益通常小于 DFlash、DSpark。知乎知乎小红书
所以本地党的实话是:8GB、16GB 党还有 Mac 用户,可以开模型自带的 MTP——Mac 上的 Lithos-Metal 甚至宣称在 M5 Max 上把 Qwen3.8-27B 跑到 200+ 词/秒。“慢得能用”确实能变“快得好用”。但接工具调用、写合同、做任何对输出一致性敏感的事之前,先查三样:草稿器是不是模型自带、验证开关是不是标准拒绝采样、提速数字是不是你自己的任务上测的。小红书
免费的提速开关是真有,问题是:你打算先开,还是先测?