51999元,能买一台巴掌大的迷你主机。
半年前这价钱够添台中高端游戏本。现在买到的是铭凡MS-S1 MAX-P495:锐龙AI Max+ PRO 495、192GB统一内存、2TB固态、双万兆网口、三年质保。知乎

这不是孤例。极摩客EVO-X5 Pro卖46999元。阿迈奇F9A把128GB统一内存塞进不到2升机身。联想、七彩虹的同平台机型也在路上。知乎哔哩哔哩
AMD官方说,近期还有超过20款PRO 495新品要上市。英伟达那边,11月10日技嘉AI TOP AERO上市:RTX Spark N1X、约1升机身、最高128GB统一内存——但通稿没写大陆售价,也没提渠道。知乎小红书
192GB解决的不是快慢,是能不能开机
最硬的一点:192GB统一内存真把320B大模型装进去了。司波图在B站实测EVO-X5 Pro,跑通Q4量化的DeepSeek V4 Flash(284B)和GLM-5.3-Flash(320B)。哔哩哔哩知乎
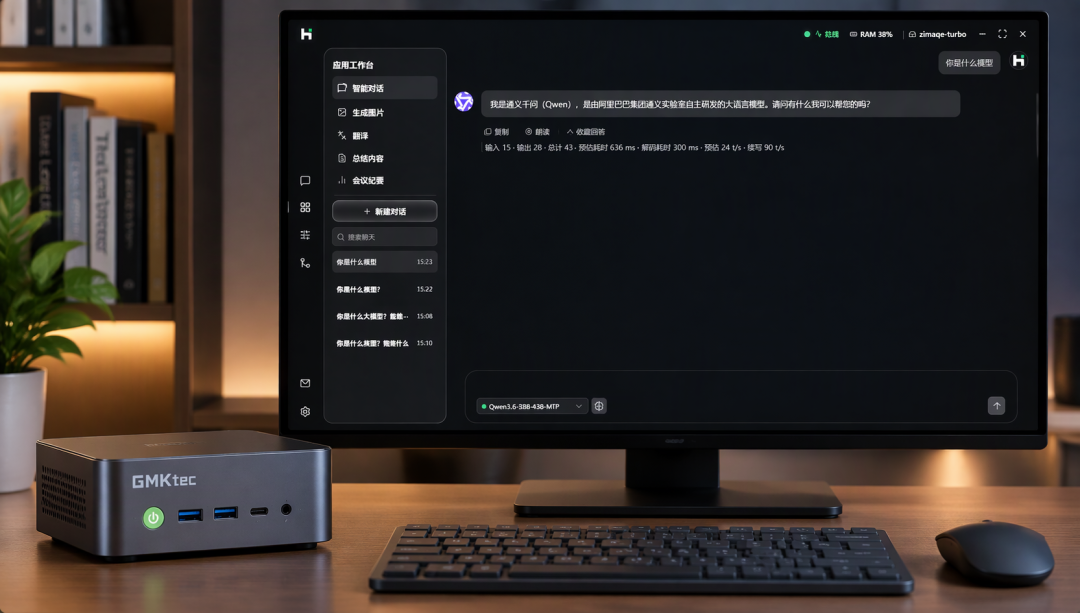
铭凡给的数字:Q4下284B约15 token/s、Q8下122B约27 token/s。但关键对比在这儿:同一个DeepSeek-V4-Flash放到上一代128GB的395机器上,启动不了,权重装不下。内存过线就是能跑,没到就是跑不了,没有“慢一点”这个说法。知乎知乎
小模型上提升更直观:Qwen3.6-35B从62 token/s拉到90 token/s。知乎
三笔账,得自己算
第一笔价格账。铭凡上一代P395(128GB+2TB)还在卖25999元,新款P495(192GB+2TB)51999元,正好翻倍。多出的2万6里既有芯片升级也有那64GB内存——内存涨价的当口,哪部分撑起大头,厂商没说清。知乎

第二笔速度账。硬件一样,软件差出好几倍。有人拿395的128GB主机跑Qwen3.8-27B:ollama只有10 token/s,换成适配过的llama.cpp才到20 token/s。极摩客则预装Herdsman引擎,模型下载、上下文配置、显存分配全在界面点选完成。五万块买的是硬件还是那层封装,因人而异。知乎知乎
第三笔内存账。192GB是CPU和GPU共享的统一内存,不是独立显存——司波图标注,Windows下实际能给模型用约176GB。更要命的是上下文:有人实测35B模型拉满256k,LM Studio里mmap不关,内存占用直接翻倍。“装得下320B”和“开着长上下文还装得下”是两件事。哔哩哔哩知乎
带宽是天花板
PRO 495的内存带宽约273GB/s。Mac Studio M5 Max是614GB/s,两倍多。推理速度基本由带宽决定,284B跑14 token/s是物理现实,软件救不回来。知乎知乎
谁该掏这个钱
数据不能出局域网的政企、医疗、金融才是它真正的客户。EVO-X5 Pro配了dTPM 2.0加密芯片和AMD DASH带外管理,数据全程本地闭环,合规上几乎没有额外工作。省下的不只是硬件差价,还有部署人力。知乎
个人用户得冷静点。一台395的128GB主机跑起模型,GPU功耗从10W瞬间飙到130W,温度从50℃窜到90℃。有位用户算了笔账:自己这台售价约2万元的机器,干的活跟免费云端API一模一样。知乎
他后来改用NPU跑8B小模型——速度掉到10 token/s,但GPU功耗只有12W,温度稳在50℃,风扇根本没转。知乎

逻辑很朴素:本地跑大模型内存起码128GB,32GB和普通笔记本没啥区别。下单前先问一句,自己是不是真需要“数据留在本机”。不需要,这2万6就能省下。知乎