一位开发者给自己搭了套 LLM 网关,所有 AI 调用都从它走。
5 月 20 日到 28 日,9 天,19539 次请求。他把日志导出来,按各家官方价折了一遍,最后停在 65.39 美元。知乎
输入 1810 万 token,输出 849 万 token,缓存读取 20.27 亿 token,命中率 99.11%。
一个月约 218 美元,合人民币 1500 块上下。这是他全部的支出。知乎
对面是一台能跑 32B 的本地机器。24G 显存是底线,二手 4090 一张 1.3 万起步,加机箱电源,整机接近 2 万。知乎
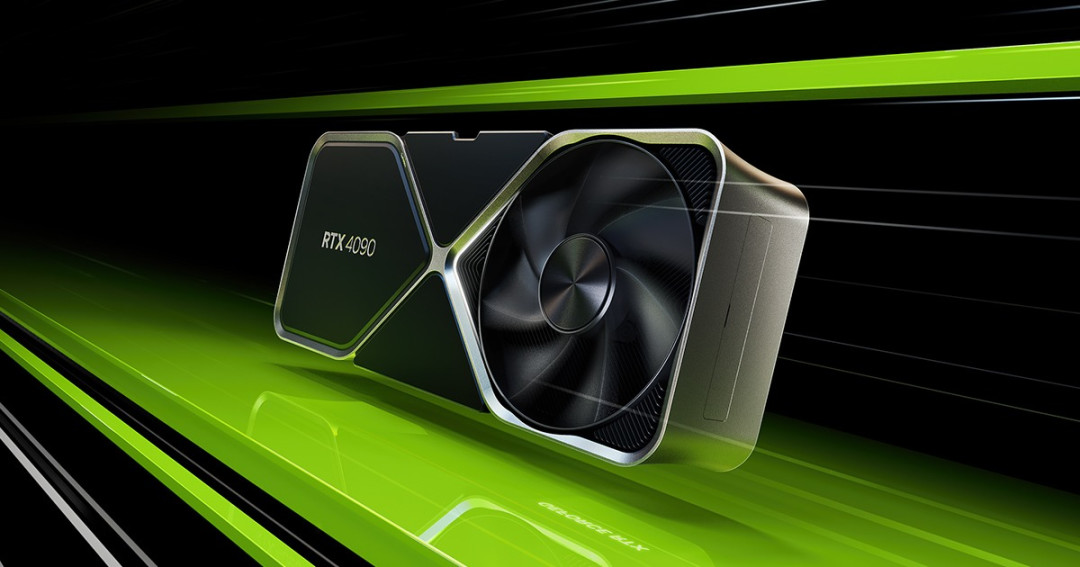
不想买卡,租一张 A10 云 GPU,7×24 一个月 2200 到 3600 元。API 是 1500。
很多人算本地部署的账,只算电费。
3080 Ti 整机满载约 450W。按 0.55 元一度算,一小时两毛五。14B 量化模型跑 30 token/s,一小时出 10.8 万 token。哔哩哔哩
同样这些 token 走 DeepSeek,按最贵的输出价 8 元/百万算,是 0.86 元。电费只便宜六毛。知乎专栏哔哩哔哩
显卡不是白来的。一台 1.5 万的机器,按三年折旧、每天两小时,每小时摊六块八。电费那点优势,一口就被机器钱吃掉。
再算回本。DeepSeek 输出一百万 token,高峰 8 块,空闲 4 块。
一台 1.5 万的机器,30 token/s,出一百万 token 要九个多小时,电费三块多。按高峰价,每百万 token 省近五块。
就算 24 小时不停,也要跑三万个钟头,三年多才回本,这期间还不能换模型。知乎专栏
模型不会等你。新模型半年左右一代,参数往上涨,旧卡只能降精度、砍上下文。
本地跑的多半是量化版。长文本理解、工具调用的掉点,账单上不写,用起来才知道。知乎
你省下的 API 费里,有一部分其实是模型能力的差价。
企业侧更直接。信通院调研说,82% 的企业倾向把大模型放进自有环境;可现场是另一幅画面,显卡进了机柜,模型一年被调用不到五十次。知乎专栏
还有一笔更隐蔽的账:时间。
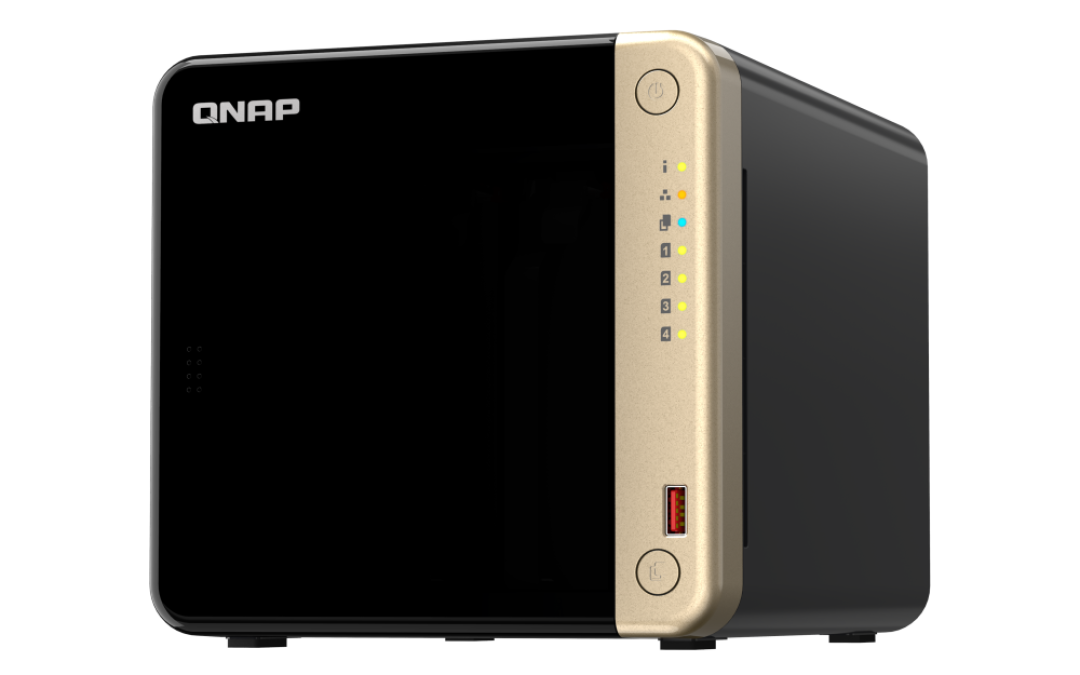
19.53GB 的权重放到 NAS,本机 NVMe 加载 6.5 秒,NAS 上 4 分 47 秒,差 44 倍。一天换五次模型,一个月白扔 8.8 小时。知乎专栏
这 8.8 小时,够你干不少活。
那本地部署是不是就不值得?
不是。它值得的场景,从来不是「省 API 费」。
第一个条件:数据不能出内网。合同、病历、财务底稿,上传云端本身就违规,本地是硬需求,账不用算。
第二个条件:月账单真的高。那位开发者的结论是:「数据不能出内网」和「月账单超过两千块」同时成立,本地部署才回本。知乎
如果只是日常聊天、写点东西、偶尔跑脚本,一个月 API 几十块就够。先买卡,等于把未来几年的预算一次性砸进机箱。知乎专栏
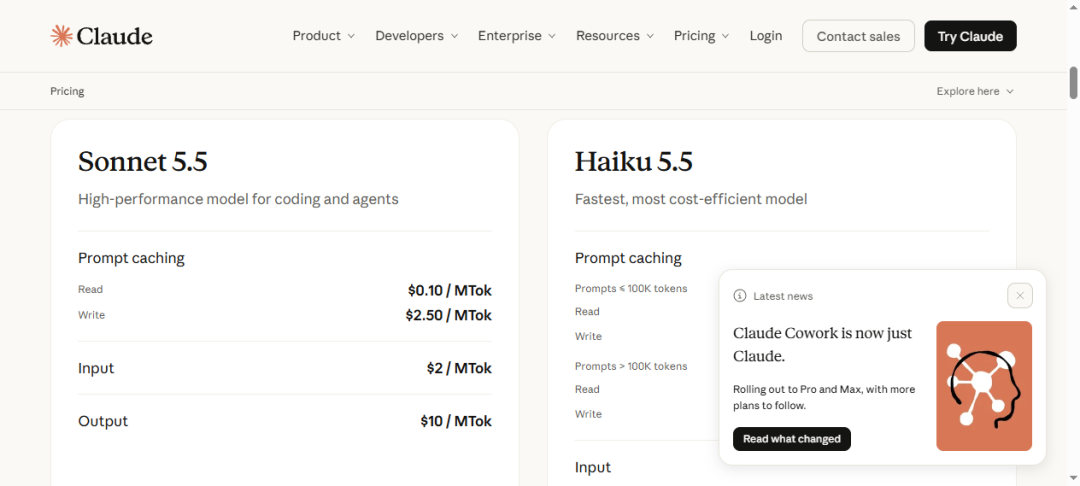
再说,API 账单高,未必是本地部署的机会。同样跑一个智能体,选对和选错模型,输出 100 万 token 能差 1000 倍。知乎专栏
先看看自己是不是拿旗舰模型干了 Flash 的活,再决定买不买卡。
当然,如果你本来就有卡,或者买机器主要是为了玩游戏、剪视频,本地模型只是顺手跑跑,那另说。
边际成本低,玩一玩不亏。但别把它当投资,它不会给你回本。
本地部署真正卖的,不是便宜,是控制权。
模型在你手里,数据不出门,版本不会被厂商下架,价格不会被随时调整。这些东西有价值,但不写在 token 单价里。
所以,下次看到「一次买断,Token 自由」的口号,先问自己两个问题:
数据真的不能出内网吗?月账单真的超过两千了吗?
两个都是「是」,本地部署既合规又划算。数据能出内网、月账单也没到两千,API 大概率更划算。
如果数据不能出内网,本地是硬需求,别拿省钱当理由。