同一台雷神水冷迷你AI工作站,在评测人手里和车主嘴里,是两台机器。
一边是B站35万播放的评测标题:“最高运行235B,本地模型轻松跑”;另一边是另一条实测视频评论区里,一位自费买了锐龙AI Max+ 395工作站的用户留下的话:"70B的模型几token每秒,算了吧,我劝退你,别折腾了,我现在急得都换API了。"这两句都是真话。哔哩哔哩哔哩哔哩
而这台26999元、5月28日发布会后推出、还上过京东"给未面世AI产品众筹3000万"名单的正方体,恰好把2026年"本地大模型"这件事的全部狂喜和全部幻灭,压缩进一个7.9升、6.5公斤的铝块里。新浪微博新浪微博
这篇不写给看热闹的人,写给一类人:已经自己用LM Studio部署过模型、订阅过API、在"上云"和"本地部署"之间反复横跳过至少一回的进阶玩家。你大概率已经知道395这颗芯片是什么、128GB统一内存能划多少当显存;你缺的不是参数,是一张把全网评测、车主实测、二手行情拼在一起的速度表和成本账。
先把事实摆齐:这台机器到底是什么
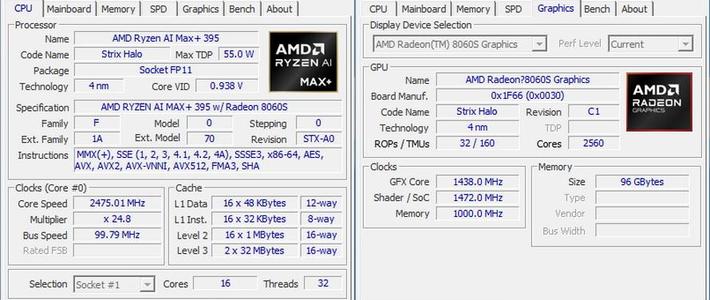
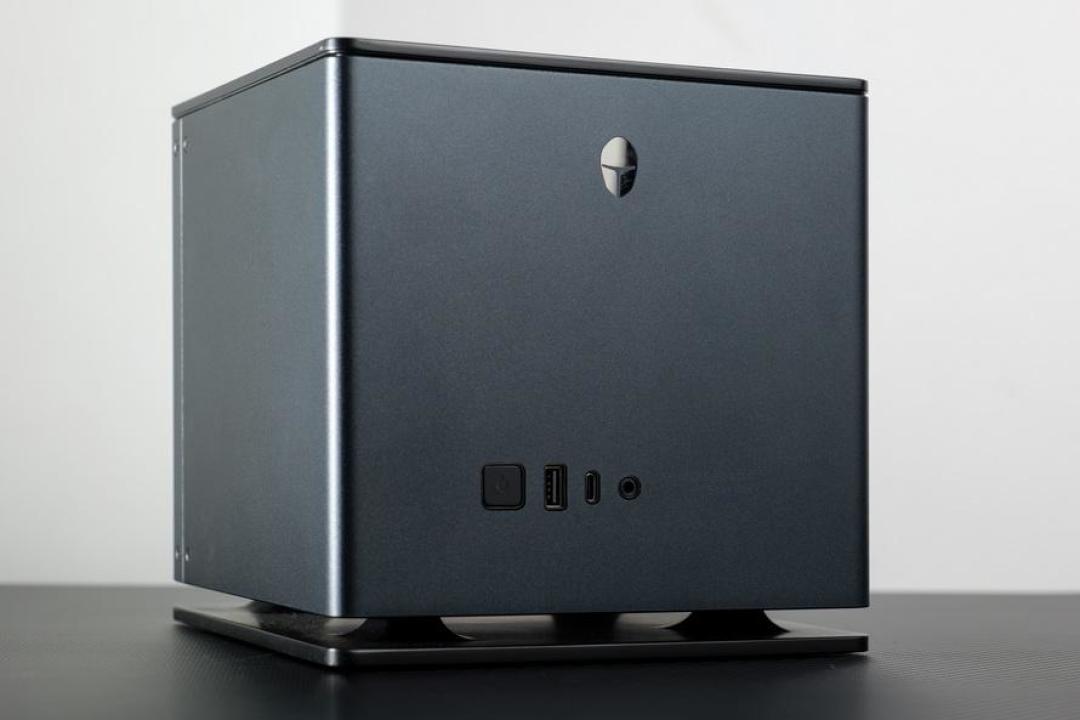
汇总雷神官方5月28日发布信息、IT之家8月开箱、热点科技9月16日刚发的评测和各路实测,这台"Master D3950"正是雷神旗下首款采用水冷散热的迷你AI工作站。 它的硬底子是:知乎
处理器:AMD锐龙AI Max+ 395(Zen 5,16核32线程,5.1GHz,NPU 50 TOPS)
内存:128GB LPDDR5X 8000四通道统一内存,通过AMD可变显存技术最高划出96GB当"显存"
核显:Radeon 8060S(RDNA 3.5,40 CU,2.9GHz)
存储:2TB PCIe 4.0固态(长江存储),还留了第二根M.2和一个2.5寸位
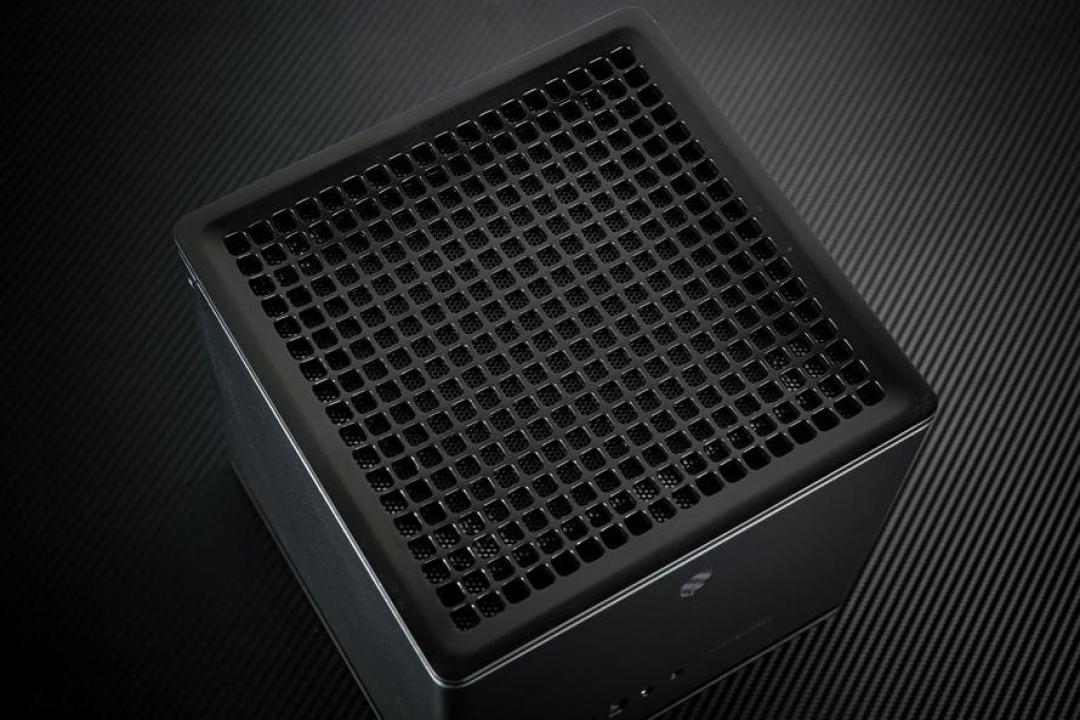
散热:定制水冷,12000mm²岛式全覆盖纯铜冷板、1960cm²冷热转换面积、双滚珠风扇
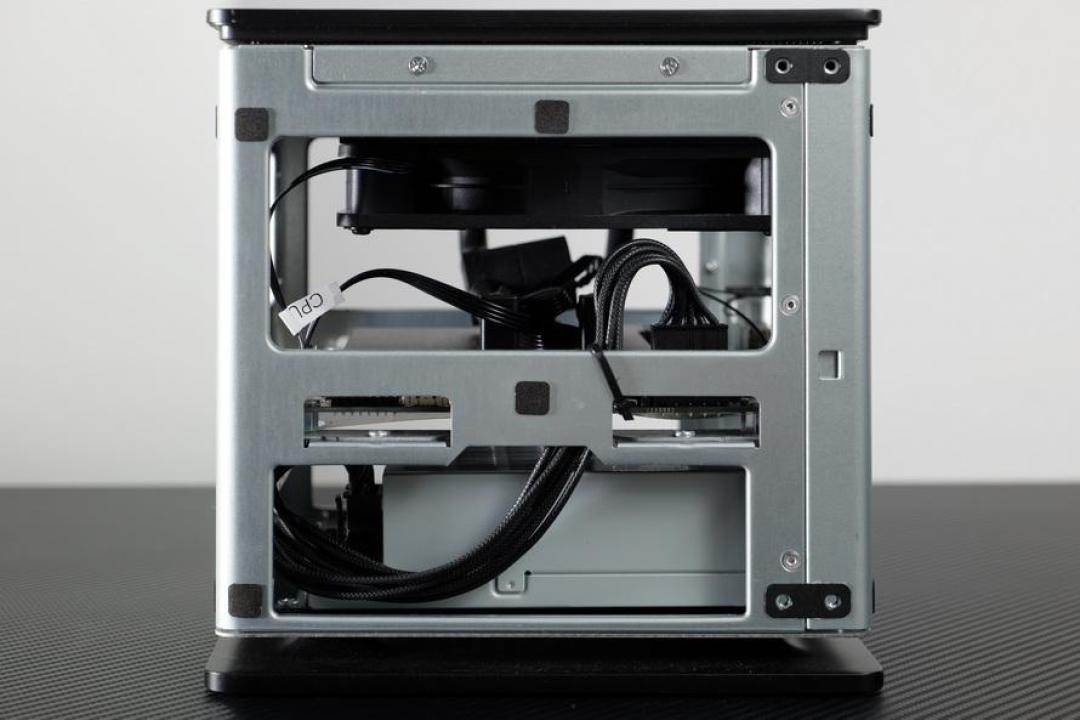
供电:内置400W白金12VO电源,桌面上一根线
接口:2×USB4、2×DP1.4、2.5G+10G双网口、Wi-Fi 7
机身:199mm立方、全铝外壳、约6.5kg,参考价26999元
烤机数据给得很直白:短时176W释放,30分钟后稳定在133W左右,高负载AI核心温度约76℃,主打"长烤不掉速"。知乎
关键矛盾:235B和"几token每秒"为什么都对
这是全网站到现在为止没人替你看穿的一层:评测和车主吵架,是因为他们在说两种完全不同的模型。
这台机器的命门不是容量,是内存带宽。AIDA64实测写入214.25GB/s、复制144.63GB/s——每生成一个token,密集(Dense)模型要把全部权重读一遍。 70B密集模型Q4量化后权重约40GB,理论上限≈40秒读一遍,也就是每秒5个token上下。这就是那位车主"几token每秒"的物理来源,不黑不吹,任何一台395都躲不开这个数学。知乎
而MoE模型每token只激活一小部分参数:官方GPT-OSS-120B实际每token只动约5.1B参数,权重总容量60多GB照样塞得进96GB显存池,速度就能回到能看的区间。评论区一位同样持机128GB内存的用户说得更细:“刚好放得下,质量有保证,唯一的问题是读起来真不够快。”哔哩哔哩
把四个独立信源的实测拼成一张表,结论就很清楚:
7B-8B密集档:UL Procyon实测31.67~58.45 tokens/s(Llama 3.1/Mistral 7B/Phi 3.5),和云端小模型对话体感相当。知乎
100B级MoE档:装得下、能用,输出"说得过去",读取速度是短板;
70B密集档:理论上勉强,实际上劝退;
235B档:宅同学实测最高能跑(大MoE量化),但那是"能演示",不是"能日用"。
证据能覆盖的就到这里:没有任何一个来源给出120B档的精确tokens/s数字,只有热点科技丢进218页年报、上下文开到131072、内存加显存合计过100GB后"结论照样很快给出来"的体感描述。 谁拿"支持235B"当卖点跟你报精确速度,直接当成商单处理。知乎
26999的溢价买的是什么,划不划算
6月知乎那篇统一内存主机横评给过行情锚点:同样128GB统一内存的产品,京东在售超过10款,价格两万到三万七,叠上补贴最便宜的"两万出头"。 雷神这台26999,比395裸机小盒子的地板价贵了大几千。知乎
贵的部分拆出来是三样:水冷换来的持续释放和7×24不降频的稳定性;内置400W电源、10G网口、全铝机身这些"能不能上桌"的细节;再加品牌售后的兜底。B站评论区点赞最高的一条说得直白:“价格取舍罢了,它的价位在2万自然会给你上好东西”;但同一层楼下面就是那句"这个价去年够买两台其他品牌的了"。哔哩哔哩
那台便宜的同芯片机器买不买?看你的负载形态。本地大模型推理和7×24挂Agent不是一个东西:偶尔跑一晚上,便宜风冷盒子够用;打算让它常年转着做文档检索、定时任务、24小时AI助理,安静和不降频才是这台水冷的核心资产。"静音这点直接戳中我痛点"那条留言不是水军,是宿舍和合租房投出来的票。哔哩哔哩
另一笔是云API的对照账。蹲闲鱼AI硬件的那位技术人给过重度用户的体感:API"一个月几百块打不住";而反方的算盘同样响:“2万你能烧多久的API”,本地量化模型"被DeepSeek V4 flash从性能和token速度上爆杀"。 两笔账合起来才是完整判断:这台机器不是用来"替代API"的——论聪明和速度它现在都做不到;它买的是数据不出门(企业私有化、稿件、病历、法务材料)、断网可用、以及高频长上下文调用不烧token。如果你的需求清单里没有这三条里的任何一条,26999就是纯信仰充值。知乎
反证和坑:下单前没人告诉你的三件事
第一,生态。"395是个坑,rocm生态如同残废"是车主原话,不公允但也不是空穴来风:LM Studio对部分MoE模型的工具调用支持仍有问题(评论区开发者原话),llama.cpp/sglang之外你要自己踩坑。 这机器买回来第一周的使用体验,一半取决于你折腾开源推理栈的耐心。哔哩哔哩
第二,二手渠道。同品类的前车之鉴:有人蹲了两周闲鱼上的DGX Spark,3999美元的官方价、国内无正规渠道,结论是"AI硬件这个品类,已经被贩子占领了"——AI硬件新品的闲鱼已经被贩子和"代购"占领,雷神这种有正规渠道的机器反而不建议去闲鱼"捡首发退坑机",保修和取送政策都跟渠道走。知乎
第三,需求本身。两条高赞评论其实替大多数人说了话:“绝大多数人没有本地部署的需求"和"只适合AI创作者,普通用户慎入”。 这句话该反过来读:正因为泡沫大,才更要把评测的"轻松跑"翻译成你自己那个模型的速度。哔哩哔哩
结论:三买三不买,加一个观察清单
值得买的人:一,有明确数据敏感场景(客户资料、私有代码、自媒体未发内容),必须本地跑;二,负载是100B级MoE或7B-8B日用档,且要7×24挂机,安静+持续释放就是产品力;三,把这台机器当"能上桌的工作站"而不是性能堆料,10G网口、双USB4、内置电源用得上。
不值得的人:一,指望它替代云端旗舰模型做日常问答的;二,非MoE大密集模型不跑的;三,预算卡在两万、又不需要长期挂机的——同芯片便宜盒子或者先租两台云端实例,都比它划算。
接下来盯三个信号:Master系列后续促销价会不会跟随395阵营的"两万出头"地板往下压;Q4雷神移动AI工作站M7000和各家新硬件把"本地能跑"的门槛推到哪;以及开源社区对GPT-OSS、qwen-122B级MoE的推理优化速度曲线——这台机器的真实使用寿命,取决于后者比取决于雷神更多。
评测停在"235B轻松跑",车主喊的是"几token每秒快跑"。中间的落差,就是这张速度表。看懂它,26999是工具还是智商税,你自己就能判。