

2026年AI应用全面普及,很多老旧电脑都被认为彻底淘汰、跟不上时代。我手上这台2019年惠普老台式机,原本准备整机置换换新,没想到简单低成本升级后,直接变身稳定可用的家庭本地AI服务器。
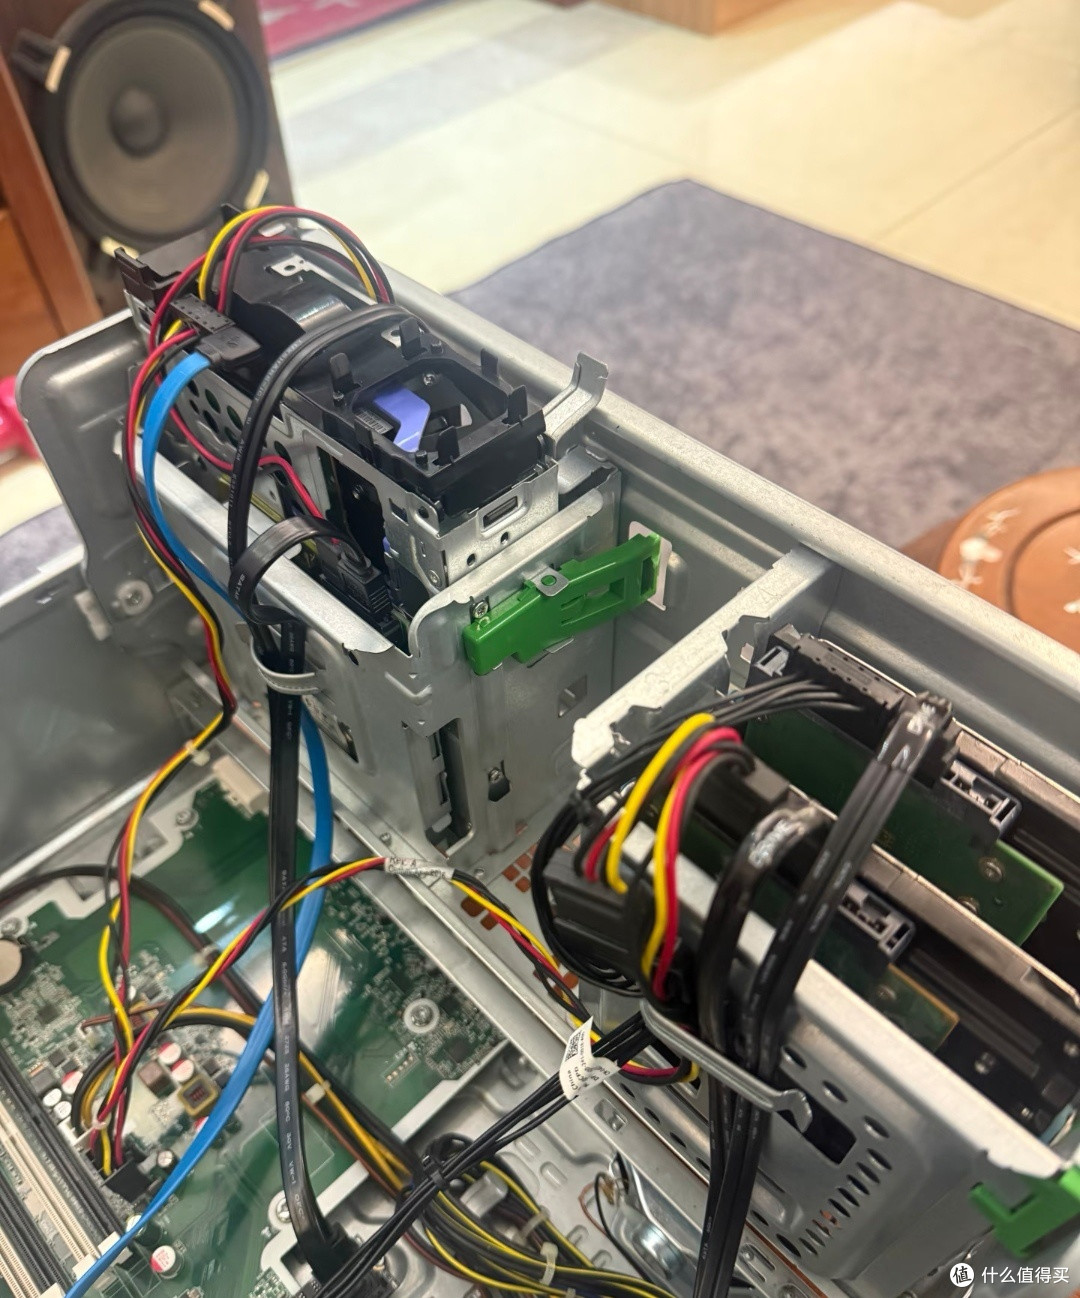
本次改造目标非常明确:本地部署DeepSeek-R1 7B大模型,主打日常文案创作、逻辑推理、问题答疑、代码辅助学习,所有数据本地闭环、不上传云端。
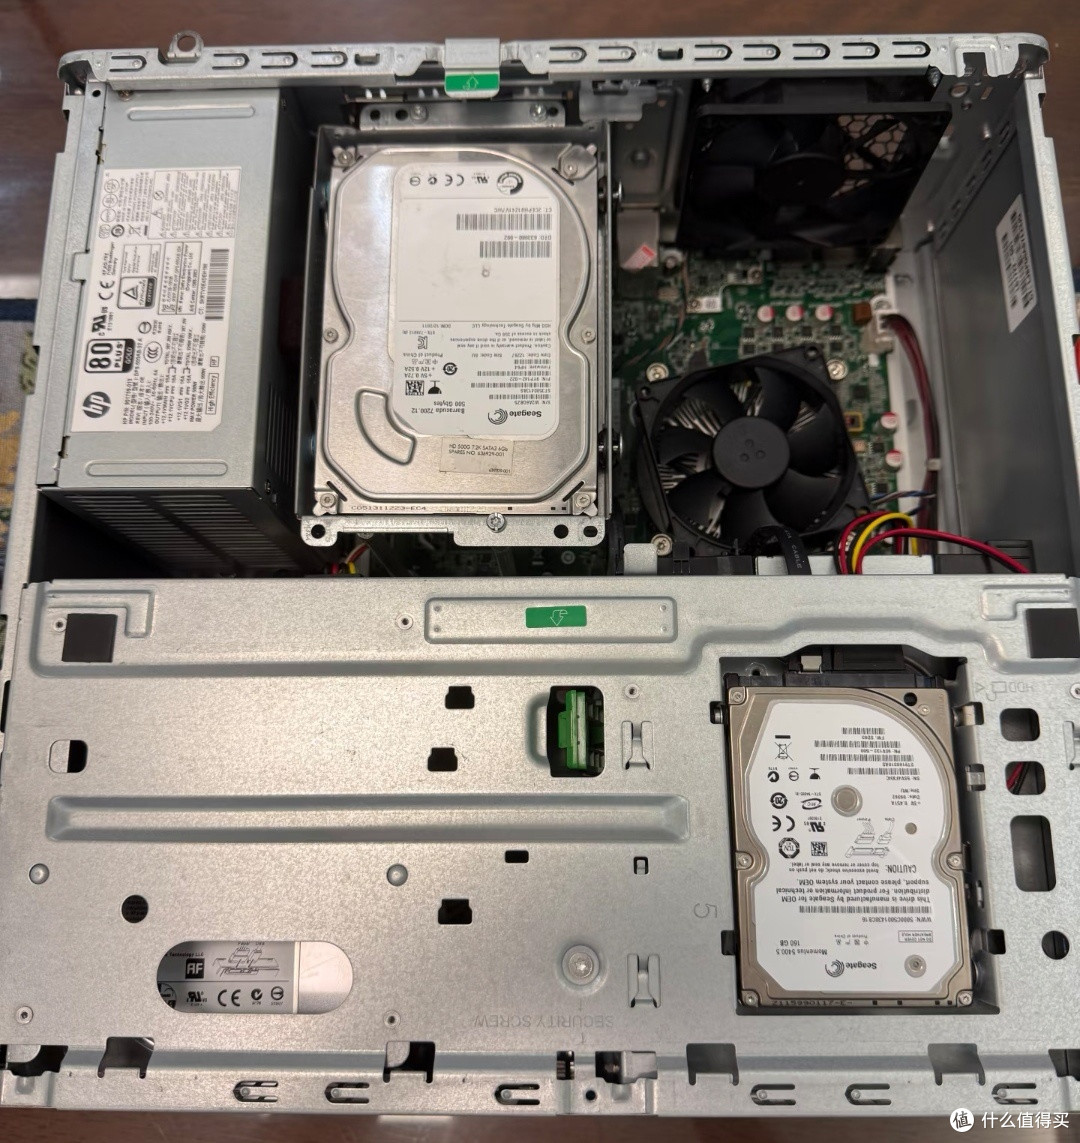
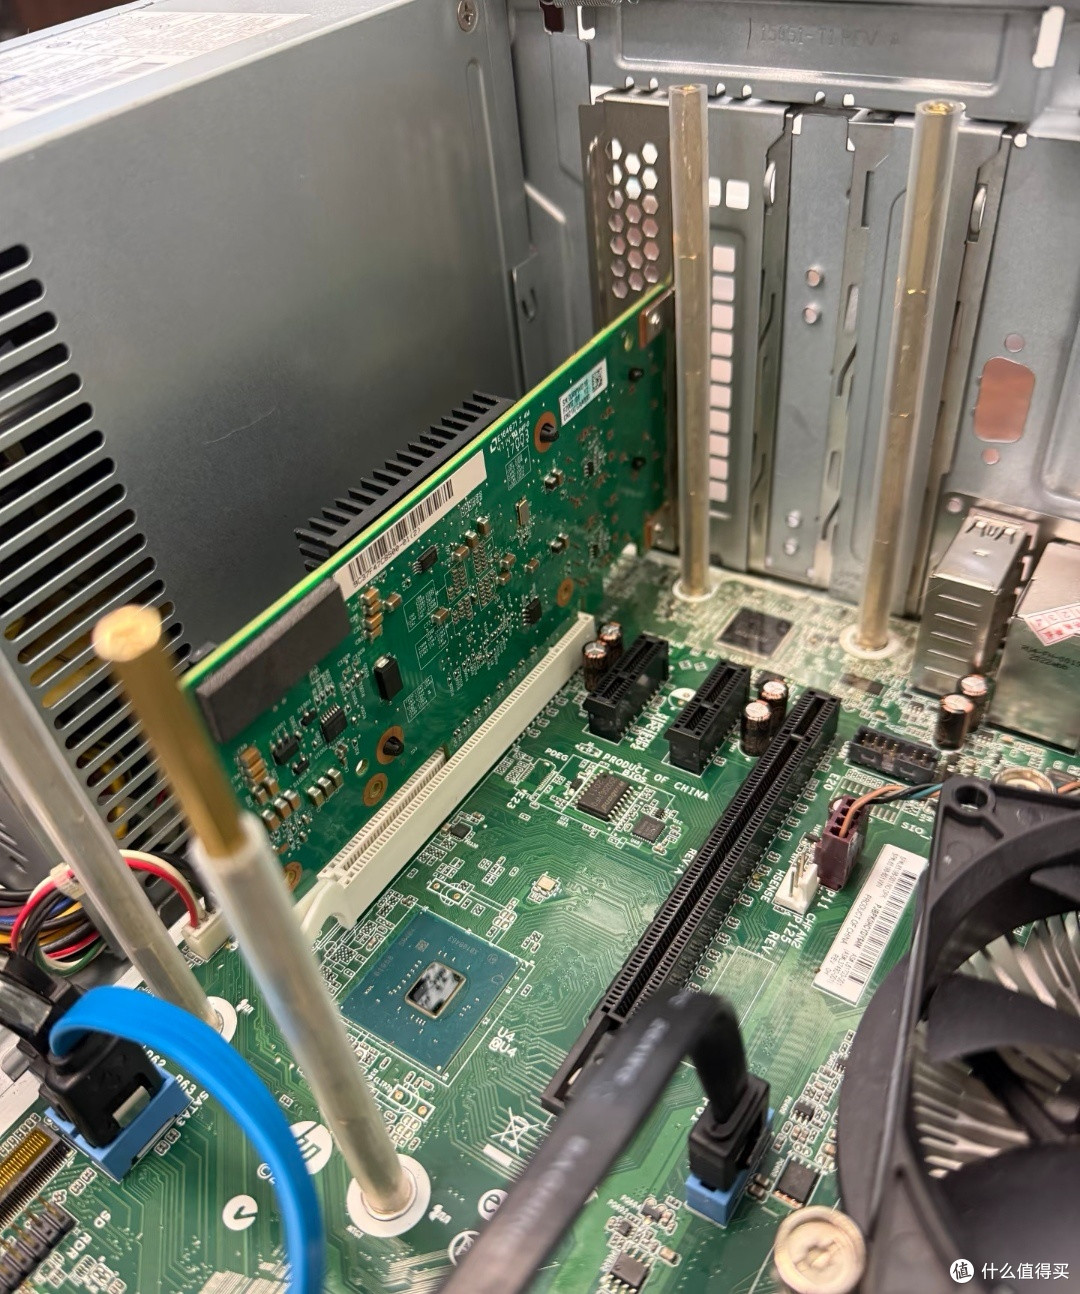
硬件底子方面,GTX1660 6GB显存完美适配7B级开源模型。在开启INT4量化压缩模式下,显存占用可控、不爆显存,稳定推理速度可达4tokens/秒左右,完全满足家用轻AI场景,日常问答、文本整理、简单推理足够流畅。
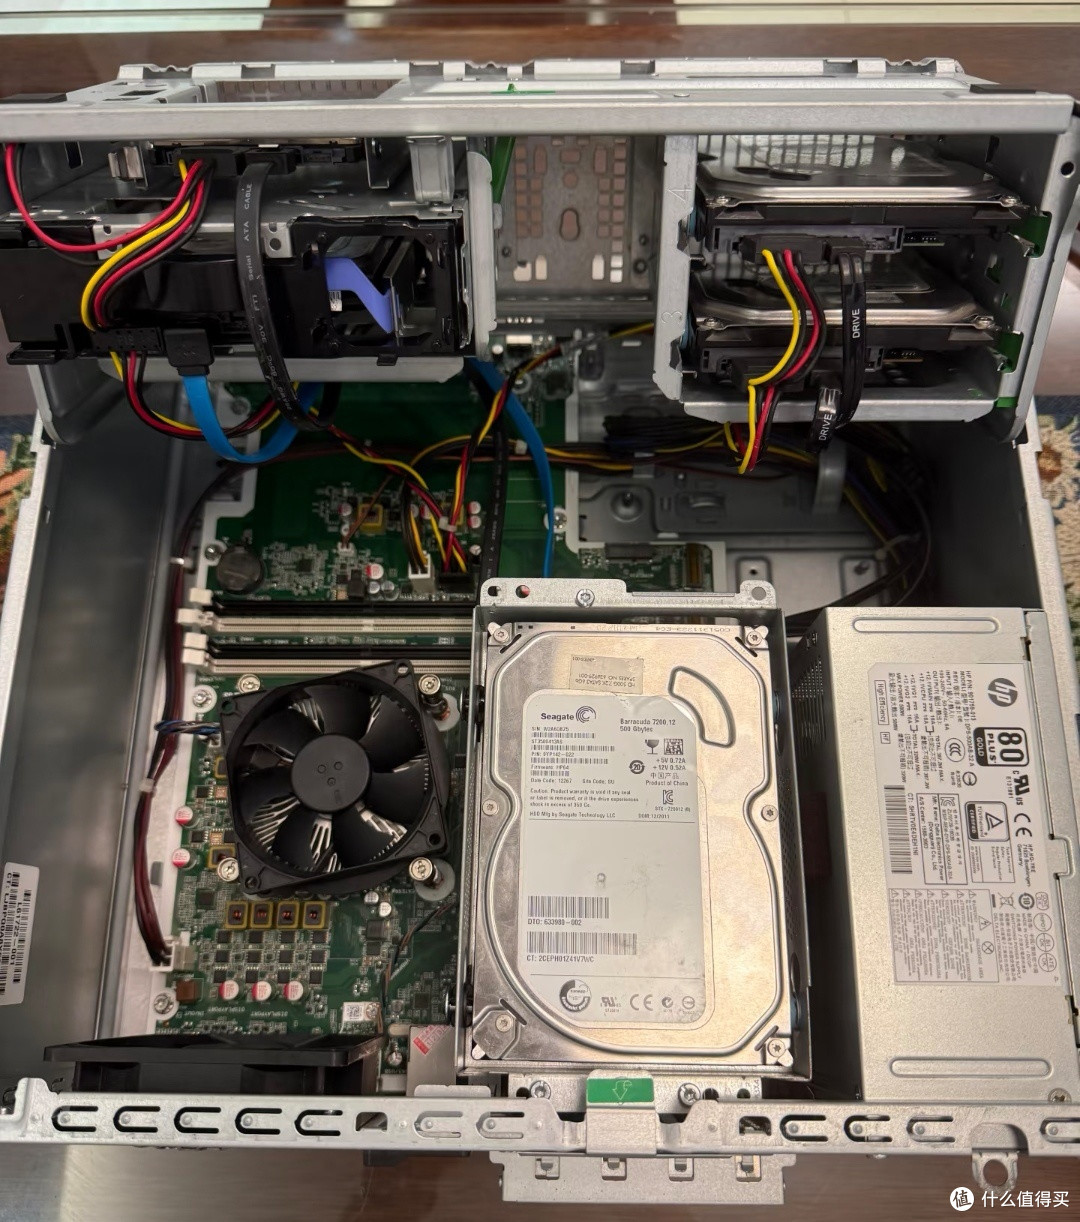
为了让机器支持24小时不间断AI驻机运行,我针对性做了两项低成本升级。原机自带16G内存,我加装一条16G DDR4二手原厂内存,整机拉满32G大内存,后台多任务、长文本读取、上下文加载不再卡顿,整套升级仅花费140元。
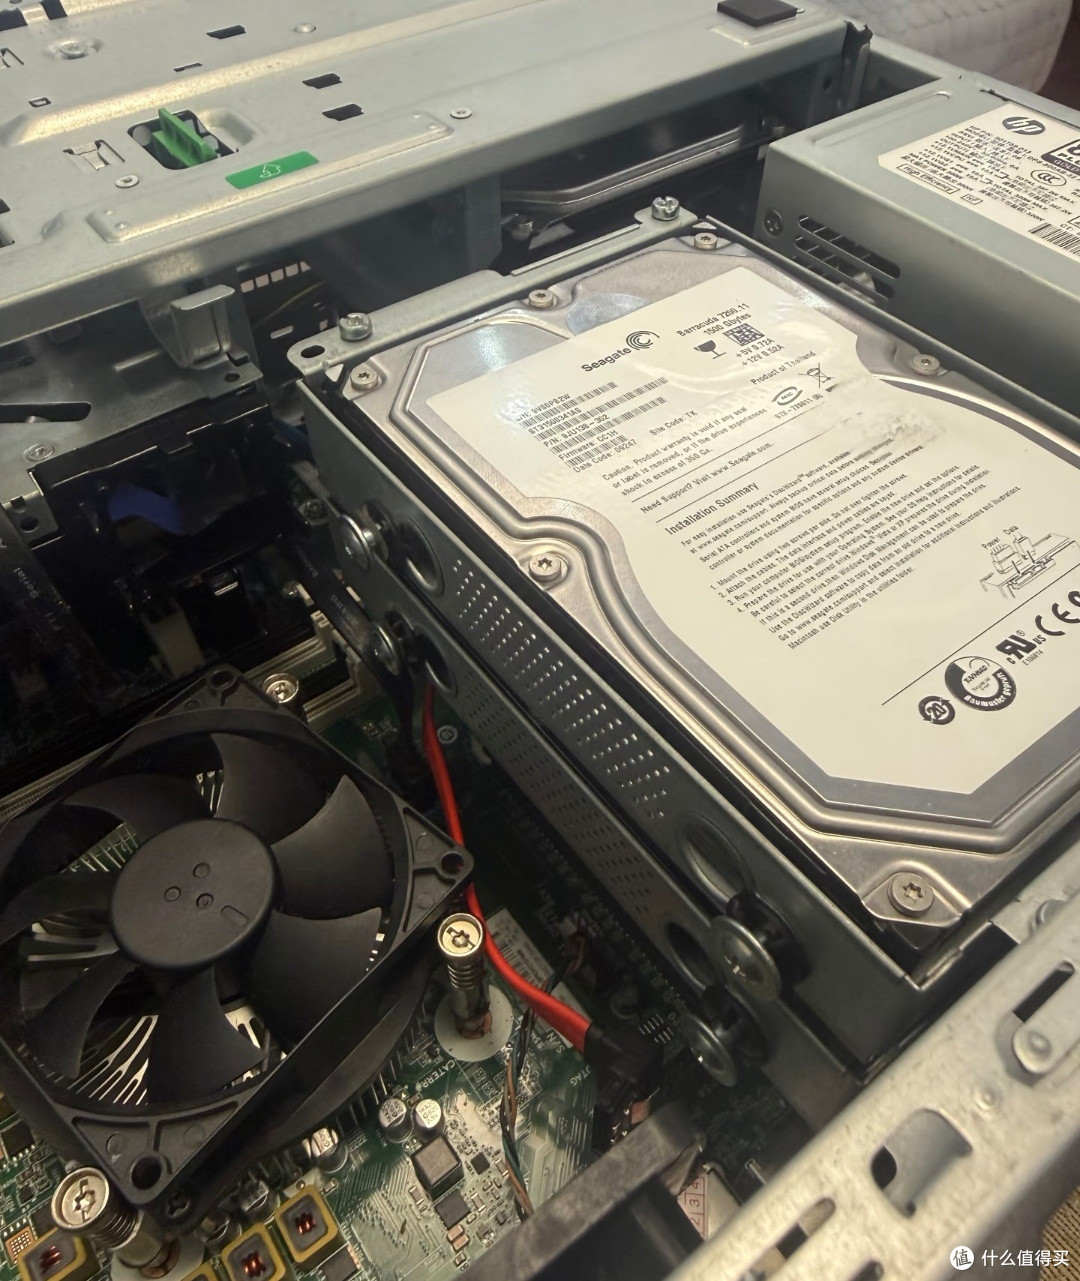
原机自带品牌电源功率偏小,长时间AI满载容易降频、重启。我更换550W 铜牌静音电源,整机供电更稳定,满载电压不掉档,全天候挂机运行零宕机,全新电源花费280元。整套升级总成本仅420元。
系统采用Ubuntu24.04 LTS纯净服务系统,通过Docker容器部署Ollama运行框架,一条命令即可拉取DeepSeek-R1模型,部署门槛极低、小白也能上手,后台占用低、运行稳定。
实测效果非常惊喜:长文档解析、万字文本总结仅需80秒左右,代码答疑、逻辑分析、短句生成基本秒响应,延迟极低。
2026年早已不是新电脑才能玩AI的时代,只要显存6G以上、支持CUDA加速的老显卡,都能轻松跑通量化7B模型。
几百块的小改造,让一台即将报废的老商用主机,变成了全年无休的私人AI服务器。不用开会员、不限次数、隐私绝对安全,真正实现旧设备在AI时代的价值重生。
420元把老台式机改成AI服务器确实划算,GTX1660跑7B量化模型速度还可以,不过4tokens/秒碰到长上下文会不会掉速?
7b都没法用
然并卵
4 token/s 速度真的没法用
4token能用?

7B也不是DeepSeek,是用DeepSeek蒸馏的Qwen,不如搞个Qwen3.5的4B,效果还好,还快
看得很过瘾。
7b的量化,还搭配4t的速度
很有实际意义。
7B能做什么?练耐力?
这类软文的最终目的,不是让你“升级家里的老电脑”,而是让你产生一个错觉:“原来6GB显存的旧显卡就能跑AI了啊,那我去咸鱼淘一张GTX1660/RTX2060 6G也不亏。” 然后咸鱼上那些原本只值300块的GTX1660,就会因为“AI入门卡”的标签被炒到500+。这篇文章就是给这批即将涨价的电子垃圾,提前写好的“使用说明书”和“价值背书”。 4 tokens/秒什么概念?正常对话,一个字一个字往外蹦,速度大概跟人正常说话差不多。处理长文档,号称“80秒解析万字”——那是单次推理,一旦上下文积累到几千字,推理速度会断崖式掉到1-2 tokens/秒,等得你怀疑人生。 而且GTX1660的6GB显存跑7B量化模型,刚好在爆显存的边缘反复横跳。稍微开个长上下文就卡死,必须重启服务。“家庭AI服务器”听起来美好,实际用起来就是一台“只能聊五句的天才儿童”——第五句之后就开始装死。
AI只用Gemini
总结得很好。
真心不错。
性价比高
没有更多了