这一轮Qwen3.8刷屏,本地党卡住的点特别统一:不是"装不上",是"太慢"。27B开源两天,Hugging Face下载破百万、登上全球趋势榜第一。 那个23.7万浏览的知乎问题里,高赞回答说它是"今年最令人意外的成果",但出现频率最高的抱怨也是同一个——思维链太长:官方榜单页上明晃晃写着出字44 tokens/秒、首token要等49.06秒。慢的真正大头,不是你的卡,是官方默认替你把"思考模式"打开了。 这三本账,我按可核读数对完再决定动哪个开关。知乎小红书
第一本账:速度账——44t/s没读错,是它开口前先"内心戏"了49秒
小红书博主"野生工程师"10月18日发了一份很难得的实验:单张3060、串行请求、2511条真实日志,把Qwen3.8-Flash的输出预算怎么被偷吃的全过程扒了出来。 极端样本是一次298秒的纯思考,正文字节数为0。他把开关拨到 reasoning_effort: none 之后同一台机器复测:小红书
对照项(max_tokens=512) | 开思考 | 关思考 |
|---|---|---|
1500上下文 到首个正文 | 14.6秒 | 3.4秒 |
8000上下文 到首个正文 | 20.3秒 | 11.6秒 |
32000上下文 到首个正文 | 没有正文(512个token全用在思考上) | 45.9秒 |
上下文压缩耗时 | 187秒 | 119秒 |
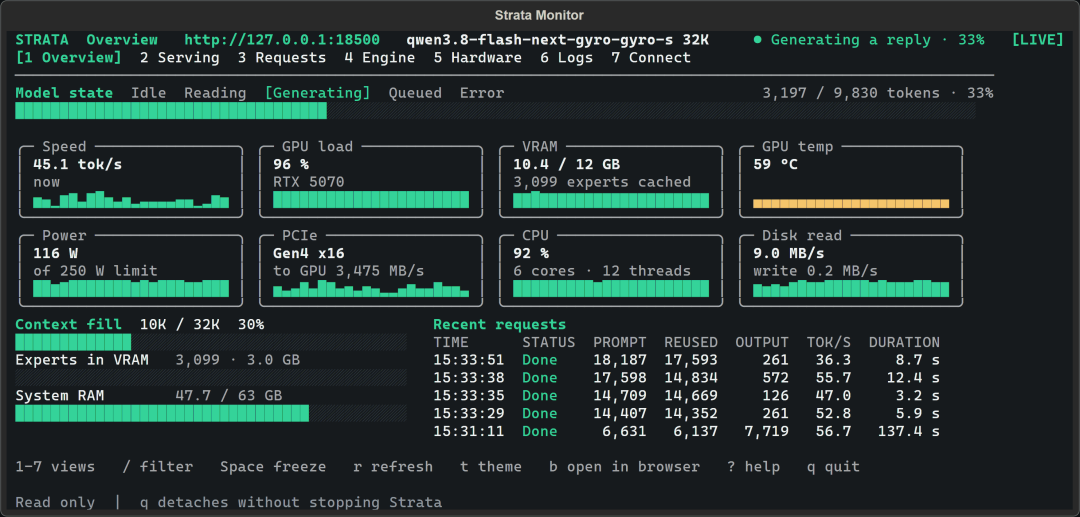
另外三个读数:关思考后思考链为0字符、基础问答0.6秒、生成段快约5倍;41次流式异常中断直接归零;最关键的——decode速度本身没变。你省下的不是算力,是"不说废话"。开思考时,80-90%的token花在reasoning上,这才是44t/s和49秒首token的真身:BenchLM页面(截至10月19日)的中位出字速度是94.5t/s,它不是被卡拖死的,是被内心戏吃死的。 跑在Strata里的Qwen3.8-Flash-Next,监控面板上那条tok/s曲线就是这场"内心戏"的账单现场:知乎
第二本账:智商账——关掉之后输的那1道题,恰好提示了什么时候别关
19项准确性测试,关思考后18/19。 唯一失守的是"用恰好50个汉字描述春天":开思考会逐字数字数、交出整50字,关思考文思泉涌写成56字的诗。精确计数这类活,思考是真在干活的。小红书
跨源再对一笔:知乎用户OLDPAN在DGX Spark上跑NVFP4版Qwen3.8-Flash-Next,GSM8K抽200题实测194/200=97.0%,口径同样是thinking关闭。 也就是说对日常问答、代码补全这类短任务,“关思考≈降智"目前拿不出像样的证据。但反过来也别拿它当免死金牌:BenchLM那张分项表里,推理、数学、多语言三个分项合计占综合分29%的权重,全部"未测”。 思考到底帮这个模型挣了多少分,榜单给不出答案;而且各跑分都是在默认开思考的口径下测的,你一关,那些分数就都是待定数。27B分项排名最漂亮的三项——多模态84.4(#13/54)、Agentic 63.3(#20/130)、指令遵循86.9——更多是模型底子,跟你开不开思考关系不大。知乎知乎
第三本账:账单账——思考在本地机吃掉的是时间,在Agent链路里吃掉的是任务本身
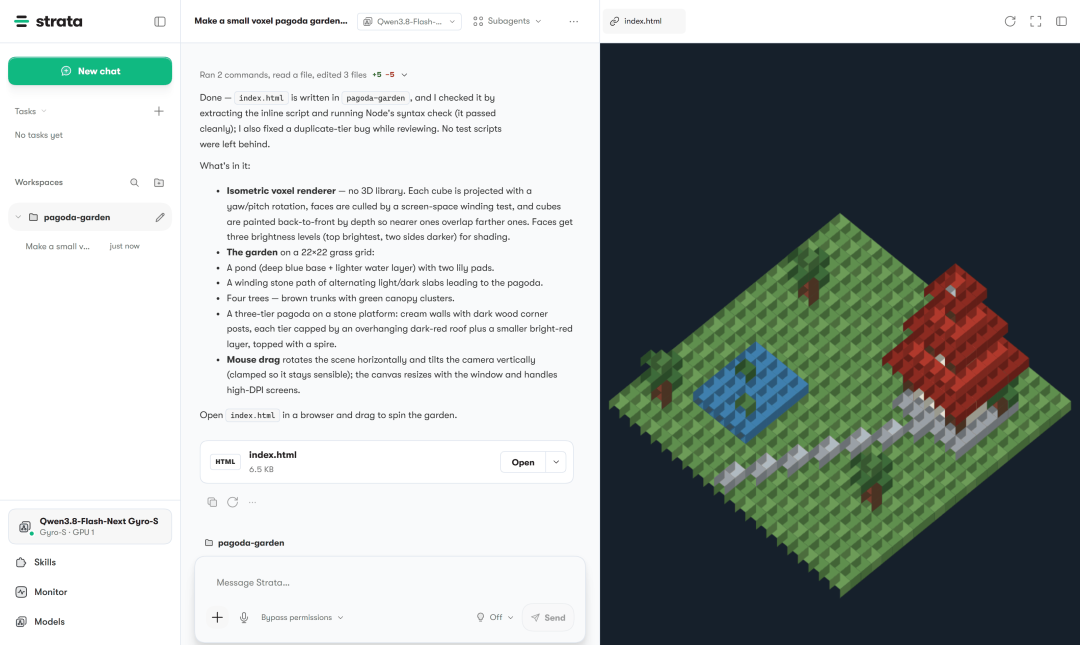
那7道空回答就是账单本体:32K上下文、max_tokens只给512,思考把预算全部花完,正文一个字都没出来,客户端等不及直接掐断。接Agent、接代码工具链的人对这条最有体感——知乎高赞回答原话是"随便一个问题就思考N久",社区已经有人专门做砍思维链长度的改版。 Strata这种带编码Agent入口的本地壳,界面上一边让模型写单文件3D场景,一边实时展示成品预览,思考一开,这条链路先排队。知乎小红书
12-16G党动手之前,先把开关和硬件分清楚:Qwen3.8家族里27B是dense,出字速度靠显存带宽;Flash-Next是125B总参、每token激活6B的MoE,另挂一张51B的n-gram查找表,官方设计就是把这张表放到内存甚至固态上——OLDPAN那台Spark实占约104GiB,PLE查找表BF16约95.4GiB用NVMe mmap挂着跑。 有社区自报5060Ti 16G+128G内存在256K上下文下稳定57tok/s。知乎知乎
关开关是本轮最便宜的一次提速,但它不解决"驻留"那半本账:你的慢如果是内存和带宽的慢,关了思考也只是少说了废话。
行动表:谁该关、什么时候开、关之前先查什么
直接问答、翻译、代码补全、挂工具的Agent链路:默认关(reasoning_effort: none或最低档),这是野生工程师和OLDPAN两边实测都支持的姿势;
精确计数、多步数学、对抗式规划这类"恰好N"要求:按请求临时开,别常驻;
长上下文+小输出预算:必须关,或者给思考留独立预算,否则等着收空正文;
关完先自测你那条任务链,别按综合分选型——27B在226个模型的公开榜上排第58,换成只统计88个有可核来源的模型,它就变第39。分母和权重一直在动(同一页面,10月15日记录的分母是224,10月19日已经变226)。知乎
三句社区反调,别跳
那份2511请求的账来自单机串行,没有并发。上多槽位服务器,排队会再吞掉一部分加速,结论别外推到集群;
“44t/s、49秒首token"是页面公开读数,知乎答主自己标注了"不是我在自己机器上跑出来的”——换量化档、调reasoning_effort档位,这些数字都会动,拿它们当"这模型慢"的铁证不成立。知乎
社区里"压进8G以内""4090上跑出可观速度"的改版,是楼主转述、未经逐条核实,方向可信,别当官方弹药。DavidAU和DASLab这两天也已经进场做Flash-Next的量化版本,出货节奏还没定。知乎
接下来盯什么
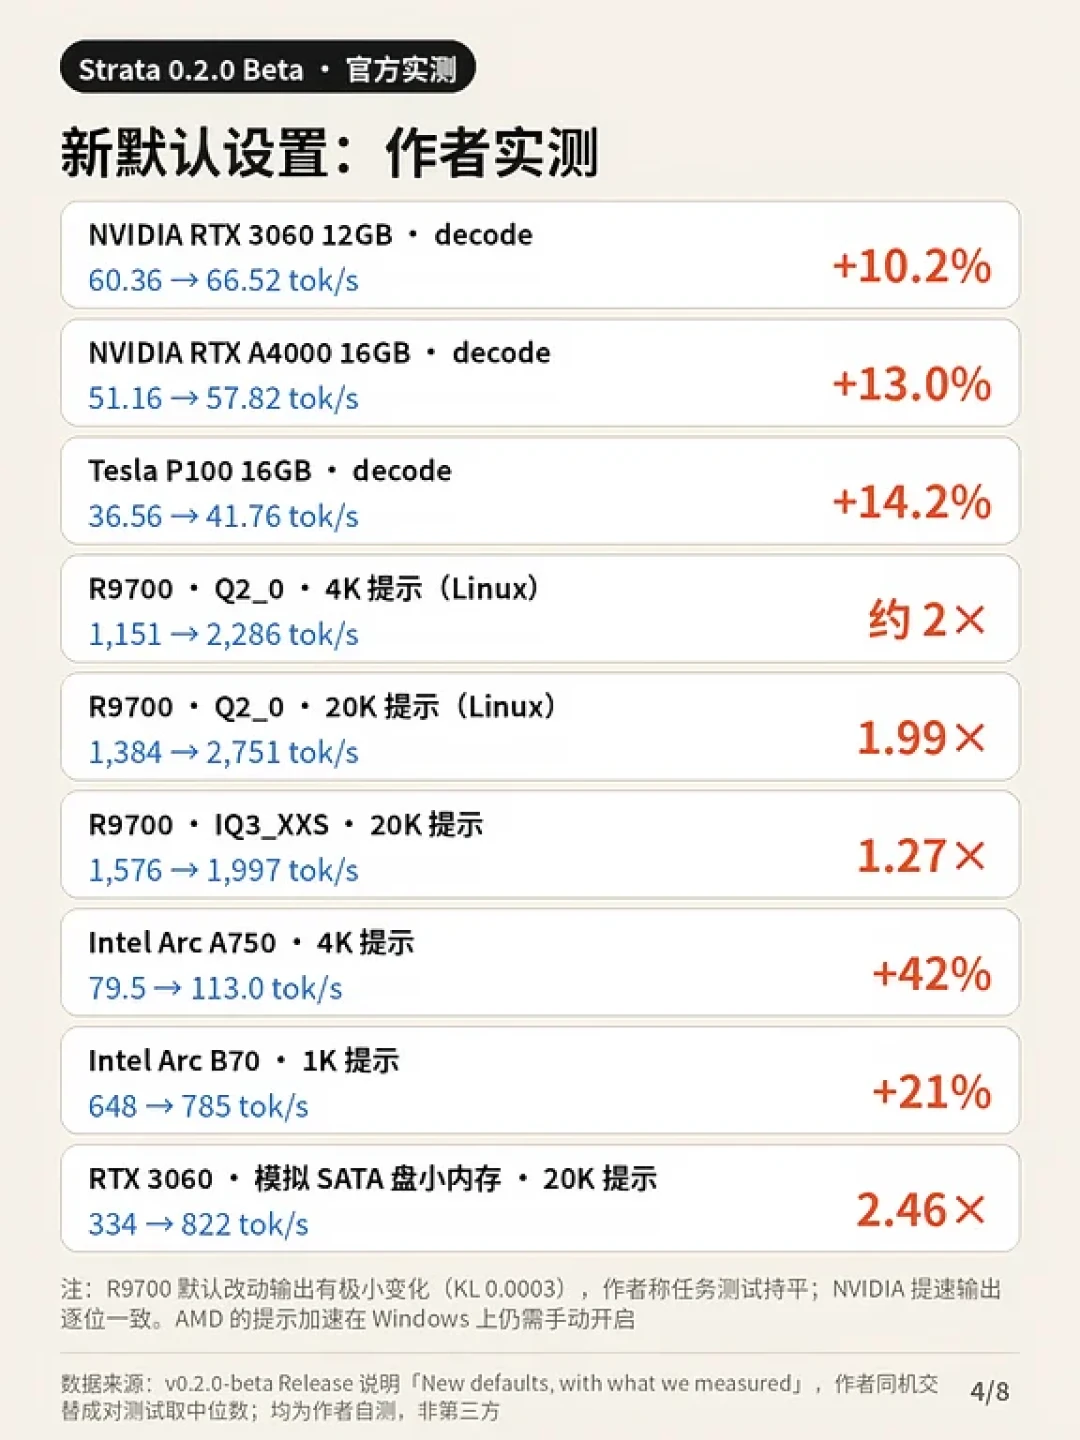
推理、数学那29%的权重补测出来之后,27B那个第58名往哪边走;Strata 0.2.0-beta 10月19日晚刚免费开源,作者同机交替中位数自报了一批提速数字:3060 decode 60.36→66.52 tok/s、R9700 4K提示1,151→2,286 tok/s。 接下来看第一周第三方复测和中断投诉量:小红书
以及社区砍思考链的改版,什么时候被官方版本吸收——按这轮Qwen3.8的迭代密度,等不了太久。