9月22日的云栖大会主论坛上,第一次以Qwen负责人身份公开亮相的刘大一恒,把开源排期摆了出来:基于新一代架构的Qwen4已进入训练阶段,开源侧优先安排Qwen4-27B。 整场官宣给了Qwen4-Max、Plus、Flash、27B四个名字,但没有给出任何一个具体的发布日期。36氪哔哩哔哩
官宣墨迹未干,先坐不住的已经是本地党。一条GSQ量化测评视频(播放9000+、评论231条)的评论区,有一句被顶到前排的吐槽——“MAD, qwen3.8 27B, 光模型就下载了十来个了。到底哪个好”。 手里捏着一张16G卡的人,这两天真正要想清楚的不是"等不等4",而是4来之前这几个月跑哪个版本、以及现在下载的这一堆,哪些到4那天会变成沉没成本。哔哩哔哩
先说结论:现在缺的从来不是显存,是认版本的眼力
第一,27B进16G早已不是新闻,折腾党甚至把更小的卡也用出了27B——“12G显存跑Qwen3.8:27B,速度30ts”。 第二,你下载的那十几个文件,根本不是同一个模型:官方FP8、GGUF常规量化、第三方混合量化、专用引擎格式、社区后训练魔改,同一个27B,显存、速度、思考风格、工具调用稳定性差的不是一点半点。第三,口径先说清楚:下文所有实测基本来自社区玩家的小样本,没有一项是官方跑分,抄作业可以,押身家不行。知乎
变体地图:几种"27B"同时活在你硬盘里
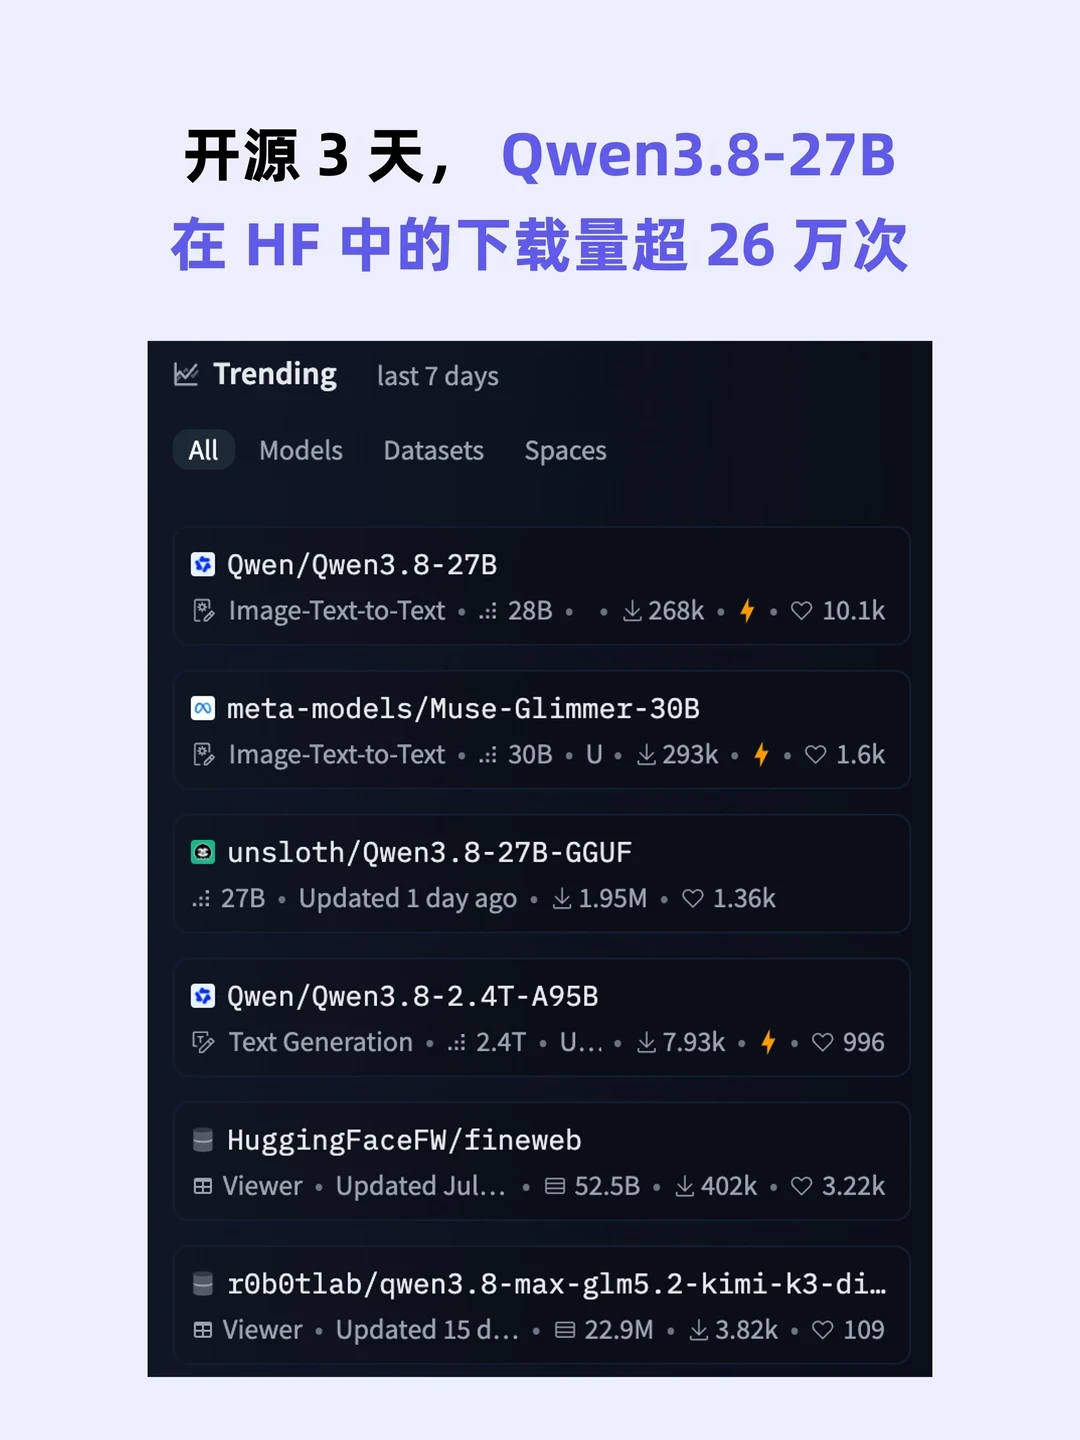
先给一个参照系:这个季度的开源热度,基本是被27B这一个尺寸撑起来的,“Qwen3.8-27B发布仅两个月,Qwen整个家族的下载数量就超过了DeepSeek、Llama等开源模型,成为HuggingFace上获赞最多的模型系列”。 热度背后,是模型站上官方仓库和几十个第三方变体仓库同屏刷新的场面。36氪
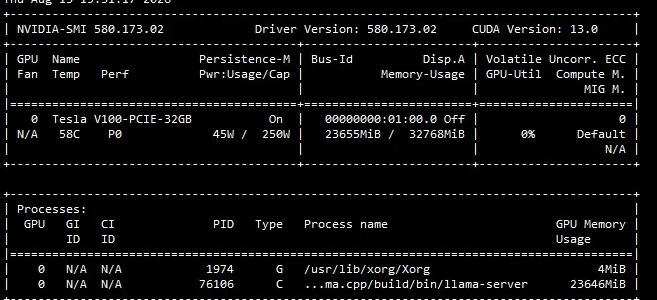
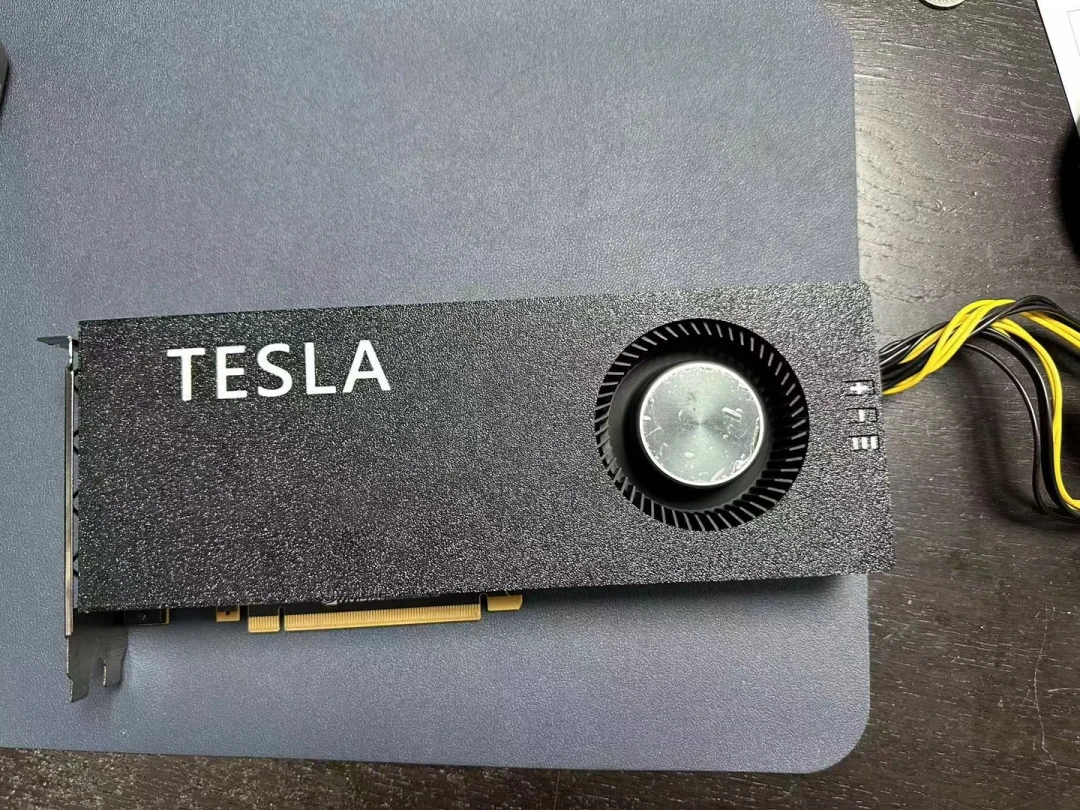
官方FP8:给显存富裕的人。 FP8的卖点是精度几乎不丢,代价是24G起步的门槛;反而是老计算卡成了高性价比路线,有人专门给Tesla V100 32G配亮机卡走Ubuntu部署,“电脑配一个亮机卡+V100(32G)原版PCIE,UBUNTU系统”。 16G的人看看就好,这个档位不属于你。小红书
GGUF家族:Q4_K_M是基准,IQ3是甜点。 不知道下哪个的时候,Q4_K_M是所有测评共同的参照物;而ISTA-DASLab出品的GSQ-RCO混合量化把27B再压一档,“这块卡是 RTX 4060 Ti 16GB,模型是 GSQ-RCO 量化的 IQ3_S(权重 11.3 GiB,自带 MTP 头,可开投机解码)”。 同篇实测:原生配置下96K上下文能跑到33-35 tokens/s,16G甜点卡完全跑得动。知乎
争议也跟着来了。顶这个版本的人说它"越难越强,简单的可能不如 q4,上难度能打 q8,这是最离谱的地方"。 也就是说:日常聊天写作可能不如Q4_K_M,难逻辑难代码反而逼近Q8。哔哩哔哩
泼冷水的也是真实用户,24G卡主的反例就写在同一评论区:“对16g显卡可能最好,但远不到有些人吹得那样。经24g显卡实测,这个与qwen 3.8 27b q4km相比,不但速度更慢,而且即使kv不量化的情况下,也明显不如q4km kv4量化后的能力(xhigh)”。 两派都不算孤证,能给的结论只到这里:IQ3是给"显存刚好差一点、任务够难"的人准备的,不是无脑替代Q4_K_M的免费午餐。哔哩哔哩
专用引擎格式:快,但驾驶证绑死引擎厂商。 5090笔记本实测的聚合吞吐相当能打,实测者自己都点破了关键:“MTP 的价值在单流延迟,不在聚合吞吐”。 标题党数字和实测口径之间的信息差,就是这样拉开的。更要命的是格式:专用引擎的私有量化格式和主流GGUF系"不能兼得",选引擎的瞬间就选了格式,换引擎等于重下全库。哔哩哔哩
社区魔改与1-bit前沿。 “Swift"这类后训练版主打砍掉3.8的"雷霆大思考”,但测评区自己的评价更诚实:“感觉各家厨子现在都有自己的配方,但海森堡那样的厨子还没出现”。 前沿那头,1-bit量化也来了——“PrismML推出1-bit模型Bonsai227B,保留原始Qwen3.8 27B 98.2%的性能,但加载只要5.9GB内存”。宣称归宣称,4-bit都还在被吐槽的今天,1-bit当预告片看就好。哔哩哔哩
三个争议细节,比选版本更值钱
装得下不等于推得动。 这轮第三方量化翻车测评的评论区,最值得抄在便签上的一句是"装得下不等于推得动,吞吐得一起看"。 显存里要住的远不止权重,还有投机解码的草稿上下文——“实测提速 1.7–2.1×,但要多占 1.5 GiB(草稿上下文 + MTP 头权重)”。 加上KV缓存、视觉塔、CUDA瞬时缓冲,16G卡经常只剩五六百兆余量,一次几百兆的临时分配就能崩给你看。哔哩哔哩知乎
256K上下文在16G上是有解的,但要过三关。 Qwen3.8是混合注意力,“64 层里只有 16 层真正做 KV 缓存”,所以256K的KV全精度约16GiB、q4量化后约4GiB,账勉强算得过来。知乎
第一关,KV外置方案要换约10-20%的速度;第二关,工具链——“官方在 Linux 上只发布了 sm120a(Blackwell)的预编译包,而 4060 Ti 是 sm_89——直接跑不了,必须自己编”。 第三关,接口带宽,PCIe x8的卡上流式方案性价比不够。抄作业前,先核对自己的卡。知乎
KV量化是16G作业里的隐藏题。 社区普遍反馈,Qwen3.8对Q4 KV量化的容忍度比Llama系列更高。 所以5080用户敢在16G上开190K-230K上下文;但同一批实测也写着,开着MTP的原生配置只给得起96K。每张卡的答案表不通用,别拿别人的截图当自己的配置。知乎
Qwen4-27B会改变什么、不改变什么
会改变的:27B的架构和上限几乎必然被重写,而且新架构已经在提前试水——“Qwen3.8-Flash提前开源了下一代架构,官方称训练成本降低近90%”。 量化生态也会随之整体重置,你现在囤的这一堆量化文件,大概率是过渡期作业。换代节奏早就卷成了常态,官宣视频的评论区里那句"大模型进入月抛时代",就是本地党自己说的。 上一代的35B路线说弃就弃,“我擦,35B就这么死了?”36氪哔哩哔哩
不改变的:显存还是显存,Qwen4-27B出来后第一个半年,16G档位的KV算术照样得做;GGUF路线接新架构的速度依然是社区里最快的,3.8这一代开源不到两周,量化版和最佳实践就已经铺满模型站。这两条"不变",才是等待期行动清单的依据。
等待期行动清单(对号入座)
还没上车的(手里16G或准备买):不用为"等Qwen4"换卡,也不用为"3.8发了"慌忙加预算。用成熟的GGUF变体把当代27B的体验跑满,等4-27B放出,切换成本是重新下载,不是重新装机。
已在车上、困在变体堆里的:先停止下载,把手头任务做成一套小测试集——几段代码、几道逻辑题、一篇长文,自己跑一遍,比任何区UP主的"首选推荐"都值钱。值得沉淀的栈只有三样:通用格式、主流引擎、KV策略笔记。16G阵营目前流传的最优组合是GSQ-RCO的IQ3_S配KVMem版llama.cpp,而这条热评的结尾自己都写了——“应该是目前最优解了,更优的话等qwen4”。哔哩哔哩
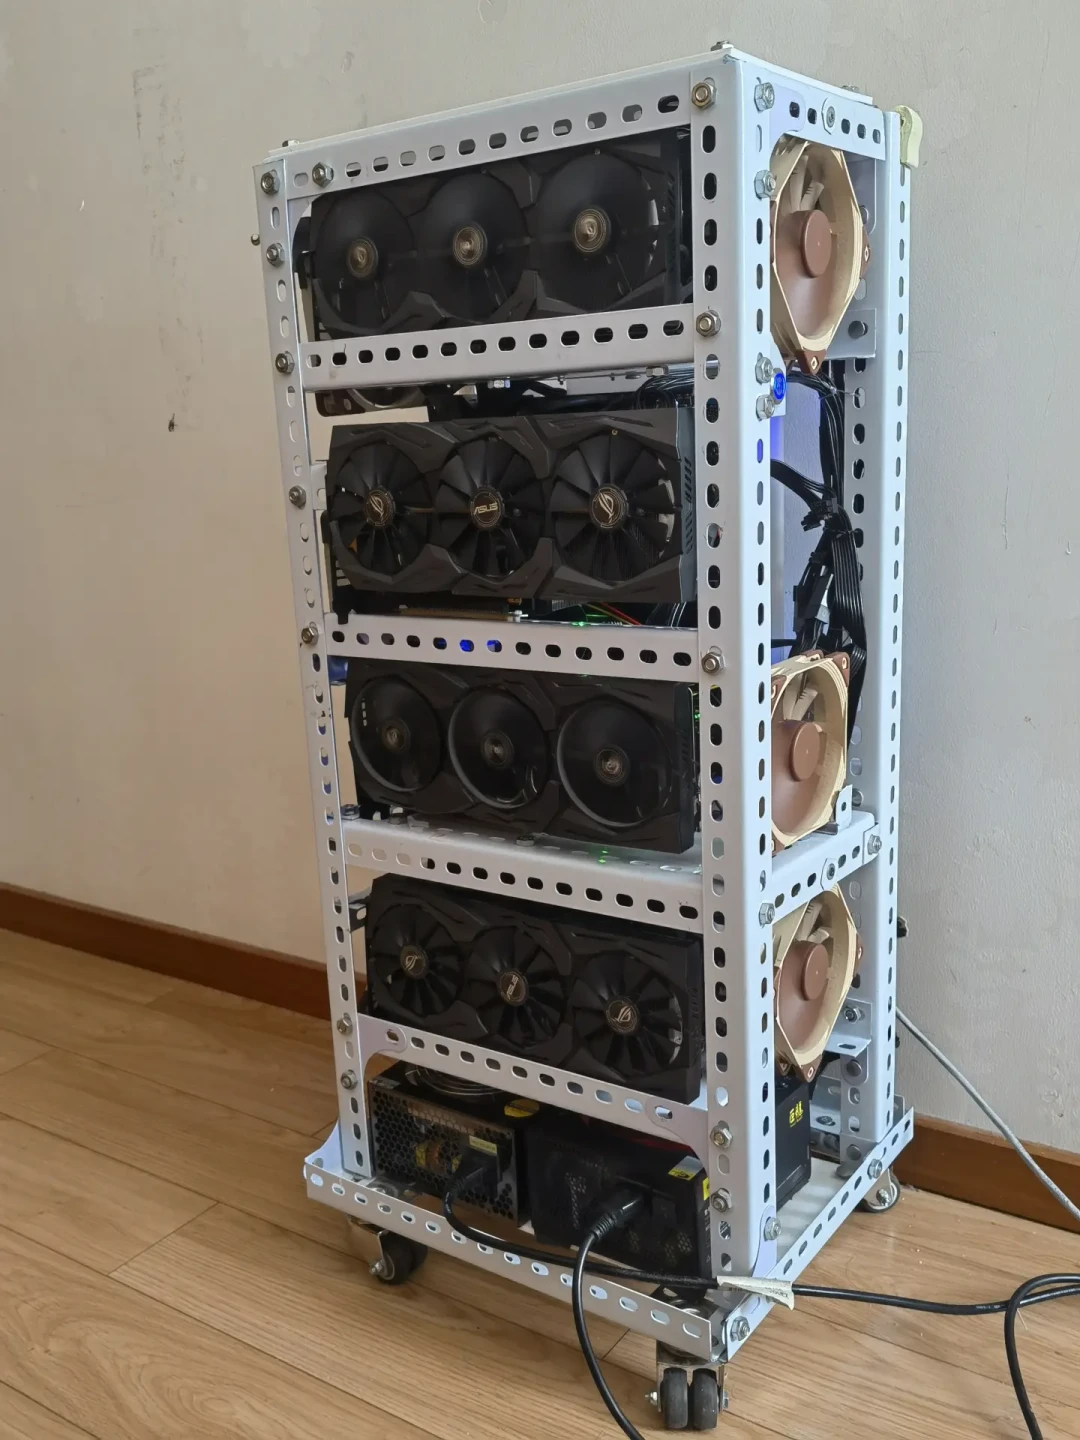
预算敏感但任务重的:真要用老卡堆规模,路线也确实存在——“显卡8卡2070,总显存64G,自制开放式机架-显卡住楼房,同时满足静音和散热”。 但这属于折腾党分支:Qwen4换架构那天,这些绑定专用格式的工程全要重做,别在过渡期把兴趣玩成装修。小红书
接下来盯四个信号
一,Qwen4-27B什么时候进开源仓库:官方只说了"优先",没说日子,盯紧官方仓库和HuggingFace热榜。二,开源后主流量化格式是否快速跟进:这决定普通用户是"day one上车",还是再等几个月的稳定版。三,第三方量化作者们是否跟进4的版本、以及对3.8是否继续维护:这是量化生态站队的风向标。四,“阿里累计开源460多款模型,Qwen系列全球下载量超过30亿次,衍生模型超过30万个,位居全球第一”——这份开源表态,在灵魂人物离开后的新管理层手里兑现到什么程度,比任何单个模型的参数都更值得本地党收藏跟踪。36氪
这一轮过渡期最大的坑,不是下错哪个量化版本,而是把每一次下载都当成赚到的安全感。硬盘越满,不等于越接近答案:先把3.8用明白,等4来了再换得干脆。