做过 post-training 的人大概都熟悉这个体感:攒了二十万条指令数据往 SFT 里灌,loss 掉得漂亮,模型却不见得变聪明。你的第一反应通常是"数据还不够,再清洗一轮、再扩一点"。但 9 月以来集中出现的一批论文、二创和讨论,指向的结论恰恰相反:被推翻的不是你的清洗功夫,而是"量=效果"这本老账。
一、风向变了:论文圈从"训模型"转向"训数据"
先看一个具体的小数字。知乎上有个每周跟踪"用 agentic 方式合成/筛选训练数据"的速读栏目,8 月 24 日、8 月 31 日连续两期的收录数是 6 篇和 8 篇,9 月 7 日这一期涨到了 10 篇(含近三个月补收)。 它的入选用的是硬标准——“并真的训模型、benchmark 验证有效”,只发 idea 不做训练验证的论文进不来。知乎知乎知乎
比数量更能说明问题的是名单。这三周入选的工作,作者名单里出现的是:Qwen 团队、腾讯混元、清华、浙大、蚂蚁、美团(含 LongCat)、复旦——过去各自训基座模型的一拨人,现在同时在干同一件事:把"造数据"本身做成一个可训练的 agent。
拆开看,每一篇都在回答同一个新问题的一个侧面:
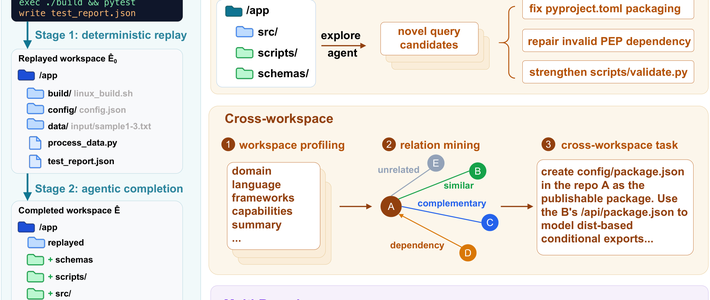
Qwen 团队 + 清华的 Terminal-Universe:把已有的 agent 轨迹反过来重建成可复用的可执行环境,再从环境里合成新任务继续交互训练。 这批语料直接拿去给 Qwen3.5-27B 做了 SFT,评测摆在 Terminal-Bench 2.1 和 EvoCode-Bench v2 上,论文在 HuggingFace Papers 上冲到了本期最高的 271 upvote。 B 站二创视频的标题更直白——“历史记录反向还原成 3.7 万个代码沙盒”。arXiv知乎哔哩哔哩
腾讯混元(arXiv:2609.04128):治的是"模型变强后,从零合成的环境不够难、学习信号枯竭"这个慢性病,用 off-policy 的方式逐代抬高环境难度再调度进训练。
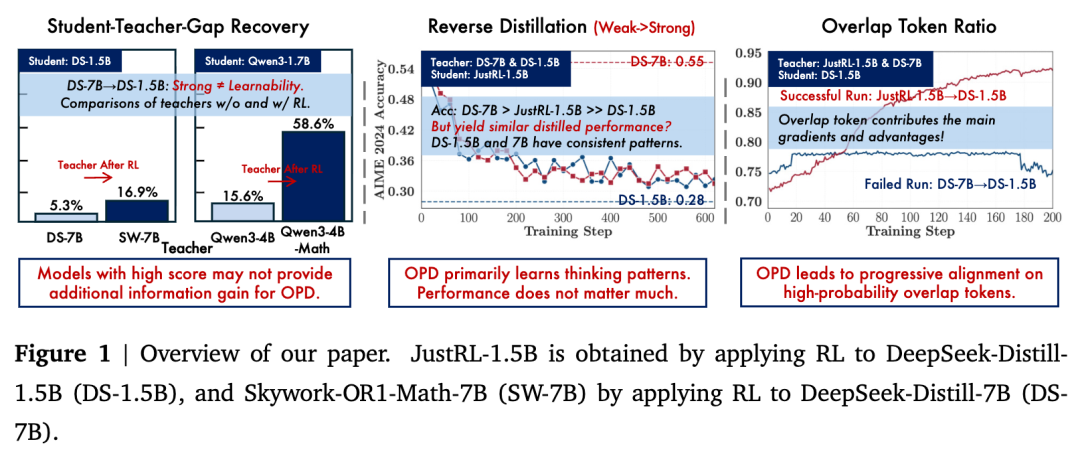
清华 + 美团(arXiv:2609.05198):专门研究在线策略蒸馏(OPD)里的数据筛选,给出的结论是"8 个精选难例约等于 17K 数据"。
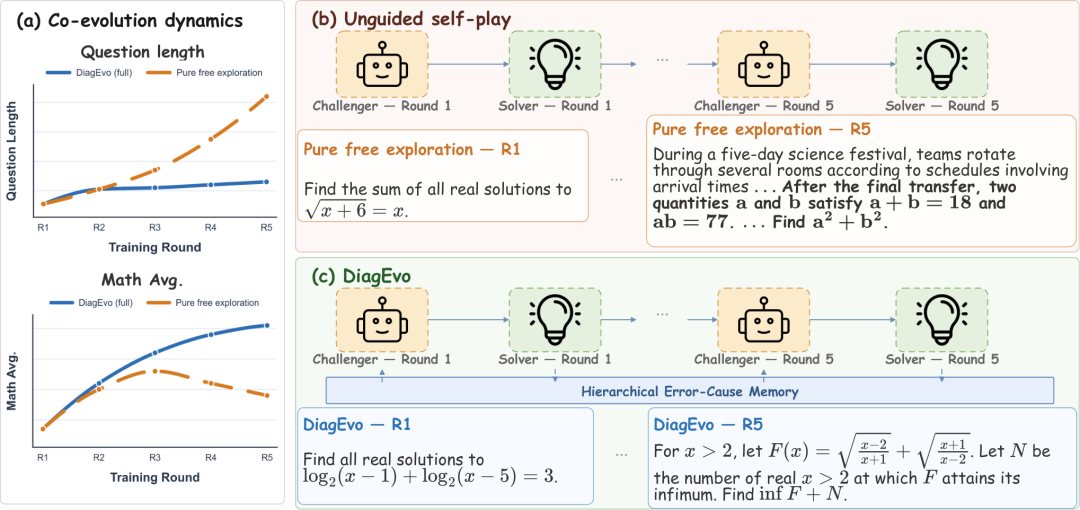
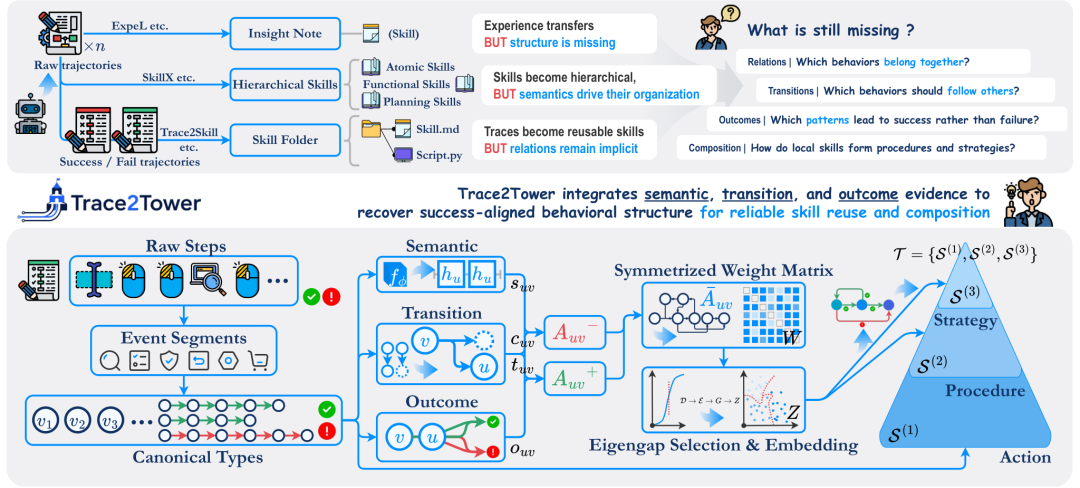
名单后半段同样说明问题:蚂蚁 + 浙大的 DE-Venus 把数据选择、弱监督构造和训练中的监督修正统一进一套 data-efficient RLVR 框架;美团 LongCat 的 DiagEvo(arXiv:2609.00768)让出题方向不再靠外部题库,而是从 solver 自己的失败历史里长出"错误原因记忆",题目难度随轮次协同进化;复旦的 Trace2Tower(arXiv:2609.05261)则把一长串原始轨迹直接蒸成"策略—流程—动作"的分层 skill。连选数据、给监督、造题、蒸轨迹,全都有人做成了带验证环节的系统工程。
Karpathy 在年终总结里把 RLVR(可验证奖励强化学习)列为 2025 年大模型行业最重要的技术成果之一。 当后训练的主战场收敛到"可验证的奖励"上,训练瓶颈就从参数、结构、卡,移到了另一头:可验证的训练数据从哪来。这就是 9 月这批论文共同指向的答案方向。微博
二、三件反直觉的事,每件都能改你的操作
1)蒸馏的瓶颈不在样本条数,在"难"本身。
清华-美团那篇 OPD 实验做得比"8 个难例顶 17K"更狠:1-shot 极端设定下,只用一个例子训,在所有采样训练例上一致有效,而且越难的例子带来的提升越大。机制分析显示,“提升不来自高 token entropy,而来自难题天然生成的更长 CoT 路径”——难题会逼出 teacher 写出"Alternatively"这类反思模式,短 CoT 里没有。 这句话对炼丹人的意思是:你那 17K 条同质中等题不只是浪费卡时,还可能稀释掉真正值钱的少数样本。选数据的第一标准正在从"覆盖度"滑向"难例密度"。知乎
2)模型的上限在参数里,Agent 的上限在环境里。
一位把 SFT 冷启动和 GRPO 反复交替跑完的实践者复盘说,模型崩不崩,账很少记在模型头上,超参换了一轮又一轮,真正救活训练的功夫全落在环境和数据分布上——模型的上限在参数里,Agent 的上限在环境里。 这条社区共识正好解释了 Qwen 为什么要从"死日志"里重建环境:一条轨迹只是冻住的单次演示,而一个可 replay 的环境能被反复 re-query 出成百上千个可验证任务。数据的单位,正在从"条"升级成"沙盒"。知乎
3)合成数据已经不是选修课,但必须配验证闸门。
这周 B 站刚搬完 HuggingFace 的对谈中字,标题就叫"如何合成预训练数据"。 更早的分享里,Poolside 团队直接把大规模训练的现实摊开:应对数据瓶颈,靠的是自动混合器加大量合成数据、配合多阶段重构。 Meta FAIR 的 Autodata 则被 8 月 17 日那期速读列为头条,理由一句话——“把’造数据’本身当成一个可训练的 agent”。哔哩哔哩哔哩哔哩知乎
真正的争议在污染端。知乎近期有个热度不低的问题:"vibecoding 出了大量屎山,下一次大模型训练会不会因为吃屎变傻蛋?"阅读量 7.9 万的一条回答,给的判断相当冷静:过滤的标准是 passrate、review 通过、生产实跑——“看的是验证结果,不是作者是谁”。 换句话说,AI 写的烂代码和人写的没测试的烂代码,在数据侧是同一个东西:没有验证信号的样本。合成数据不会被禁掉,但没有闸门的合成数据会被整个行业拉黑。知乎
三、小团队的九月数据账:五件可以直接改的事
对算力有限、主要做 SFT/OPD/RLVR 后训练的个人和小队,这波信息可以折算成动作:
扩量之前,先做去重和难度分层。“你的 SFT 数据,可能 90% 都是白训的”——这个从 LIMA(1000 条精心挑选的数据就把 65B 基座对齐到接近当时 GPT-4 的交互水准)一路传到今天的结论,现在是社区共识而不是个例。知乎
蒸馏预算按"难例优先"重排。能过 verifier 或自洽投票的难题,一条顶一片中等题;完全超出当前 teacher 能力的样本也别急着丢,实验里它同样能被用上。
训 agent 能力,钱先花在环境上。有存量轨迹就先做 sandbox 重建,Terminal-Universe 已经把"replay 轨迹 → 补全 workspace → 合成任务"的路径写明白了,再谈数据量。arXiv
每一批合成数据都要能报出验证方式。没有 passrate、单测、self-consistency 里的任何一项,宁可不合成。
继续盯三个信号:速读栏目收录数是否还在涨;Terminal-Universe 这类环境重建方案的代码是否开源放出(本期复旦 Trace2Tower 已开源);以及下一个大基座的训练复盘里,"数据验证管线"会不会开始占独立章节——那是这套方法论能不能从 27B 走到 30T 的验尸报告。
写在最后
2024 年,"使用弱智吧数据训练的大模型,跑分超过用维基百科、知乎、豆瓣、小红书等平台数据训练的大模型"还被当成段子讲。 到这个 9 月,大厂们把数据生产做成了 agent 和环境,中文炼丹圈对数据工作的判断其实一直在收敛:质量靠人的时代,数据是挑出来的;验证靠机器的时代,数据是造出来再过闸的。微博
真正该焦虑的从来不是卡不够,而是哪天你醒来发现,全行业都在换算法了,你的数据管线还在比谁的条数多。