10月24日凌晨,国模圈久违地端上来一盘硬菜:月之暗面发布 Kimi K3.1 Pro。但对本地部署党来说,真正的大新闻在后面——官方确认,完整模型权重将在11月4日前开放。知乎知乎InfoQ
2.8T总参数、全球参数规模最大的开源模型。Artificial Analysis甚至放话:权重一落地,开源与顶级闭源的差距将从12分缩到3分。知乎新智元
底盘没换,驾驶技术变狠了
别被"新模型"三个字唬住,K3.1 Pro的底盘还是7月发布的K3,没有重训,而是把算力砸在了后训练上:强化学习铺到几百个下游领域。打个比方——车没换,但驾驶技术练狠了。新智元
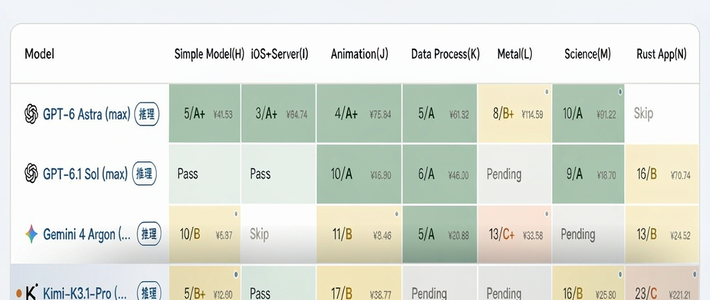
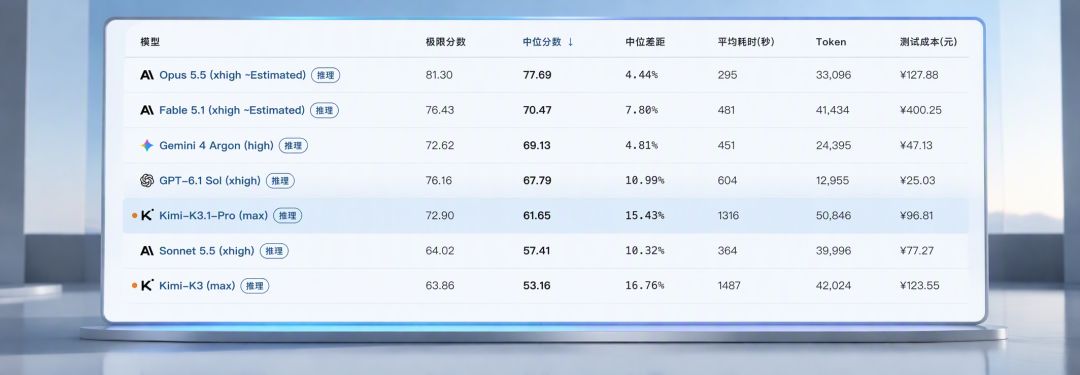
效果直接写在榜上:最考验Agent独立干活能力的Terminal-Bench 4.0,K3只拿了13%,K3.1 Pro直接飙到65%以上,创下该榜历史最高。AA智能指数55分、全球第四,身前只剩Claude Opus 5.5、Sonnet 5.5和Meta的Muse Wonder Full。中国企业家杂志InfoQ知乎
架构上,它是一台2.8T总参数的MoE:896个专家,每个token只激活16个,实际干活约1040亿参数;上下文100万token,支持图像输入。中国企业家杂志知乎
想本地跑?先算三笔账
现在泼冷水。2.8T参数换算成权重体积:FP8约2.8TB,就算Q4量化也要1.4TB上下。
什么概念?512GB的顶配Mac装不下;B站最近很火的"32G显存+128G内存"混合推理套装,在它面前差了一个数量级。粗算一下,光放下Q4权重就需要8张H200(合计1128GB显存),而且还不够,得再叠机器或者借大内存。
结论很直白:这是企业机房和高校实验室的集群玩具,家用电脑暂时只有围观的份。唯一的安慰是,MoE每个token只激活1040亿参数,等推理框架适配到位,速度不会像同体积稠密模型那样惨。
家里跑不了,API能用吗?盯着额度
先行者的坑值得看。上线48小时,"额度烧太快"就冲上热搜:有199元档会员发了一条"审查项目架构"的指令,模型拉起5个子Agent,十几分钟烧光5小时额度。中国企业家杂志
10月26日,官方发布致歉公告,为全部订阅会员补偿月度总额25%的额度。这已是Kimi半年内的第三次道歉。知乎中国企业家杂志
原因不复杂:K3.1 Pro思考模式常开、推理强度默认max档,多做几步、多调工具来确保做对。有开发者实测,同一个任务K3花61万token,K3.1 Pro要花144万——单价确实降了三成多,账单却反着走。知乎中国企业家杂志
想尝鲜的话:API每百万token输入13元(缓存命中1.3元)、输出68元,成本只有GPT-6 Astra的五分之一。Highspeed版输出速度快约2-3倍,价格翻倍。使用时记得管住子Agent的缰绳。InfoQ新智元知乎
11月4日,盯这三件事
官方是否随权重放出量化版本;
vLLM、SGLang、Xtier这类推理和混合推理项目的适配速度;
K3.1 Pro只是K3.1系列的第一枪,后面更小、家用显卡真能吃下的兄弟版本,才值得蹲。InfoQ
开源最大的魅力,就是不用看任何人的额度脸色。下周三,看看这只2.8T的巨兽,能不能被社区搬进普通人的家。