小米把 0.8B 的 Xiaomi-OCR-0 接进超级小爱后,最先被感知到的不是参数,而是手机开始替你“接着办事”。它被放进了哪里,比模型大小更值得注意:不是独立的扫描 App,而是小米手机和超级小爱的日常高频动作里。官方把这套变化概括为从“被动截屏查找”走向“主动理解服务”。 这个模型只有 0.8B,却把文档解析、关键信息抽取和 OCR 视觉问答塞进了一个模型。小米技术快科技
这句话听着抽象,落到手机上其实是四类很具体的事。
第一类是“凭证”。外卖取餐码、驿站取件码、退货码、寄存柜号、餐厅排队号,这些信息散落在短信、微信和各家的 App 里。以前取件,得先想它在哪,再翻聊天记录。现在短按 AI 键、三指上滑,或者对超级小爱说一句“记一下”,系统会把屏幕上的核心字段和状态提出来,直接送上超级岛。 这不是“认字”,是先判断这是一张什么凭证、还有没有效、该在什么时候提醒你。小米技术
除了这些一眼要用的凭证,识屏本身也在变。刷英文新闻时唤起超级小爱,它能整篇总结、列 Top5 要点;看到想留的页面,三指上滑存进“超级小爱记忆”。 以前这类功能慢、错得多,用户就退回复制粘贴;这类功能一旦快到不用等,用户就不会切走。小红书
第二类是“账单和卡证”。看微信、支付宝账单时按 AI 键,金额、商户、支付时间、消费类别会被抽出来,直接记账;纸质发票、身份证、银行卡,拍一下或识屏,字段就被抽成结构化的了。 这类功能最实在的地方,是它终于把“看见”变成了“录入”。技术上的名字叫关键信息抽取,模型要输出的是 JSON,不是一段可以随便读的文字。小米技术GitHub
第三类是“日程和出行”。群聊里的会议通知、活动海报上的时间地点,系统读懂上下文后生成日程卡片;朋友发来“我的航班号是国航 CA824”,你直接问“这个航班还有多久到”,它会结合屏幕上下文查实时起降。 这一步比前两类都难:它不只要读对,还要知道这条信息该接到哪个服务上。小米技术
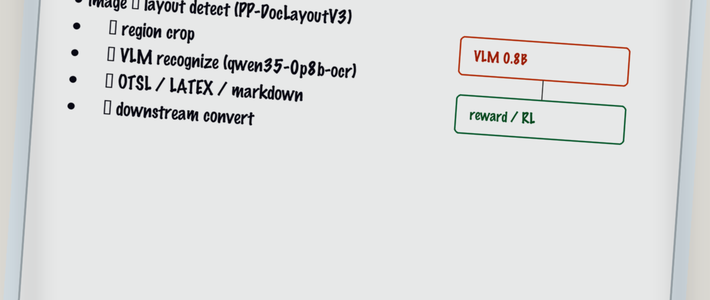
第四类是“文档”。表格要还原行列,公式要转 LaTeX,长文档要按阅读顺序输出 Markdown;Xiaomi-OCR-0 把这些和 OCR 视觉问答放进了一个 0.8B 的模型里。 有测试者用桌面显卡跑本地版,论文转录平均每页 1.8 秒,1052 页法律汇编不到 5 分半。 手机没有这张显卡,但 0.8B 至少让“在端侧跑”从愿望变成了工程问题。GitHub知乎
为什么非要小?因为 OCR 只有跑得够快、够近,才配叫“随手”。模型以 Qwen3.5-0.8B 为起点,在约 1.7 亿条 OCR 中心样本上训练;官方称它在 Real5-OmniDocBench 上拿到 95.24,在 OmniDocBench v1.6 上拿到 96.83。 这些分数说明它“认得准”,但用户在意的其实是另一件事:识别完这一屏,能不能不用再切 App。GitHub
它现在还会翻车。小米内部 KIE 基准总体准确率 59.09%,航班信息能到 73%,地址抽取和发票仍然落后;手写、古籍、反光屏摄也会掉分。 小米的扫描入口也被用户吐槽多页要一张一张框选。 模型开源,不等于每台手机、每个功能立刻换上同一版;哪项能力跑的是这个 0.8B,官方也没逐项说明。知乎小红书
所以这次更新最值得看的,不是 OCR 又多了几个第一,而是它从“工具箱里的一个功能”变成了“助理的一只眼睛”。对普通用户,判断它好不好用也只需要一个标准:读完这一屏之后,它有没有替你少切一次 App。