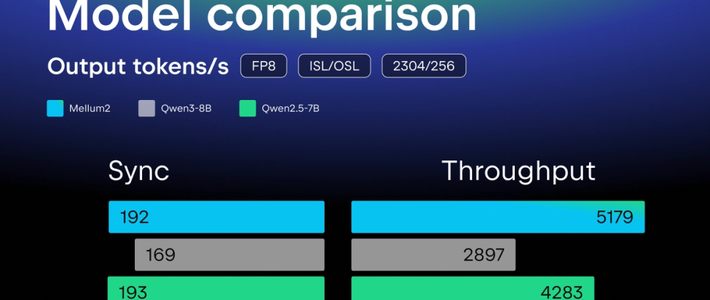
最该关心这条新闻的,是这么一批人:手头有一两张4090,Cursor、Claude Code的订阅账单最近越看越不顺眼,早就想找个能在自己机器上跑的编码模型。10月8日(当地时间),JetBrains把Mellum 2.1的权重放上了Hugging Face,Apache 2.0许可,架构延续上代:12B混合专家、每token只激活2.5B、上下文131072。今天中文技术圈的标题齐刷刷写着"同速级智能体基准登顶"“高负载吞吐接近Qwen3.5-9B两倍”。前沿在线知乎IT之家
先给结论:这个"登顶"是真的,但它赢的是四个月前自己的上一代;把它放到同档对手旁边,17项里它只赢5项。JetBrains这次换的不是"最强",是"每token只花2.5B力气、还能装进你机器"。要不要今天下载,取决于你的活儿是不是它赢的那5项。

这次到底改了什么:参数量没动,训练方式换了
架构和Mellum 2完全一样:12B总参数的混合专家(MoE),每个token只激活2.5B,上下文131072(128K),Apache 2.0开源。真正的变化在预训练之后——据官方博客的整理,这一版几乎全部工作量都花在强化学习后训练上:把模型直接扔进真实代码仓库,带上shell和改文件工具,找失败测试的根因、动手改、再跑一遍,测试通过才给奖励。训练期间开了数百万个沙箱、覆盖数千个环境,数学、竞赛编程、工具调用、软件工程都补了新任务,连开源训练数据都先过滤掉坏测试和不可验证的答案。前沿在线
翻译成人话:上一代Mellum 2的本职是补全、路由、编排这类快活(JetBrains自家AI Assistant的基础补全档位用的就是它),智能体任务是后补的课;这一代把"在真仓库里干活"当成主课来训,官方给的新定位也很直白:面向能探索仓库、修改文件并检查结果的编码Agent,也能用于本地快速子Agent。知乎
第一张牌:对照组不同,故事完全不同
把跑分表拆开看,这是今天刷屏标题里最容易被混过去的部分:
跟上代自己比——赢15项。 SWE-bench Verified从2.0分拉到47.0分,SWE-bench Pro从0.0到28.0,Terminal-Bench 2.1从0.6到17.4;同一套评测pipeline下,17项里它赢上代15项。方向性进步没毛病——毕竟上代本来就不擅长agent活。前沿在线
跟同档对手比——只赢5项。 同场对照的Qwen3.5-9B在三个最像"在真仓库里修bug"的基准上全赢:SWE-bench Verified 50.0对47.0,SWE-bench Pro 38.0对28.0,Terminal-Bench 21.7对17.4。Mellum 2.1拿下的是另外五个:LiveCodeBench v6(82.0对75.4)、HumanEval+,外加两项工具调用。前沿在线

所以"我想找个本地模型替我修仓库里的bug"——这张表不支持这个预期;它真正赢的,是"写得快、写得准、调工具稳"。
第二张牌:这些数字全是自测,换pipeline能差10分
17项全部是JetBrains自家pipeline测出来的,截至发稿没有第三方复现。而且pipeline本身就很敏感:同一个Qwen3.5-9B,官方模型卡上LiveCodeBench v6写的是65.6、GPQA Diamond 81.7;JetBrains用自家流程测同一个模型,得到75.4和77.8。同一个模型,换个测法差出10分——这就是为什么"跨榜单比大小"几乎必然比出假结论。前沿在线
证据能撑到的结论只有这么强:在JetBrains自己的评测设置里,Mellum 2.1相对上代的进步是扎实的,生成类和工具调用类任务在同档里站得住。至于"开源小模型编程新王",等第三方复现再说。
第三张牌:下载名和"8.1GB"这两个坑
准备今天就动手拉权重的,先把这两件事看清:
模型名陷阱。 Hugging Face上不带".1"的mellum2是6月老版(SWE-bench Verified只有2.0分),mellum-4b是2025年的补全模型——搜"Mellum"顺手下载,十个里有八个会拉错。
量化版还没"官宣完成"。 官方口径里GGUF格式和vLLM的MTP(多token预测)头都还是"即将推出"。目前已有第三方GGUF仓库列出5个量化版本,最小7.0GB、推荐档Q4_K_M约8.1GB——“8GB显存也能跑"的门槛确实摸到了,但你下的是还没走完官方验证路径的版本;官方主打的"单次请求快约1.6倍”(MTP)和"单张H200高负载吞吐接近Qwen3.5-9B两倍",现阶段也只在vLLM/SGLang全量部署那条路径上才成立。前沿在线

这模型到底适合谁:三个场景对号入座
场景A:给它安排"子任务",今天就可以试。 IDE快速补全、代码路由、批量总结、工具调用型子agent——这类活要的是低延迟、高吞吐、数据不出本机,正好是它赢的那5项和"2.5B激活"的卖点。JetBrains自己就是先在AI Assistant的基础补全档用Mellum、复杂任务再交给大模型的混合架构——7月就有人拆开过这套设计:基础补全用自研Mellum主打低延迟,复杂多步任务才换顶级模型。本地折腾党把同样的分工搬到自己的Agent流水线里,是现在最合理的用法。知乎
场景B:冲着"本地替代订阅"来的,再等等。 如果你这半年的痛点是工具改名又改价、token账单看不懂,想彻底换本地:等官方GGUF和MTP支持放出来再动,一张4090跑Q4_K_M的量是够的,现在下载要自己承担第三方量化版本的坑。
场景C:想让它当修bug主agent的,直接放弃预期。 三项最接近"真仓库修bug"的基准,它在自测对照组里都输给了Qwen3.5-9B——这个差距不是换个测法能翻盘的。
接下来盯这四个信号
① 第三方复现17项结果(尤其是SWE-bench系);② 官方GGUF和vLLM MTP头正式发布;③ JetBrains AI Assistant里Mellum承担的职责范围会不会从补全继续往agent侧扩;④ 下一批同档开源小模型会不会跟进"真环境RL后训练"这条路线——到时候比的可能就不是谁登顶,而是谁的成本线先被击穿。
一句话收口:JetBrains这次没把模型做大,是把训练方法换了;"登顶"的标题没骗人,它登的是"自己上代"的山顶。先分清你的活儿是补全、路由、子agent,还是主agent,再决定要不要下那8.1GB。










