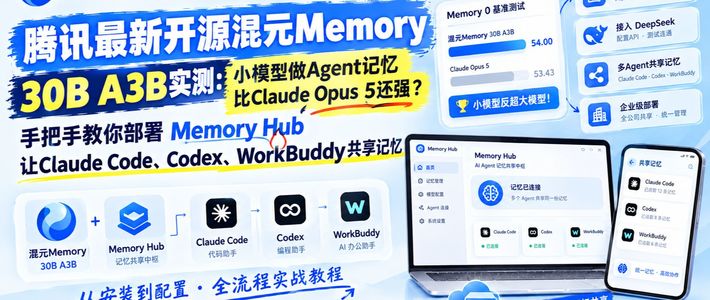
10月16日晚间,腾讯把AI的记忆力开源了,而且是一套全给。混元团队将智能体记忆框架HyMemory升级到2.0,专用模型、记忆框架和MemHub应用三层能力一次放出,既能独立使用,也能组合成完整的解决方案。 官方评测口径里,总参数30B、激活只有约3B的记忆专用模型Hy-Memory-30B-A3B,在四项记忆基准上平均拿到55.49%,高于Claude Opus 5的54.62%和Gemini 3 Pro的50.26%。 对每天拿AI干活的人来说,这件事非常具体:新开一个会话就得把项目背景重新交代一遍的“金鱼脑”,从此有了一条不花钱、自己装得起来的解法。微博OpenI资讯
把记忆做成专科,再算省下来的账
给Agent加记忆的玩家不少,HyMemory的思路是把记忆做成一门专科。框架把聊天、工作、代码三类记忆分开建档案:聊天记你这个人,工作记任务干到哪一步,代码记当初为什么这么改。 更特别的是,管记忆这件事本身也交给一个训练出来的小模型:总参数30B、激活3B,用强化学习专门训练,学的是怎么选择、更新和保留有用记忆,避免无意义的信息堆积。 这一版还给代码记忆引入了版本演化链路,改过什么、为什么回退、最终用了哪个方案都会留档——这正是人和AI协作做项目时最容易丢的信息。知乎专栏知乎OpenI资讯
这些设计最终折成了成本数字。按官方披露,与业内现有最优方案相比,Hy Memory将记忆大小压缩了51.8%,召回过程的token消耗节省39.3%。 腾讯内部一个接入助手的实测更直观:复杂任务的多跳召回率从50%拉到了90%。 需要说明,以上均为腾讯自述口径,基准选择未经第三方复核,真实收益还要等更多用户上手检验。腾讯云开发者社区知乎专栏
打工人零成本搭建:装什么、怎么装、账怎么算
对个人用户,最直接的入口不是模型权重,而是MemHub。它是面向普通用户的桌面与命令行应用,支持把已有工具的历史记录一键导入,在仪表盘里查看和编辑记忆条目。 目前这套东西可接入Cursor、Codex、Claude Code、WorkBuddy、Qwen Code、Hermes等10种以上工具——一个工具里踩过的坑,换个软件的新会话也会自动绕开。 数据上走本地优先路线,记忆落在本地目录、不强制上云,框架侧则是一行pip命令起步,配好自己已有大模型的API就能读写检索记忆。OpenI资讯知乎专栏
但“零成本”三个字的边界要算清楚:免费的是记忆这一层,模型权重、框架SDK、应用客户端全部开源随取;办公助理背后那个大模型,仍然来自你已经在付费的API或订阅;想把30B-A3B记忆模型也完整跑在本地,算力还要自己出。这套开源省下的是“让AI记住你”的钱,不是“AI干活本身”的钱。
赛道已经挤起来了
给AI装记忆不是腾讯一家在动。字节Seed开源了具备长期记忆能力的多模态智能体框架M3-Agent,走的是边处理视频流边沉淀情景记忆的路线。 腾讯这边,HyMemory是先在内部金融、资讯、知识管理、办公Agent等多条业务线跑过一段时间,再整体拿出来开源的。 竞争背后的信号很直接:模型能力日趋同质,“谁的记忆成为Agent的标配”正在变成下一个卡位战。接下来值得盯两件事:MemHub接入面的扩散速度,以及本地完整部署的算力门槛,官方文档会不会给出明确答案。知乎微博