玩本地大模型的人,最折磨人的从来不是"算得慢",而是"装不下"。模型加上下文一超显存,直接 OOM 弹回桌面。英特尔刚在 OCP 全球峰会上发布的 D270,给的药方简单粗暴:把内存往死里堆——单卡最高 480GB。
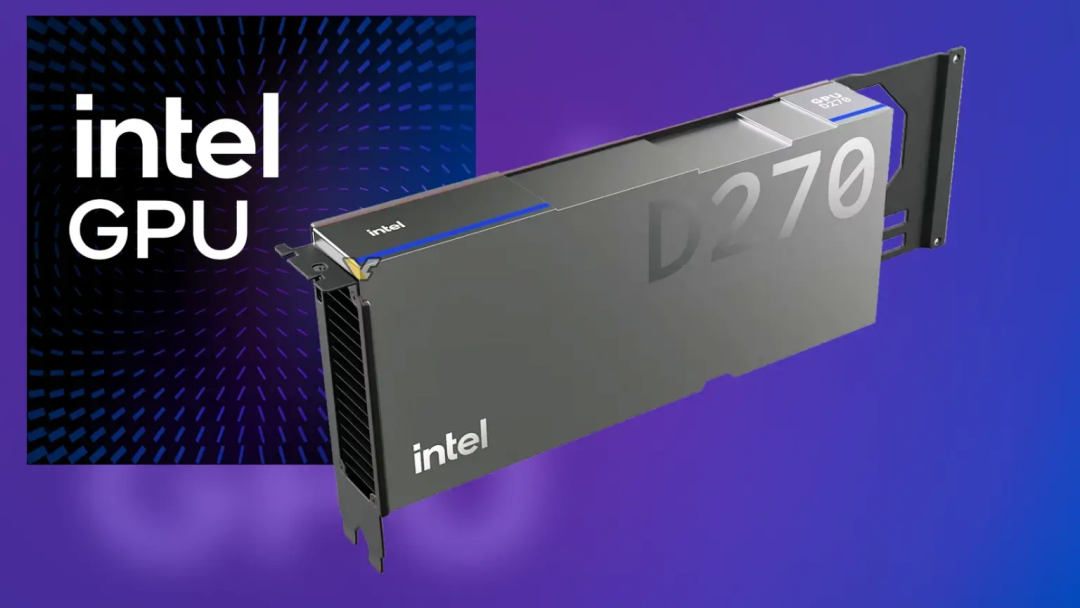
一张"内存卡",顺便带了个GPU
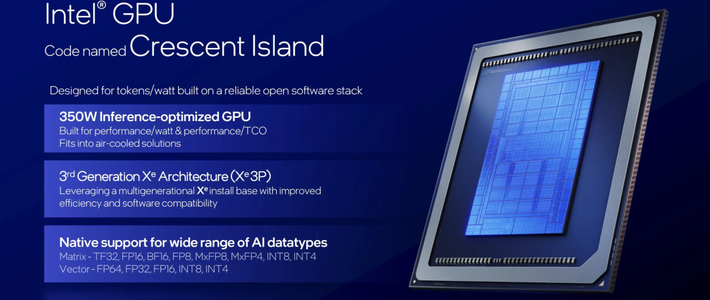
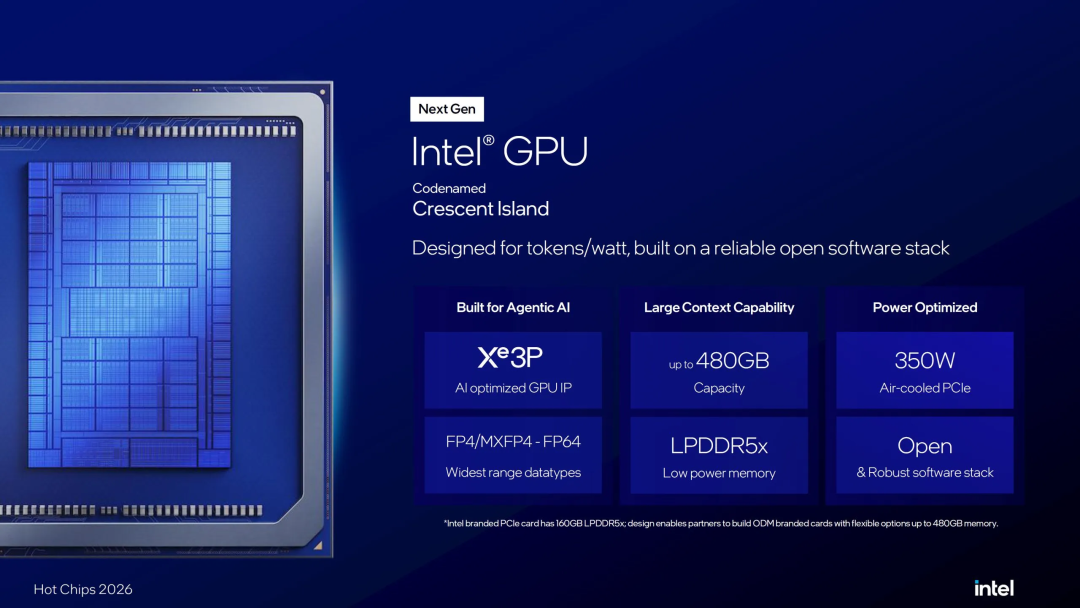
10月12日,英特尔把代号"新月岛"(Crescent Island)的 AI 推理加速器正式定名为 GPU D 系列,首发旗舰就是 D270。规格表拎出来看:哔哩哔哩
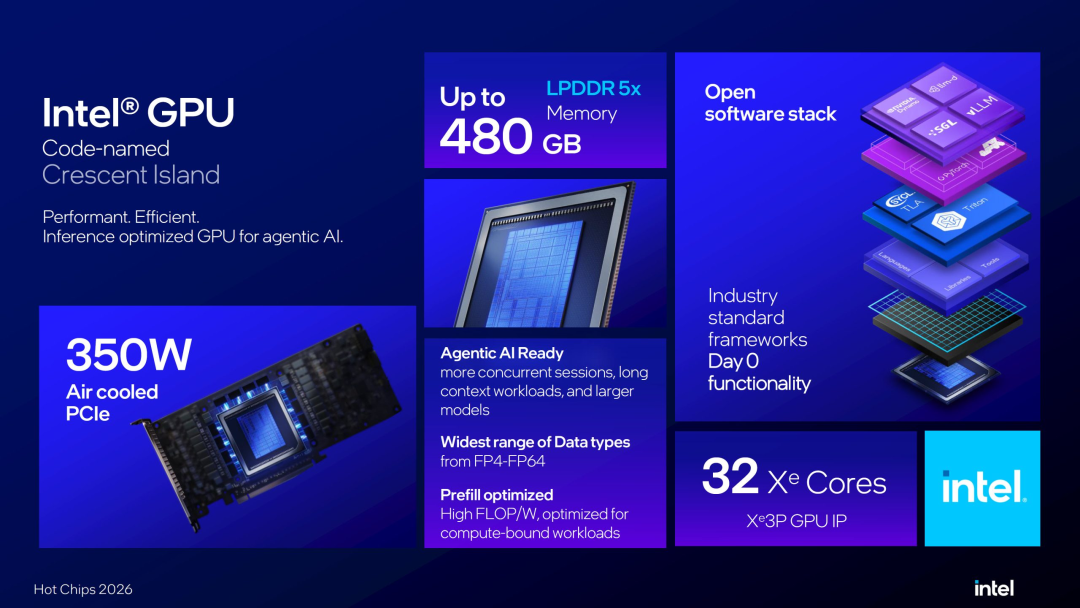
Xe3P 架构,32 个核心、256 个 XMX 矩阵引擎,统一 L2 缓存 32MB。知乎
芯片由台积电 N3P 工艺代工。哔哩哔哩
FP8 峰值算力 1.3 PFLOPS,内存带宽 1.5TB/s。
全系 LPDDR5X:英特尔自家参考卡 160GB,合作伙伴 ODM 版最高 480GB。芯东西
整卡 350W,PCIe 5.0 双槽被动散热,风冷机柜直接插。
官方口径:单卡承载 3000 亿参数模型,八卡集群跑万亿参数。知乎
480GB 是什么概念?纸面上已经压过 AMD MI450X 的 432GB 和英伟达 Rubin 的 288GB——这俩可都是要用 HBM4 的旗舰。知乎
三个"反直觉"的取舍
D270 最有意思的不是参数,是它敢砍什么。
第一,不用 HBM。Rubin、MI450X 都押注 HBM4,但 HBM 供应紧、价格一路走高。英特尔的判断是:推理负载尤其是解码,吃的是"每瓦、每美元能装多少",不是峰值带宽。于是用笔记本上常见的 LPDDR5X 并行堆出 1.5TB/s——带宽确实不如 HBM,但单位容量成本低得多,480GB 才堆得起。知乎知乎
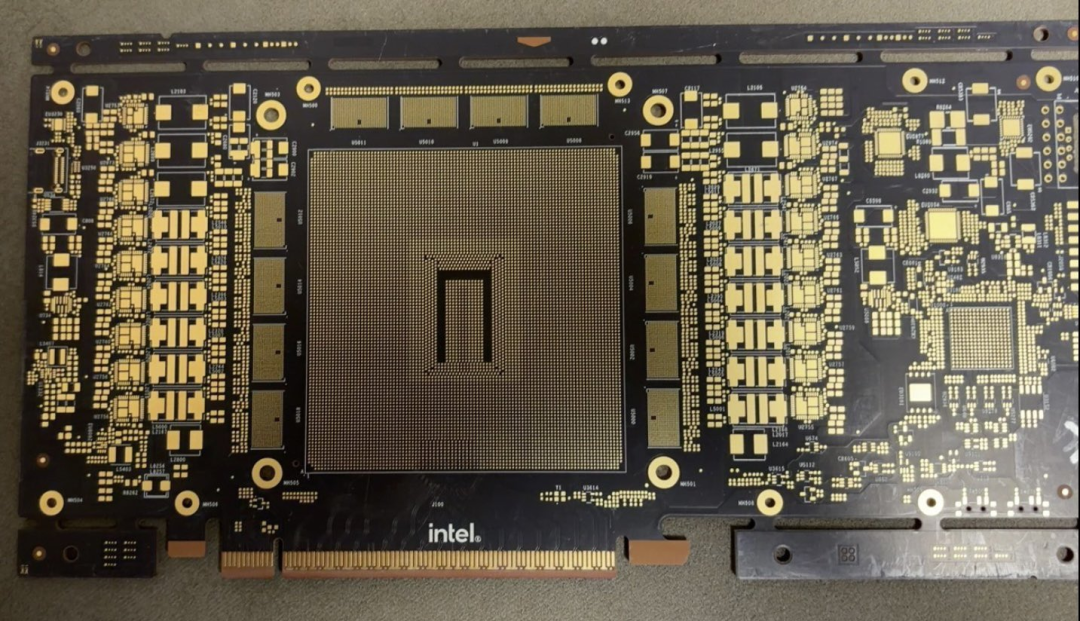
第二,3D 和光追硬件单元直接移除,芯片面积全留给 AI 计算。这不是一张"也能打游戏的卡",是一张纯粹的推理卡。知乎
第三,风冷不上液冷。350W 被动散热意味着标准服务器机柜即插即用,不用改造冷却。对想自建推理机的企业,这条比算力更省钱。芯东西
另外它原生支持 MXFP4/MXFP8 微缩放量化格式,低精度推理走硬件加速,不用软件模拟。知乎
软件生态:这次没摆烂
硬件堆得再高,软件拉胯照样白搭——这是英特尔数据中心 GPU 的老毛病。这次它给的答卷:统一 Xe 软件栈,与 Arc Pro 系列二进制兼容,之前在蓝戟 B70 上跑的代码不用重写就能迁移。运行时支持 vLLM、SGLang、llm-d,甚至兼容英伟达家的 Dynamo 调度框架,还针对长上下文智能体负载做了 KV 缓存感知路由。态度是端正的,但也要说实话:数据中心 GPU 的生态成熟度,英特尔离 CUDA 还有肉眼可见的距离。知乎芯东西
对普通玩家的诚实账
先泼冷水:D270 是数据中心卡。目前刚向服务器 OEM、云厂商送样,完整上市要等 2027 年。而且 1.3 PFLOPS 的 FP8 算力比 AMD MI350P 的 2.3 PFLOPS 低了约四成,第三方实测一片空白。现在喊"吊打英伟达",为时过早。知乎知乎
但它确认了一件事:本地 AI 的瓶颈不是算力,是内存。从 B70 的 32GB,到统一内存架构,再到 D270 的 480GB,全行业都在往卡里塞内存。评价 AI 硬件的指标正在从"算得多快"变成"装得下多少模型和上下文、能同时跑几路智能体"。
2027 年正式上市时,如果 LPDDR5X 的成本优势真能兑现到价格上,"每个公司机房塞一台推理机"这笔账就算得过来了。在那之前,玩本地模型的朋友继续加显存——这个方向,英特尔替你们验证过了。