
Vera Rubin假期投产、OpenAI首颗芯片也跑起来了:4.8倍是GB200的账、780万一台机柜GPU只分走一半——链上持股党节前把这四本账对完
国庆假期这72小时,英伟达算力链几乎同时点亮了两件看起来互相打架的事:一边,下一代整机柜Vera Rubin NVL72宣布正式投产,云商CoreWeave已把它放进商用云平台向客户接单。 另一边,OpenAI放出自家第一颗推理芯片Jalapeño的部署细节,主机搭档明说了是AMD,不是英伟达的新CPU。夹在中间,10月4日美股周五收盘,英伟达股价盘中摸到237.88美元历史新高、市值约5.7万亿美元,距6万亿只差一步。东方财富知乎
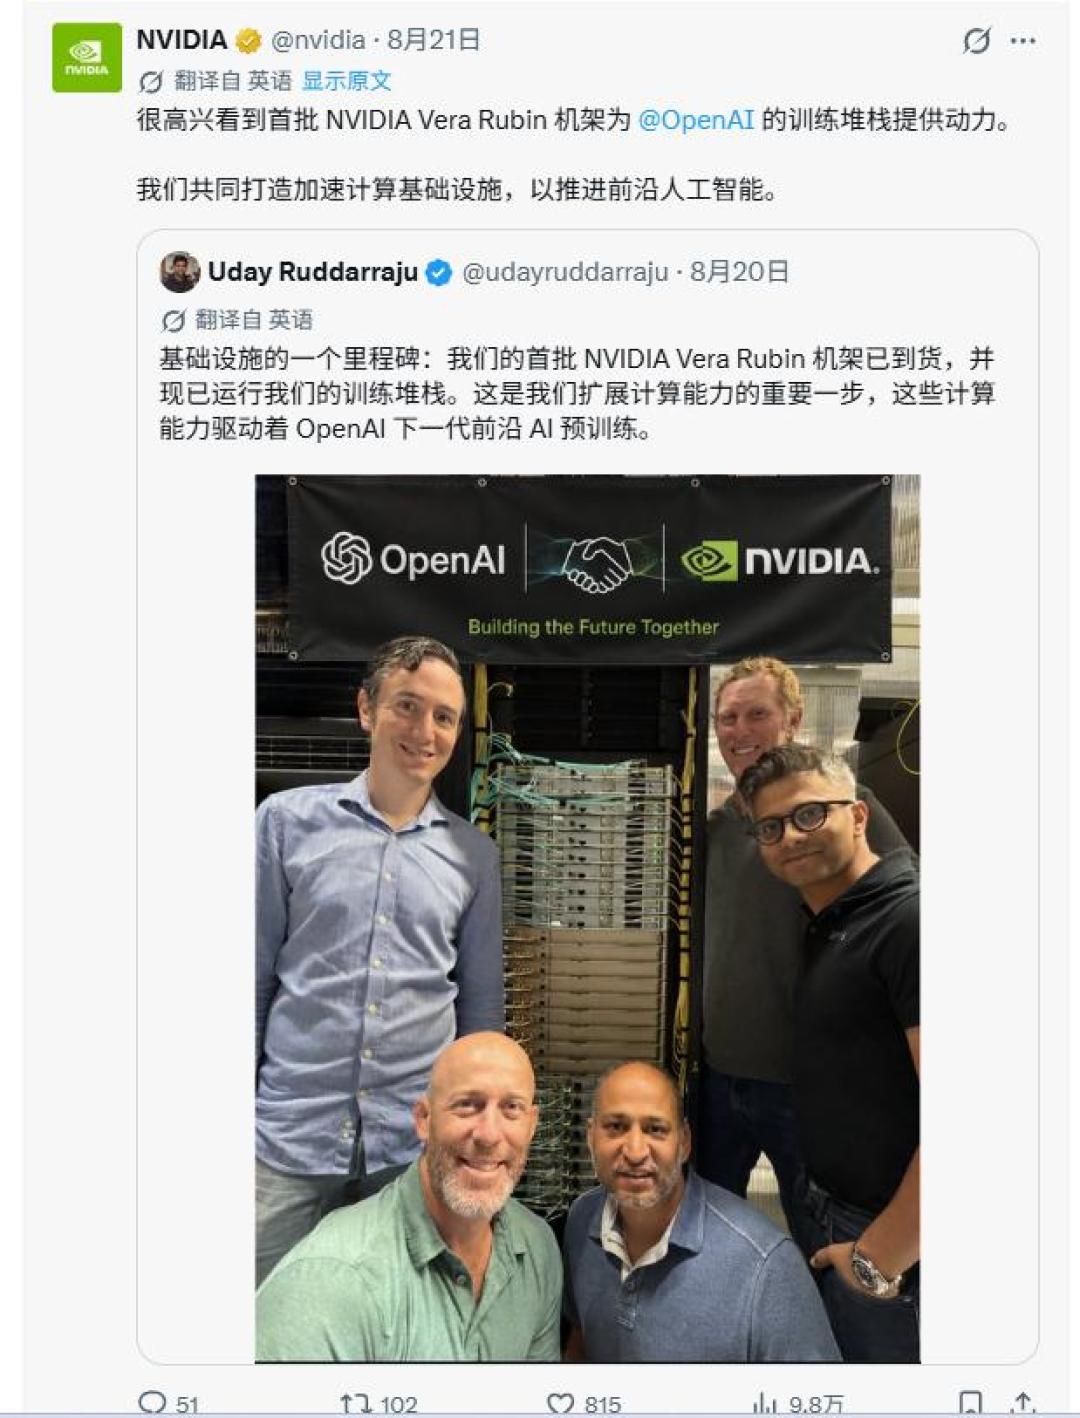
市场的投票结果是"两头都没输",但很多转发其实把两边都读反了:一种读法是"Rubin比GB300快近五倍",另一种读法是"OpenAI要掀翻英伟达"。给盯着英伟达链的持股党:节后开盘前,先把下面这四本账对完。
第一本账:4.8倍、3.7倍、1.7倍,是三个不同口径
先把三个最容易被混着用的数字拆开。
CoreWeave/NVIDIA口径(9月30日宣布投产):Cognition作为首个生产级客户,在Vera Rubin NVL72上跑SWE-2推理,总Token吞吐较GB200 NVL72提升最高4.8倍;强化学习场景每GPU输出Token是GB200的3.8倍;DeepSeek-R1推理基准里,每兆瓦Token达到GB200 NVL72的10倍。 注意,三个数字全部对标GB200——上一代,不是GB300。东方财富

MLPerf口径(9月20日提交的v6.1预览测试):对标的才是GB300 NVL72——Qwen3-VL(vLLM+Dynamo框架)吞吐最高3.7倍,DeepSeek-R1(TensorRT-LLM)约2.5倍。 基准越接近当前代,倍数越小。谁要是把"4.8倍"当成对GB300的预期,第一本账就没对上:对现在主力部署的GB300,合理预期是"三倍上下",不是五倍。哔哩哔哩
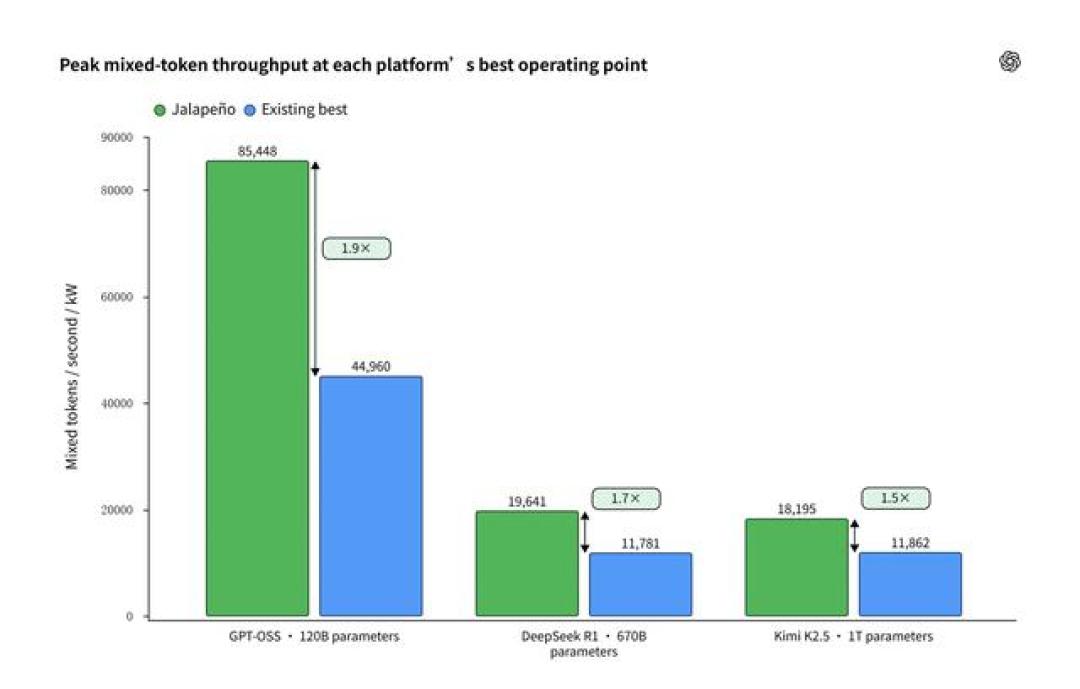
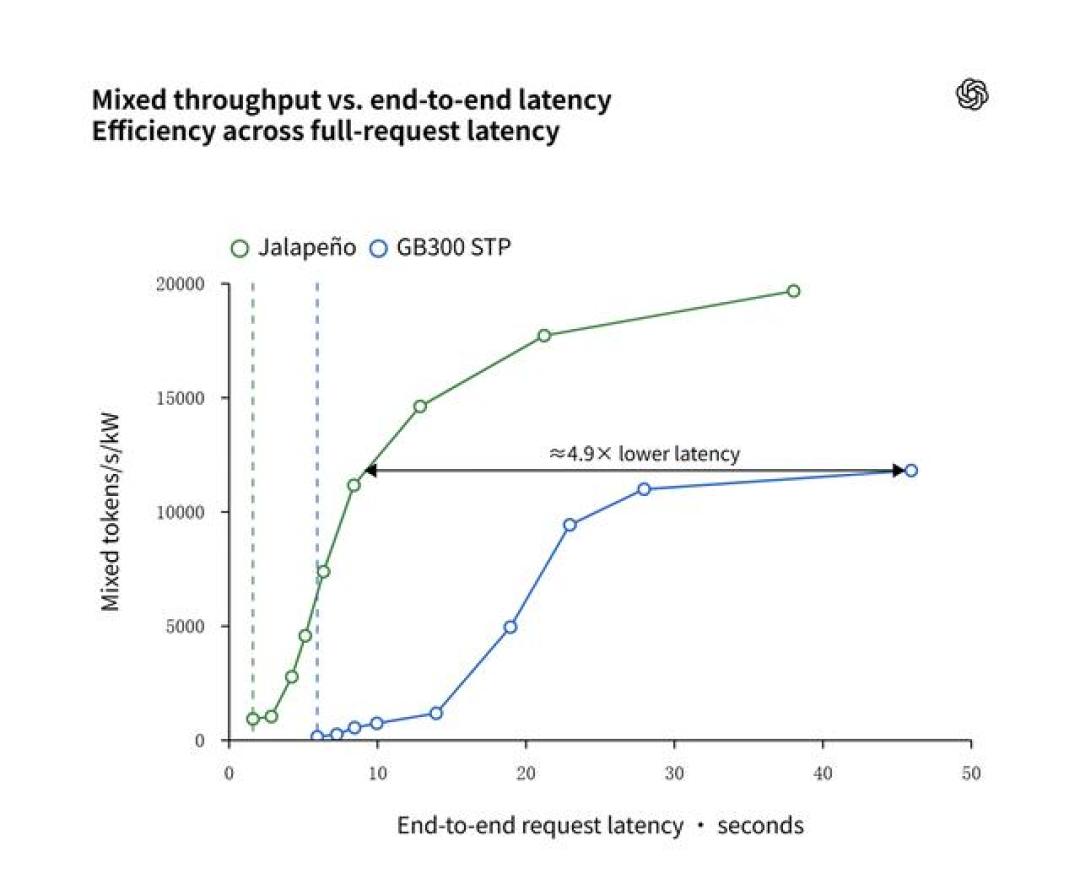
OpenAI口径(8月25日公布首测、10月2日补部署细节):Jalapeño跑DeepSeek-R1的每瓦AI吞吐是GB300的1.5至1.9倍(自报数据,非第三方),端到端延迟只有对手的28%–59%。 这颗芯片只做推理、只在内部使用,1.7倍是"OpenAI自己的电费单",不是所有租卡用户的账单。微博
第二本账:一台机柜约780万美元,GPU只分到一半
Vera Rubin NVL72的官方规格很直白:36颗Vera CPU+72颗Rubin GPU、100%全液冷,无缆线模块化托盘把安装时间从两小时压到五分钟。 CoreWeave还第一次把Vera CPU当独立计算层卖——单机架128颗、共11264核,支撑超过11000个并发隔离沙箱。东方财富

更关键的是钱的分配。据产业拆解与股吧流传的测算口径(非英伟达官方披露):这台代号为VR200的机柜成本预计高达约780万美元,比上一代整整翻倍,内存占BOM的比重将超过25%。 GPU占BOM的比重从63%回落到51%,存储类成本暴涨435%、占比从不到10%冲到26%。 算增量:这代比上代多花的钱里,存储抢走约163万美元,比GPU的约144万美元还多。东方财富哔哩哔哩
周边同样在加码——单机柜内存价值从约40万美元涨到约200万美元。 同一段里交换芯片约+7.9万美元,MLCC用量单柜涨超八成,钽电容单柜约7000颗、钽价因此涨超150%。 这些仍是自媒体测算、待上游财报验证;而这一代的账单里光模块几乎不在场,光互联的增量被记在2027年Rubin Ultra NVL576(八机柜互连)的scale-up上。哔哩哔哩哔哩哔哩
热这边有机构数:摩根大通10月3日测算,单机柜冷却部件价值从GB300 NVL72的约4.83万美元提到Vera Rubin的约6.63万美元。 均热盖按Rubin为1倍基准、Rubin Ultra提升4–5倍。 机柜本身250kW、约1.8吨,进水温度45℃、风扇一个没有,供电则从上一代的48V直接干到800V。知乎东方财富哔哩哔哩

所以第二本账的结论不是"链上大利好",而是结构:英伟达把销售单位从芯片抬成了一整个机柜,但增量里的钱更多流向内存、热管理、被动元件和电源——"英伟达链"不再等于英伟达。
第三本账:OpenAI切走的不GPU,是"配套层"
Jalapeño的定位要先钉死:它是一颗ASIC,由OpenAI和博通共同开发、走台积电3nm工艺,只做推理加速、不训练模型,暂无对外销售计划。 规格上有13.4 PFLOPS的4-bit算力、232GB HBM4与15.4TB/s带宽。 研发端更值得记住:不足百人团队、约9个月从图纸到流片,靠自家的Codex和GPT-Astra在两个月内给三个原本不在生产计划里的开源权重模型补上了高性能内核。知乎微博微博
最扎心的一刀不在参数,在主机:这颗芯片已经在OpenAI内部跑起来,搭的是装满1.5TB内存的AMD EPYC Turin主机。知乎
OpenAI副总裁兼硬件主管Richard Ho给出的理由是"务实"——Turin性能够用、伙伴生态熟、能加快部署,而英伟达今年新推的Vera CPU在成熟度上"略显落后"。 一台加速卡不能自己跑,CPU、内存、网络、散热这些"配套位",过去默认是英伟达全家桶的一部分。知乎
三个常见读反:①"OpenAI成功=CUDA完了"——被切走的是它自家一块推理负载,训练和通用场景原样;②"选AMD=AMD更强"——这是一次工程求稳(不敢同时上两颗全新平台),不是榜单更替;③"自研=API要降价"——先省的是OpenAI自己的电费,规模不够,传导到用户账单还有距离。反证也别忘了:纸面数据之外,产能能不能出来、良率如何、系统级软优化做得怎样,仍是英伟达的隐性护城河。 目前这轮只能算"分工再切一刀",不算趋势成立。微博
第四本账:投产≠放量,假期只盯四个信号
"投产"听起来像终点,产业链里它只是爬坡的起点。有行业跟踪显示,台系电源厂已把Blackwell向Vera Rubin的平台切换列进营收递延的原因——转换期的行业语言就是:订单在后移、放量在后面。 节奏共识是2026年验证爬坡、Rubin Ultra(NVL576)要到2027年下半年才投入量产。东方财富东方财富

节后不用表态,盯这四个兑现信号就够:
MLPerf Inference v6.1正式版成绩与对标代际(预览版是3.7倍,正式版口径会不会变);
英伟达下一份财报里,机柜级系统的收入确认节奏;
内存、PCB、热管理、电源四个钱包各自的Q4财报毛利率——Rubin配套110kW电源四季度放量则是被机构认为相对确定的趋势。 “约780万”"涨435%"这些测算要靠这些数字验证;东方财富
OpenAI对Jalapeño"未来推到更广场景"那句口子,会不会松成对外服务。
分人群:节后第一天,各走各的那步
链上持股党:别按"Rubin概念"贴标签,按钱包成熟度分层——已兑现(内存涨价已经写进存储大厂财报)、机构测算(摩根大通的冷却部件价值量)、传闻待验(MLCC/钽电容用量、石墨烯垫片报价单CPU约70-80元/片、单GPU约130-140元/片)、2027才兑现(VRU光互联)。只有第一类能聊业绩,后三类只能聊估值,而估值最容易被"转换期递延"直接按回去。东方财富
租卡党/智能体团队:CoreWeave这代顺手卖的东西对你更实在——Vera CPU独立计算层单机架128颗、11264核,可支撑超过11000个并发隔离沙箱,智能体沙箱启动比x86快3倍以上。 外加把实验追踪、评估、部署打包好的Forge环境;真正该盯的是Vera Rubin实例定价,以及它会不会压低GB200的存量租金。东方财富
装机党/等卡党:这代机柜账跟你的装机单没关系;"RTX 6090发售时间爆料:英伟达Greenlights Gaming Rubin"目前只停留在外媒爆料视频里,没进官方日程。 等显存放量还是等2027年,别混着等。哔哩哔哩
看客:同一晚英伟达晒机柜、OpenAI晒辣椒(Jalapeño),说明竞争坐标已经从"单卡峰值算力"挪到"整套系统谁搭得快、跑得省"。市值回顶不是给任何一边判决,是给"谁都没法短期替掉谁"定价。
Ian Buck在投产官宣里特意提到:CoreWeave机房里的V100 GPU至今仍在运行客户工作负载,而Vera Rubin NVL72已进入生产。 这被他用来证明"这是平台跨代持续创造价值"。同一句话也能反过来读:客户不肯走,也说明客户确实还没走。证据覆盖到几代口径,结论就只能说到几代:节前这四本账,对完再动。东方财富
(本文是公开信息整理与口径核对,不构成任何投资建议。)














