10月17日到20日,DeepSeek连续推出三款产品:新模型V4.1 Flash-1017、开放计费的自研搜索Search/Fetch API、全面开源的推理框架DeepInfer。拆开看是三则发布,连起来看是同一件事——三款产品全部对准"单位任务成本"这一个点。AI赛道的竞争重心,正在从榜单分数转向谁能用更低的钱把一个真实任务完整交付,这才是"卷出新高度"的实际含义。
模型:把竞争坐标画在成本轴上
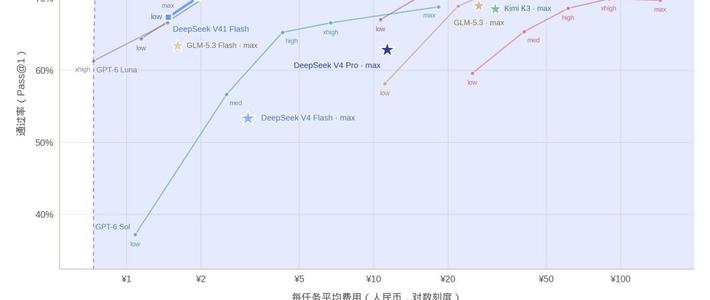
10月17日,DeepSeek把新模型V4.1 Flash-1017推上线,官方评测罕见地把横轴画成了钱。在DeepSeek公布的DeepSWE v1.1评测图中,新版本最高通过率(Pass@1)达到77.0%,上一版本最高点约为74%,而取得最高分的档位,每项任务平均费用约1.3元,显著低于图中不少性能接近的海外模型。 单项任务的平均费用,较上一版本下降了约六成。凤凰网科技智东西
10月19日,AI模型评测平台Arena宣布,该模型成为CodeArena:WebDev榜单上排名最高的开源模型,得分1670分,超过Kimi K3(Max)、Claude Opus 5(High)、Grok 4.7(xHigh)等闭源模型,仅落后GPT-6 Sol(Max)12分。 更高的成功率配上更低的成本,DeepSeek等于把问题抛给了行业:那些依赖高价维持竞争力的模型,需要拿出什么来证明自己的溢价?智东西凤凰网科技
API定价同样压得极低:高峰时段每百万Token输入2元、输出8元,空闲时段减半,命中缓存的输入低至0.02元,综合成本约为Kimi K3的十分之一。 这是一款总参数552B、推理时仅激活8B至16B的稀疏MoE模型,官方称其通过自反馈强化学习获得了处理"许愿式"编程需求的能力,并针对自家Harness与腾讯CodeBuddy、WorkBuddy等框架做了优化。智东西智东西凤凰网科技
搜索:免费午餐到期,平台生意起手
伴随模型更新,DeepSeek开放了自研搜索引擎的Search与Fetch接口,分别用于检索网页和抓取正文,与主API共用鉴权,各限速每秒5次。凤凰网科技AI唱反调
公告的定价是每1000次成功请求5元(约0.75美元),失败、无结果、超时均不计费,11月1日起正式收费。AI唱反调
这两个接口此前已内嵌在Harness、Claude Code、Codex的工作流中免费运行,开发者并没有太多感知。 换句话说,先用免费期让"模型自己会上网"成为习惯,再在11月拧上计费阀门——平台生意的经典起手式。凤凰网科技
这个价格放进国际市场相当激进:Tavily约8美元/千次,Brave Search和Google Custom Search约5美元/千次,DeepSeek约为主流方案的一折到两折。 在主流大模型厂商中,把自研搜索引擎作为独立API对外开放也是不多见的动作。AI唱反调
不过要保留一个边界:DeepSeek没有公布任何搜索质量指标,"能用"和"好用"之间的距离,要等11月1日之后的真实账单来检验。AI唱反调
推理框架:把降本的管道直接开源
10月20日,DeepSeek宣布全面开源内部推理框架DeepInfer,并同步开源Token编解码组件deepseek-recipe,兼容英伟达与华为昇腾平台。华尔街见闻
官方披露的生产数据显示,基于该框架,V4.1 Flash单一集群日吞吐达155万亿Token,按谷电价计算每卡每小时收入38美元。华尔街见闻
缓存是这些数字的另一半。BlockKVCache存放在独立的3FS分布式文件系统中,存储容量约100PiB。 据DeepSeek披露,Agent流量的缓存保留3天、聊天流量保留7天,命中即省去重复计算;Prefill与Decode分离部署、动态投机解码则进一步压缩延迟与算力浪费。华尔街见闻
但DeepSeek没有一次亮出全部底牌:KVCache管理和负载均衡部分因与内部基础设施耦合较深,相关代码目前尚未完整开源。 开源的是能帮行业降本的通用部分,留下的是自家服务的效率护城河。华尔街见闻
为什么是这个星期
把三件事挤进同一周,最直接的压力来自赛道本身。10月19日,MiniMax认领匿名模型并发布M3.1Flash,在同一张DeepSWE v1.1榜单上拿到73.7分,与DeepSeek的77.0分只差3.3分,代码修复等个别科目甚至完成反超。 价格上,MiniMax把新模型的输入、输出价格降到上一代的一半,缓存读取价格再降约75%。 过去Flash意味着牺牲能力换低价,如今Flash开始正面抢旗舰的饭碗——一次模型降价的领先窗口被压缩到以天计,DeepSeek把模型、搜索、推理基础设施一起做完,是要把"便宜"从一次性的发布话题变成一套难以复制的系统。智东西凤凰网科技
资本节奏是另一条线索。10月中旬的报道提到,DeepSeek融资规模翻倍至约1000亿元、新一轮投资方基本确定、IPO节奏加快,另有追踪报道称交易仍在动态变化。 此前已有报道称其年化营收突破10亿美元。 上市临近,连续三件套更像一份面向资本市场的技术证明:降价不是烧钱换规模,而是从训练、联网到部署的全栈成本控制能力。36氪36氪36氪
一个尚未证实的联系是:10月15日DeepSeek网页与API曾出现全球性宕机,这是否与发布节奏有关,官方没有给出任何关联证据,社区猜测只能停留在猜测。量子位
对用户来说,这场"卷"暂时只有好处:编程智能体的联网成本、模型调用价和私有化部署门槛,正被同一家公司往下压。接下来值得盯住的两个节点,是11月1日搜索接口正式收费后开发者的去留,以及MiniMax们会不会在缓存定价和推理开源上跟进——如果答案都是肯定的,AI赛道的价格战才算真正卷进基础设施层。