10月14日,阿里巴巴通义 Qwen 团队在 GitHub 开源了一个名为 BlenderWorld 的评测基准,让 AI 到建模软件 Blender 里参加一场"3D 建模大考"。 考卷共 223 个任务、2651 条二元评分标准,13 个前沿模型同场作答。 拿第一的不是 Qwen 自家模型,而是 OpenAI 的 GPT-6-Astra,综合得分 79.9;Qwen 阵营成绩最好的 Qwen3.8-Max 只有 60.6 分,排第五。更扎眼的是,连榜首模型都没能在超过一半的任务里通过全部检查——今天 AI 3D 建模的真实水位,是做可用的初稿还凑合,直接投产还差着一截。IT之家小红书BlenderWorld 官网
交的不是效果图,是工程文件
BlenderWorld 和以往"生成一张图比美"最大的区别在交付物:模型不能只渲染一张好看的画面,必须交出一个能在 Blender 里打开、继续修改的工程文件。 这条规则戳中了从业者抱怨最多的老毛病:过去一年 AI 通过 MCP 操控 Blender 的演示刷屏,但交付时缺贴图、尺寸对不上、工程打不开的翻车一直不少。 知乎上围绕这件事的提问,问的也是同一个关切。GitHub微博知乎
题库从真实需求来
223 道题出自真实的制作需求,按 9 大类、22 个子类编排,产品、建筑、自然环境、角色、动画和科学可视化都在范围内;其中仅给文字描述的 78 题,图片加文字的 130 题,视频加文字的 15 题,另有 59 题附带尺寸、材质、相机参数等硬约束。建筑和室内是最大的一类,独占 72 题,接近考卷的三分之一。IT之家
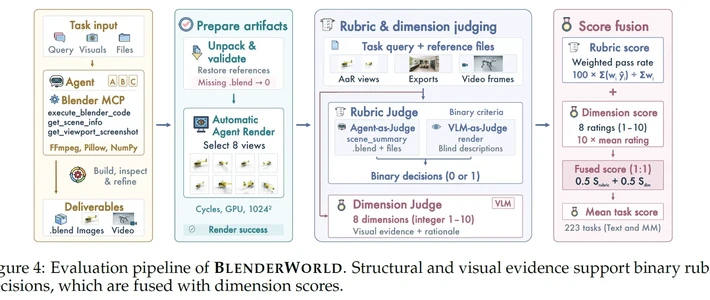
打分也不由出题人直接拍板:系统从 8 个自适应视角独立渲染作品,结构要求交给评审智能体钻进工程内部检查,画面观感由视觉模型对着渲染结果和动画帧评判,最终按"规则符合度 50% + 视觉质量 50%"合并成一个分数。 评分细则在生成阶段对模型保密,没交或交砸的任务记 0 分、留在总分母里。GitHub
成绩单:第一也只全对了四成任务
名次 | 模型 | 综合 | 规则符合 | 视觉质量 | 全通过率 |
|---|---|---|---|---|---|
1 | GPT-6-Astra | 79.9 | 87.3 | 72.6 | 42.2% |
2 | Opus-5 | 73.0 | 80.9 | 65.1 | 25.6% |
3 | GPT-5.6-Sol | 67.7 | 74.7 | 60.7 | 15.7% |
4 | DeepSeek-V4.1-Flash | 65.7 | 72.0 | 59.4 | 11.7% |
5 | Qwen3.8-Max | 60.6 | 65.9 | 55.3 | 10.3% |
6 | GLM-5.3-Flash | 59.7 | 64.8 | 54.4 | 6.3% |
7 | Grok-4.6 | 57.0 | 61.4 | 52.7 | 6.7% |
8 | Opus-4.8 | 57.0 | 60.2 | 53.7 | 5.4% |
9 | Seed2.1pro-0915 | 51.3 | 54.9 | 47.7 | 3.6% |
10 | Qwen3.8-27B | 47.7 | 50.0 | 45.5 | 1.4% |
11 | Kimi-K3 | 46.5 | 47.9 | 45.2 | 1.8% |
12 | Gemini-3.8-Flash | 34.2 | 29.8 | 38.5 | 0.5% |
13 | MiniMax-M3 | 31.8 | 28.9 | 34.7 | 0.5% |
(论文冻结跑分,0–100 分制,可在官方 leaderboard 复核)
表格里藏着三个比排名更有信息量的信号。其一,头部模型的短板不在"把活干完",而在"把活做好看":前五名的规则符合分全部高于视觉质量分,差距最大的正是 Opus-5(80.9 对 65.1);而垫底的 MiniMax-M3 规则符合分(28.9)反而低于视觉质量分(34.7)——作业没交齐,谈不上美观。其二,砸算力不等于涨分数:Opus-5 平均每题跑 158 轮、生成约 24 万 tokens,工作量接近榜首的三倍,分数却差 6.9;DeepSeek-V4.1-Flash 平均轮数更多,也只排到第四。其三,读懂图片和视频参考反而更难:多数模型多模态题的得分低于纯文本题,最大差距约 6 分,GPT-6-Astra 是唯一大幅反超的,图文任务上它拿到 80.7、比 Opus-5 高 8.6 分。 发布它的魔搭官方账号把难点收拢成三件事:细粒度空间关系、准确的结构还原,以及看过渲染结果后能否有效修正模型。BlenderWorld 官网小红书
出卷人排第五,阅卷的也是别人家的模型
这场大考最耐人寻味的是立场:Qwen 团队出的题,第一名是 OpenAI 的 GPT-6-Astra;连自动阅卷人用的也不是自家引擎——论文里渲染、检查、打分三个评审角色统一由 GPT-5.6-terra 担任。BlenderWorld 官网
阅卷的可信度也被单独验过一道:150 组同输入答案交给三名人类评审,主阅卷模型的综合打分方向与多数人类偏好一致的配对占 82.99%。BlenderWorld 官网
整套评测没有留私有后门:MIT 许可证开源,代码与数据集同步发布至 GitHub、Hugging Face 和 ModelScope,缺交或失败一律记 0 分计入总分母。IT之家GitHub
任何团队都可以拿自己的生成框架接入重考。GitHub
这场考试跟谁有关
对游戏地编、建筑可视化、电商渲染这类要拿源文件干活的人,BlenderWorld 第一次把"AI 能不能交付可编辑工程"变成了公开可查的指标,给出的答案是:当起点够用,当成品不行,验收仍然得回到 .blend 文件里做。复现考试的门槛不高,仓库跑在 Blender 4.2.10、Linux 和 Python 3.10 之上,评测端需要配一个有视觉能力的模型服务。 官网上还挂着 26 个任务、181 份提交的交互式展厅,可以直接在浏览器里转一转各家 AI 交出的工程。 就像一份行业周报的评价,这场大考的价值在于,它把"能展示"推进到了"能交付、能复查"。IT之家BlenderWorld 官网今日头条