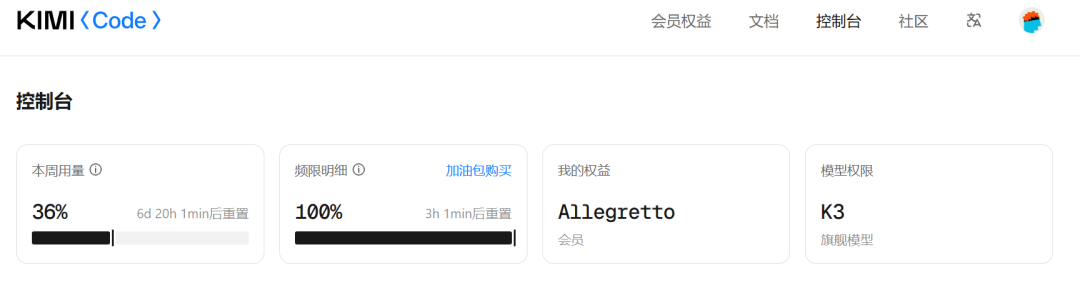
10月26日凌晨,Kimi智能助手发了一封致歉信:会员用K3.1 Pro出现限流和"不必要的额度消耗",官方认了错,给所有档位订阅会员重置额度。如果你是用KimiCode写代码的重度用户,发布那晚看着额度进度条哗哗往下掉——今天不是情绪日,是算账日。
第一笔账:补偿到底是多少钱的东西
官方原文值得逐字读:所有档位的订阅会员都将获得月度总额的25%作为补偿,相当于一周的用量,如果当前用量不足月度总额的25%,将重置为0。 翻译成人话:发布两天内把额度烧穿的人(这批人不少——社区里有"699档30分钟烧光""15分钟跑完额度"的说法,发布夜拉满思考档叠加Highspeed确实最费),这次基本等于额度清零重来;用得少的人,补的是你月度总额的四分之一。 不是退款,不是延长有效期,是额度。对靠KimiCode干活的人来说,这相当于回血一周,仅此而已。进度条今天结束前会显示调整结果,记得自己核一眼。新浪财经知乎
第二笔账:额度是怎么烧掉的——祸根不在计费,在默认配置
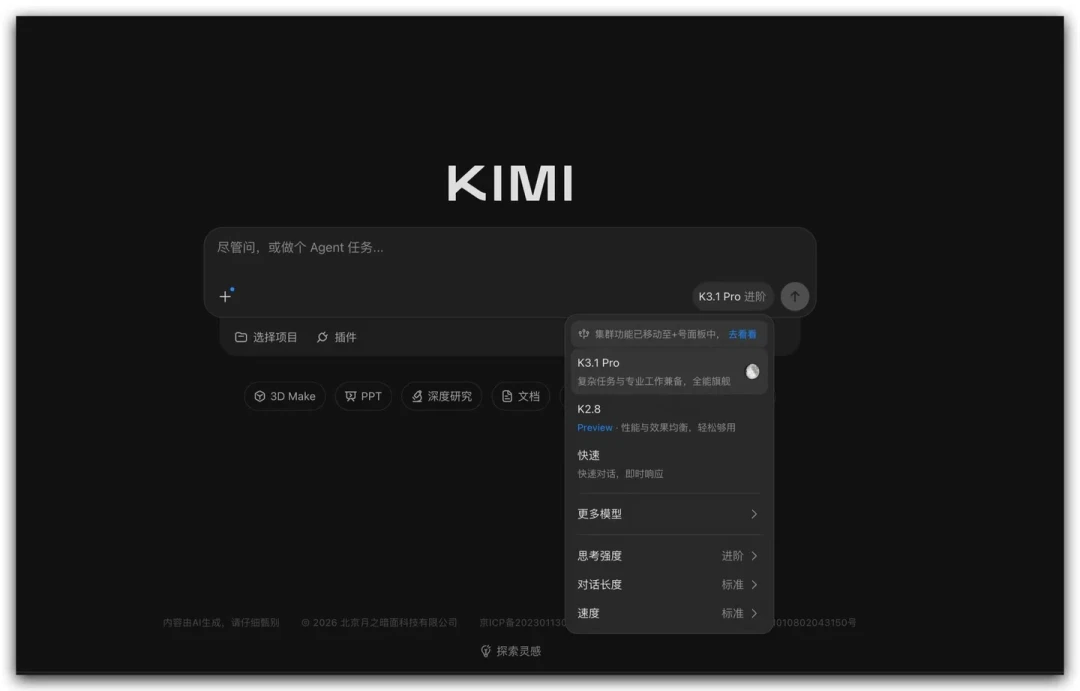
知乎致歉问题下有个把机制讲透的高赞回答:KimiCode之前默认思考强度是Max,开Max很容易生成一堆subagent,而subagent的思考强度直接继承主Agent——于是一群Max档子代理同时跑,K3.1本身输出又啰嗦,主子代理沟通频繁、每次输出都多,消耗直接爆表。 官方的整改说法恰好印证了这条链:“正在减少不必要的子Agent调用和输出长度。“致歉信里这句轻描淡写的话,其实是整篇里信息量最大的一句:官方承认了那些subagent调用"不必要”。 修复后用户的实测也出现了:有评论反馈,现在你不显式开subagent或者点开swarm,默认一个子代理都不开,“也能干活而且省多了,就是慢些”;另有用户提到桌面版会调更轻的模型做subagent,比CLI版省。但也得听反方:同样在评论区,有人说"没有子代理一样跑得飞快,单纯是套餐额度太少——论每任务token消耗,Kimi在国模里已经是效率最高的”。两种说法都还没法被证实或证伪,能带走的是可执行的部分:这一轮之前,把你的思考强度从默认Max降下来,非必要别开swarm,这是当下任何档位都成立的操作。知乎微博
第三笔账:同一个模型,"差Opus 0.7分"和"全球第一"是同一张跑分表
K3.1 Pro本身值不值得用,现在全网只有一种数字两种讲法。官方发的是:Terminal-Bench 4.0得分65.7%,Claude Opus 5.5是66.4%,差0.7个百分点,GPT-6 Astra只有58.2%。 第三方机构Artificial Analysis独立跑分给出的是67%,并说这是该基准最高分——但它对比的是Claude Sonnet 5.5的64%,压根没放Opus 5.5。同一模型、同一测试,"最接近全球最强"和"超越所有模型"的叙事都成立。知乎
别急着骂谁造假:Agent类基准里,测试框架、对手集合、重试策略本身就是变量,挪几个百分点很常见。更耐看的硬指标是综合面:AA智能指数从K3的44分升到55分,多家媒体口径一致地给出"全球前四"。 价格倒是实打实降了——API三个档齐降三分之一,国内价输入13元/百万token、输出68元、命中缓存1.3元,AA口径的单任务成本约1.98美元,和K3持平,也就是能力涨了一截、单位成本没涨。 速度面有人替大家先试过了:发布当天就有用户在Kimi里实测K3.1 Pro,输出速度跑到每秒117个token。知乎知乎小红书
同时把争议也摆上桌,别只捡好的看:有知乎高赞回答指控K3.1 Pro的3D建模演示实际调用了外部建模模型;有海外博主晒出截图,称Kimi付费推广要求不标注广告,参与推广的创作者要提前交文案、获批准后才能发;还有人反映私测题集表现平平、“公开题集好、私测题集拉”。 这些都没有官方实锤,但它们的共同作用是给你的预期打折:跑分表上那0.7分,比我们以为的要松。知乎
第四笔账:11月4日开源权重,普通人到底该等什么
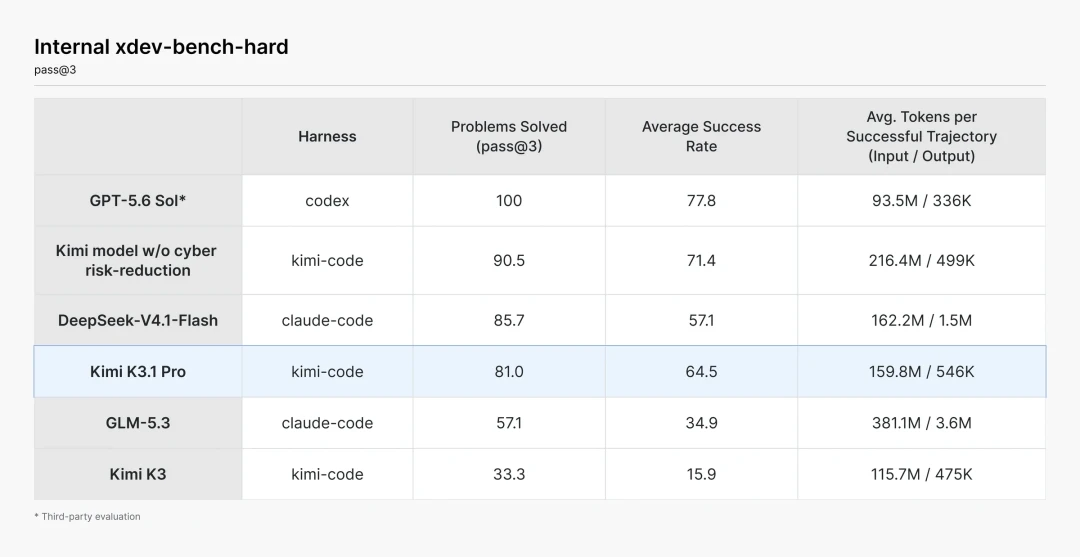
3万亿级(精确值2.8T总参、激活104B的MoE)、100万上下文、完整权重承诺11月4日前公开——这个体量,本地跑满血对绝大多数人是不现实的。 开放权重对普通编程用户的意义不在"装进自己笔记本",而在两头:一是11月后第三方部署商上线,低价API大概率继续卷价格;二是这次Kimi主动公开了自己为安全做的削减——中训练和RL阶段删除了网络安全数据,自家xdev-bench-hard从90.5%砍到81.0%,还写明了"开放权重≠不设防"的三条原则,这种透明度是后续评估开源版本能不能放心用的现成参照。知乎小红书知乎
顺带看一眼比价环境:DeepSeek V4.1-Flash-1017上线即登开源模型榜首,10月26日每经报道其单周调用量环比增801%登顶全球。 知乎有个高赞回答把"全世界值得付费的模型"列了六个,Kimi在哪个位置,各人的账不同——但至少说明,付费编程用户手里从来不止一张牌。知乎知乎
分档收口:今天各自该干什么
199/699档、额度已经烧穿的:等进度条重置到账,再决定开不开大任务;这一轮先别碰swarm,思考强度降档。
49元低档、想尝K3.1 Pro编程上限的:够做一次像样的评测,不够日常依赖;日常任务拿它和DS V4.1-Flash档位比价后再续费。
包年用户、正上火的:致歉信里"问题出在我们,我们也本应更早修复"这句,配上"补偿不补偿都是次要,改了会不会降效果"的技术担忧,才是值得盯的——AA榜单上目前只见Max档成绩,各思考档位的真实效果曲线还没人公开验证过。微博知乎
没订阅、在等开源的:11月4日前别急着重置你的工作流,盯第三方API价格就行。
Kimi这次暴露的真问题,其实不是烧了谁的额度,而是"跑分第一"和"体验翻车"可以同时为真。对付费编程用户,这反而是一条干净的观察信号:什么时候官方把每个思考档位的独立成绩像AA那样全量摊开,什么时候才轮到用钱包投票。