你以为算力不够是预算问题,其实多半是"社交"问题。
先说个扎心的现象:卡加了一倍,模型却没跑得快一倍——“算力不够就加机器"的那套扩张逻辑正在被改写。这不是玄学——并行计算里,活儿不只是"各算各的”,还得"互相说话":训练每走一步,成百上千张卡都要交换中间结果,卡越多,通信量越爆炸,单卡越来越多时间在"等发言"。行业里说得直白:任何一层跟不上,峰值PFLOPS都会被通信等待和故障恢复吃掉。36氪知乎
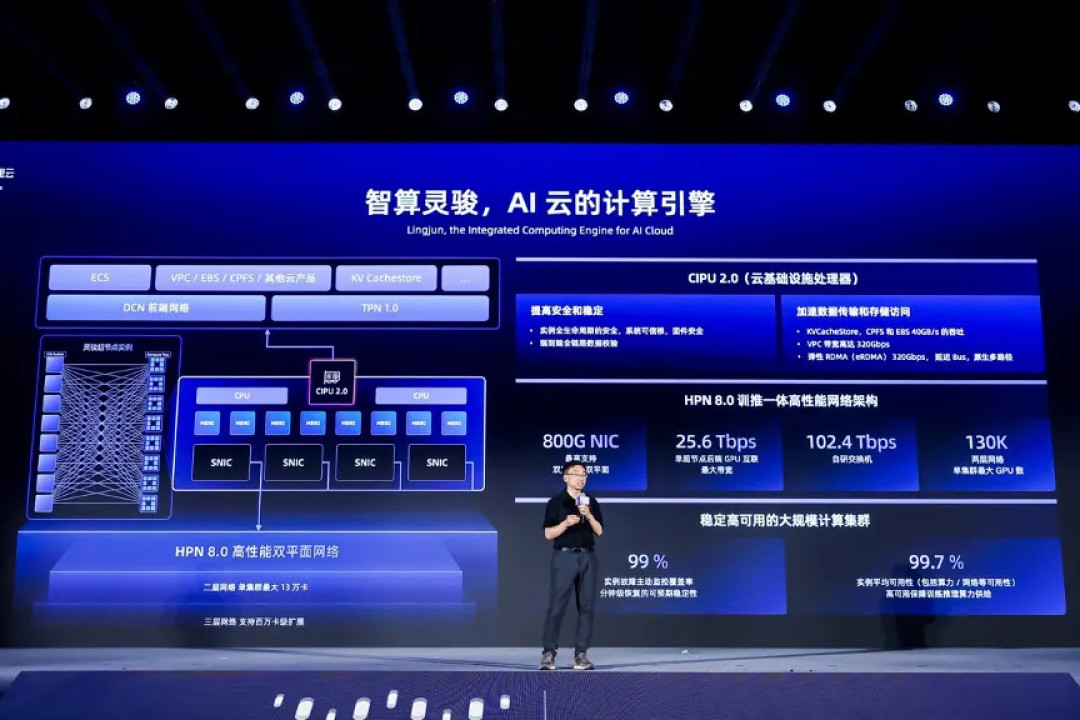
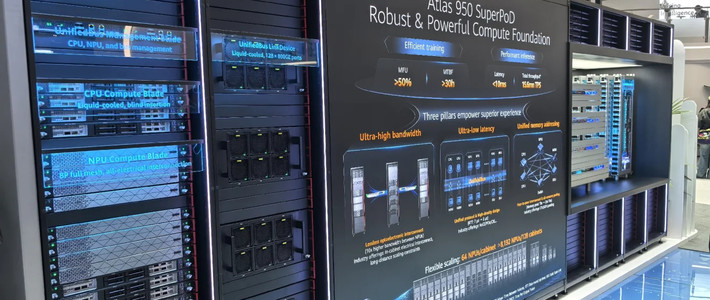
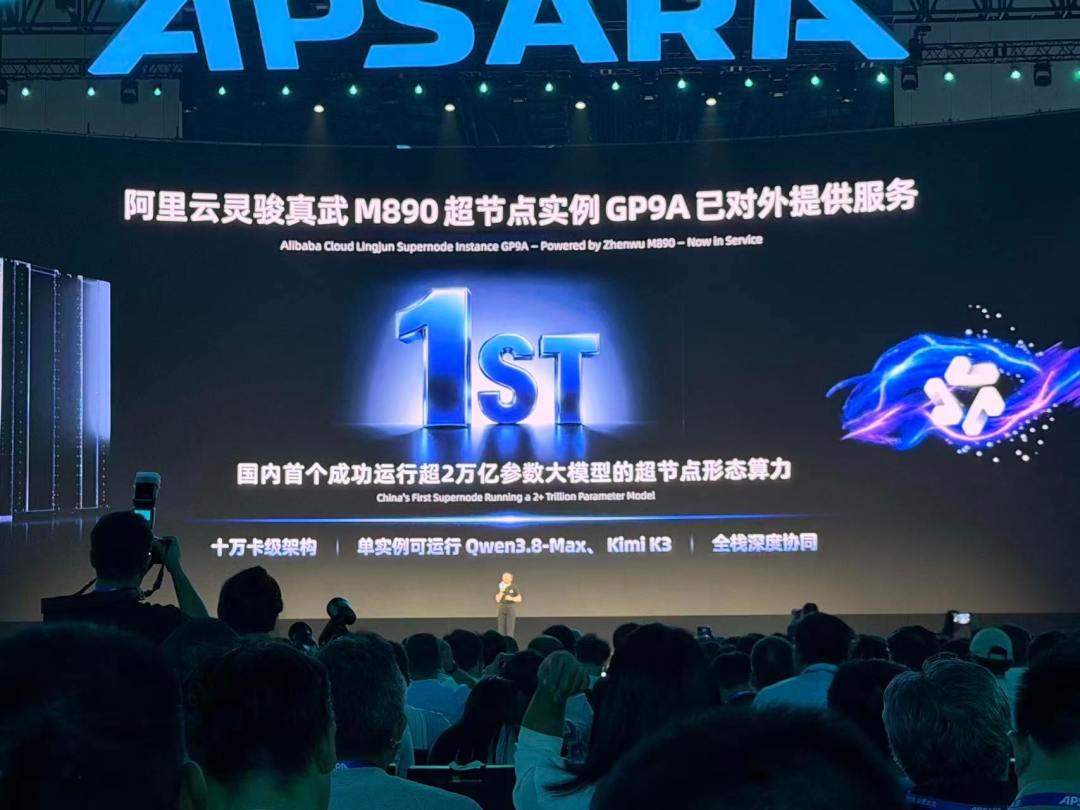
2026年GPU并行计算的主角超节点,解法就一句话:把"同屋办公"改成"合体"。普通集群靠交换机把卡串起来,传数据走PCIe和网卡的"长途走廊";超节点则用超高带宽把几十上千张卡连成一个大的"GPU",靠原生内存语义和统一编址,让A1能像访问本地显存一样读B2的显存。英伟达把72张卡焊成一柜(NVL72),后面排着144、576。华为昇腾384超节点直接对标NVL72,首套1024卡Atlas 950 SuperPoD液冷超节点已经点亮,为刚开源的阶跃Step5 Preview提供算力服务。阿里云的灵骏真武M890超节点实例也首次通过公共云对外提供,称单台可承载十万亿参数级MoE大模型推理。知乎微博IT之家
那到底是不是越大越好?评论区吵翻了——
质疑派说:没有内存统一编址,超节点仍是服务器堆叠。也有人笃定"64张卡就够了":普通8卡机干得了的活超节点照样干,只有跨卡通信很重的场景才轮到超节点上。同样的算力,英伟达可能7个机柜搞定,华为要多到160个机柜。单芯片不够强,就用数量补,但距离、可靠性和能耗全是新问题,甚至有对比直指"算力反超60%、代价5倍功耗"。36氪小红书哔哩哔哩
对关心GPU并行计算的人,真正的信号是评价口径变了:过去看单卡峰值TFLOPS,往后得看模型有效利用率、跨卡通信占比、故障恢复时间、单位Token成本。竞争单位正从"单颗芯片"转向"系统级协同",学习路线也得跟着挪:CUDA单卡基本功只是起点,多卡并行、互联拓扑、集合通信正在变成新考点。知乎
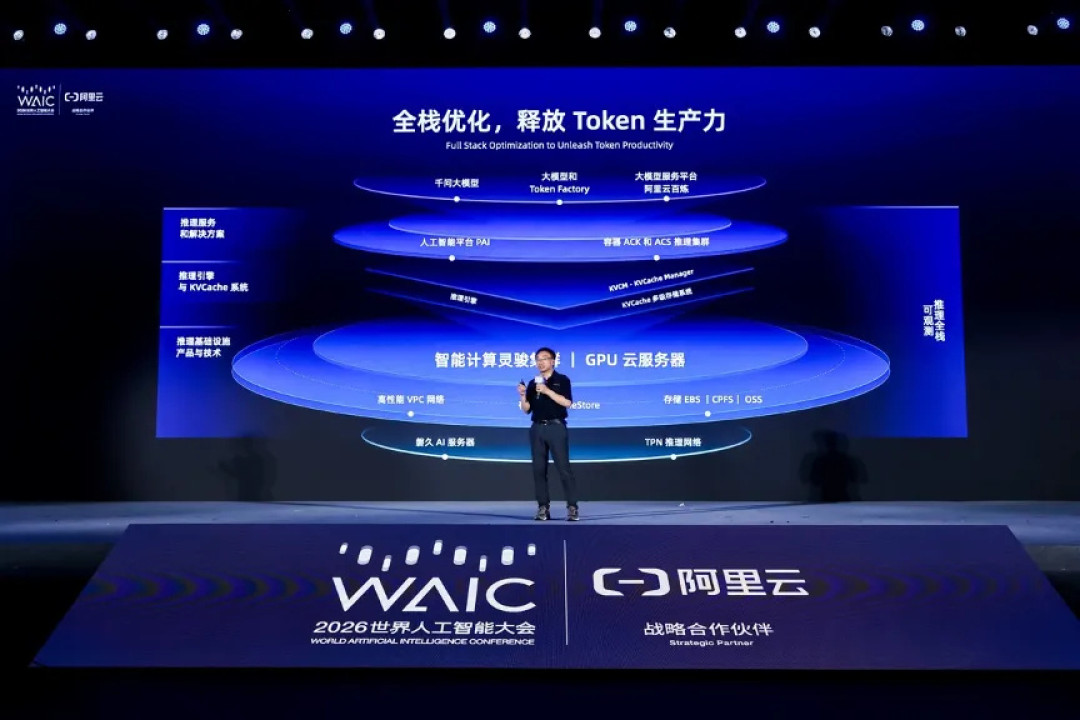
超节点火了一年,终局还没写定:昇腾超节点出货从300多套走到超1000套,统计口径仍有争议。昇腾960押注光互联,是业界首个采用NPO光引擎的超节点,可扩展至4096卡。汪涛还放话:十万卡以上的超节点集群2027年将成为基础配置,华为计划开放3D数据中心的标准化图纸与方案。卡越堆越便宜,让千卡"令行一致"才是难的那半——下次再看到"算力不够就加机器",先问一句:你的卡,真的互相认识吗?知乎微博知乎微博