先说结论:这半年的热闹,是"入场价"动了
前两年聊 Homelab,帖子下面是 NAS、软路由、相册、监控;2026 年 10 月再看同一个版块,关键词换成了"家里跑大模型"。十月初,一枚讲 ASUS GX10 小盒子从首次通电到 Windows 远程登录的避坑视频底下,排队问的是价格、版本和速度。另一位 UP 主直接开写系列:我想在家里搭一个本地 AI 环境,所以买了 4 台 DGX Spark,先从华硕 GX10 的实物讲起。知乎那边,"目前有什么可以本地部署的大模型推荐?"浏览量过百万,"本地模型部署划算还是付费买 Token 划算?"也有 73 万+。哔哩哔哩知乎
为什么突然密集?不是需求变了,是这三个月门槛连续挪了三次位:
10 月初英伟达发售 DGX Spark 64GB 版,被反复讨论的一点是:它和之前 DGX Spark 的区别只有内存容量的减半。128GB 版的门价,第一次有了平价替身。知乎
6 月公布的 RTX Spark 平台,10 月中旬搭载笔记本陆续上市,arm64+Windows 11 的路线刚开局;高赞评价一边承认 DGX Spark 有 CUDA、有成熟的 Linux,一边点名它本身内存带宽低。知乎
AMD 这边 192GB 统一内存的开发者平台 6 月亮相,8 月同平台用户晒出的消息是:被迫用 llama.cpp 撑了一年多之后,终于在 vLLM 上开始迎来了真正可用的一天。知乎
连"住得舒服"的配套也在补齐:NetBird 十月初大更新,一行命令就能安全暴露本地服务,中字教程称它正在成为家庭实验室远程访问的优选解法。Checkmk 的 homelab 监控教程月底也到了;甚至连"服务越装越多、IP 和端口记不住"这种琐事都有人专门做了发现工具。搭 lab 的理由没变,养 lab 的成本在降——这才是"装个 AI 回家"开始扩散的真正原因。哔哩哔哩
六条路线,从"零新增"排到"八台组网"
按现在帖子里真实有人在跑的方案,从便宜到贵排一列:
路线 | 门槛与预算量级 | 真实进展信号 | 最容易卡住的地方 |
|---|---|---|---|
① 吃老本:手上游戏显卡 | 0 新增 | 8G 勉强跑 9B 量化,16G 才算舒服 | 27B 要 24GB 起步,"16G 显存装不下 32B 模型、白花三千块"是现成的翻车案例 |
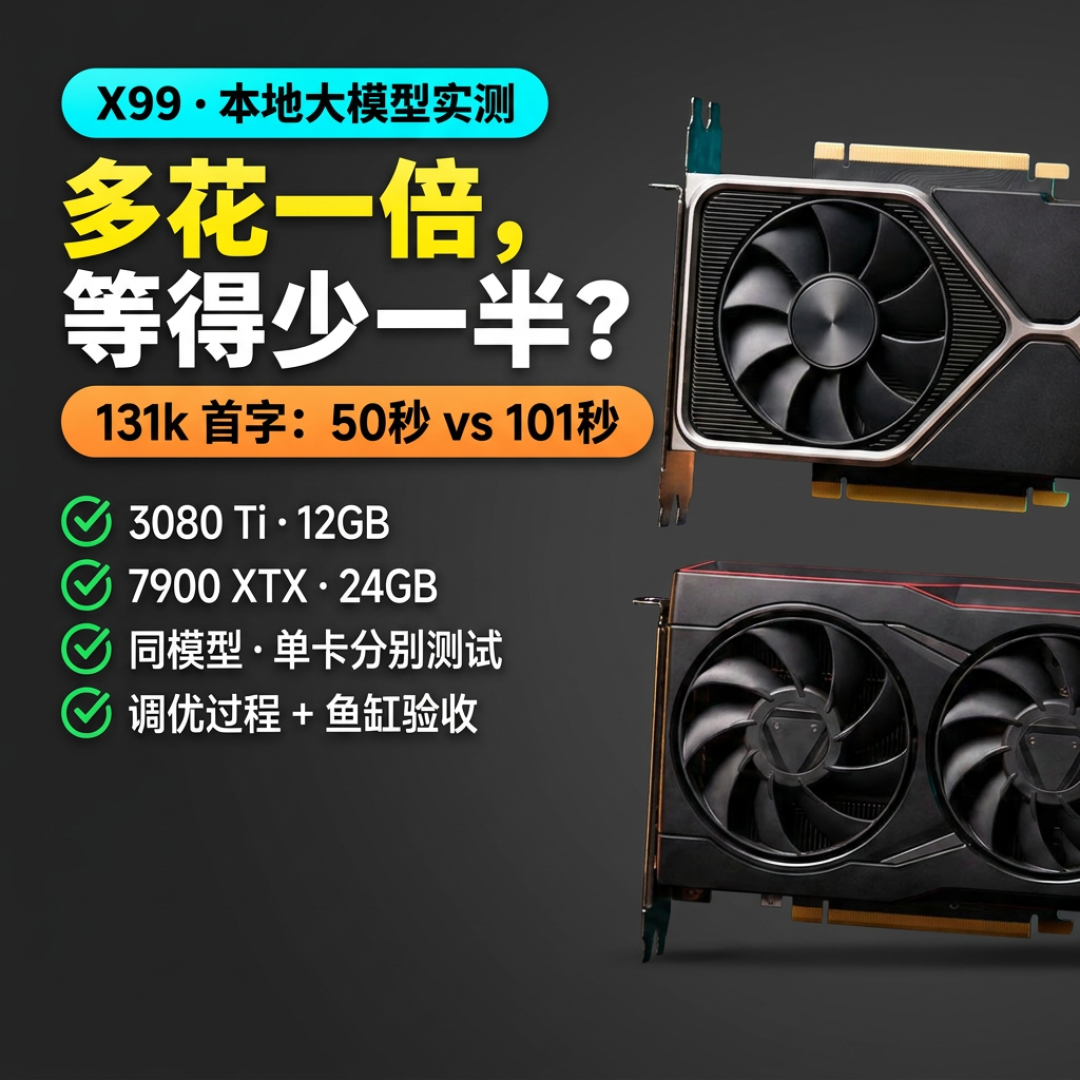
② 二手/甜点卡:3080Ti、20G 魔改、双 5060Ti、5090 | 三千到一万 | 3080Ti 对比 7900XTX 实测:12GB vs 24GB,带宽反而接近(912GB/s 量级);"三行命令"解锁 3080Ti 半精度后矩阵基准 8800→10455 | 基准涨 17.5% ≠ 体感快 17.5%,实测跑大模型的差距"意外"是这期视频的标题原话 |
③ 统一内存小主机:MAX+395 一类 | 五千到一万二 | 192GB 封顶;离线 AI+维基百科盒子用的是核显迷你机 | 推理栈支持进度决定体验,llama.cpp 和 vLLM 是两个世界 |
④ 英伟达"参考答案":DGX Spark / GX10 | 一万上下(64GB 版开平价小门) | 单机跑 Qwen3.8-Flash-Next 当 Agent 已有人实测 | 常规思路装不下 DeepSeek-V4.1-Flash,部署教程全在"绕路" |
⑤ 四台 QSFP 环形组网 | 四万级 | 实测峰值 494 tokens/s | 500GB 的模型 vs 4×128GB=512GB,“看上去只差一点”,实际就是跑不动 |
⑥ 八台组网跑 753B | 八万级 | 英伟达公布的工程测试:NVFP4 量化的完整 GLM-753B 可以跨 8 台运行 | 两篇跟进文的口径一致:"能跑"和"好用"是两回事,并行方式、网络、并发负载都得单独算 |
注意这张表的排序逻辑:容量决定"能不能",带宽决定"快不快",组网决定"折腾不起不起"。买之前把这三列分开看,能躲开八成的营销话术。
三笔账,一笔都不能少
第一笔:内存账。 知乎流传最广的那份配置门槛表(2026 年 8 月还在更新)写得很直白:显存是最核心配置,其他硬件都是配角——9B 量化 8G 能跑但勉强,16G 才舒服,27B 要 24GB 起步,122B 级别"消费级单卡基本别想"。四台 Spark 装不下一个 500GB 模型这件事,就是"总容量≈参数体积"这种直觉最贵的一次打脸:权重之外还有 KV 缓存、上下文、系统占用,512GB 对 500GB 不是"差一点",是差一个不能开工。知乎知乎
第二笔:带宽账。 GX10 视频的评论里有一句话被顶在前面:"200 多 G 的带宽没啥用,27B 模型的 8bit 量化跑 20 token 的速度就得 600+ 的带宽了。“统一内存机型看着内存大,内存带宽恰恰是被点名最多的短板。同一台 DGX Spark 换不同软件栈,速度能差 3 倍——Mac Studio 对 Spark 的那场对比里,作者的原话是"有时(软件差异)比两台机器的硬件差异还大”。所以抄作业先抄推理框架,再抄硬件。哔哩哔哩知乎
第三笔:API 对照价。 本地党的天敌是电费加折旧,对照系是 API。高赞回答里两边都很硬核:有人算过"跑一个满血 DeepSeek-V4-Pro,只需要 34 张 H20,大概 100 万左右,就能完美运行了"。也有人劝退"本地部署没有什么必要在家里买一个二三十万的机子,就为了跑一个 120B 的模型,最后用起来效果还不如随手拉过来的云端"。GX10 评论区那句更朴素:"没业务,暂时还是 API 划算。“本地部署真正立得住的理由只剩四个:隐私、离线、持续 Agent 任务、以及"我就是想折腾”。前两个是真需求,后两个是爱好——把爱好当需求做预算,是最常见的买错方式。知乎知乎哔哩哔哩
顺带一提,Agent 这条最被期待的路现在什么样?有人把 Hermes 挂在 Spark 上做"每日任务",3.15 版本那篇手记的标题就是吐槽现场:“干错了事还不承认,是真忘了还是装糊涂?”——单机本地 Agent 的可用性和发布会之间的距离,还得再走一段。
谁该掏钱,谁先别动
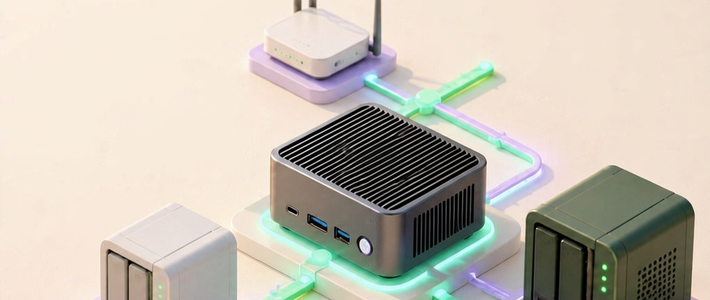
Homelab 老玩家、还没沾 AI 的:一台小主机+两台家庭存储那套"6 分钟看懂"架构完全够用,先别 all in bomb——评论区已经有人替你总结了:"路由归路由,NAS 归 NAS,监控归监控。"AI 盒子加进来也请单独一台,炸了不连坐。
偶尔写文案、查资料的:API,没有悬念。等到你一个月账单能覆盖一台小主机折旧再说。
确定要跑 27B 以上、拿它干活的:按上面的带宽账挑路线,二手甜点卡(3080Ti 三千多、双 5060Ti 对比单 5090 实测"差距并不是非常明显")是性价比最稳的一段。对"能跑 753B"这类新闻,先默认它是工程展示:8 台 DGX Spark 组成集群后可以运行经过 NVFP4 量化的完整 GLM,但能跑和好用是两回事,等第三个实测 UP 主出现再心动。知乎哔哩哔哩知乎
新手、被种草但没想好用途的:GX10 评论区那条高赞建议值得抄进备忘录——“还需要再等个两三年,等这套系统变得更加成熟,等这个设备变得更加的好用一些”。现在下单最大的成本不是溢价,是折腾时间:通电顺序、硬盘自检、启动顺序、ARM 上的软件兼容,每一步都有人踩过。哔哩哔哩
双 11 前,值得盯的四个信号
64GB 版 Spark/GX10 的实价和退货政策:平价小门刚开,"内存减半"换多少差价,是这次双 11 最值得蹲的对照实验;
RTX Spark 笔记本第一波"软件能不能跑顺"的长测,重点看 arm64+Windows 11 生态,而不是参数;
vLLM 对各家统一内存平台的适配进度表——推理栈的更新比硬件降价更早决定体验;
二手 3080 系魔改卡的行情与退换规则,"白嫖 17.5%"的教程热度越高,二手溢价越要提防。
家庭实验室这十年的主线,一直是"用得起、修得了、说得清"。这轮"AI 热"也一样:能跑不算本事,能算清这三笔账、说清它在你家每天干的活,才算把 lab 真正搭进了生活。