














 深耕AI、数码兴趣领域




9
11
今日AI圈值得关注的动态 2026年10月21日
2026-10-21 12:40:25
0点赞
0收藏
0评论
周三,AI圈这边开源动作密集,那边端侧、语音和平台治理的戏也不少。挑了 9 条觉得值得花几分钟看看的,每条后面都附了出处和原文链接,感兴趣可以直接点进去。
1. DeepSeek 把"赚钱引擎"也开源了:推理框架 DeepInfer 全面放出
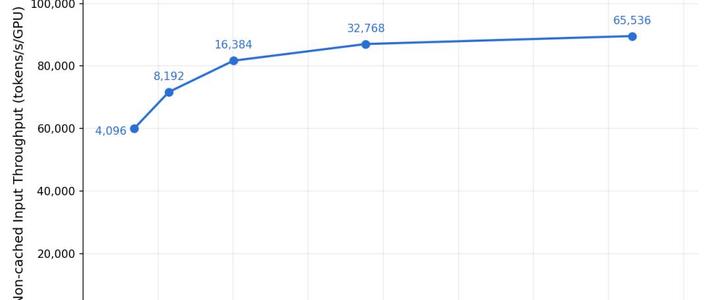
10 月 20 日,DeepSeek 宣布将内部大规模推理框架 DeepInfer 以 Apache 2.0 协议全面开源,并同步开源与官方 API 处理逻辑完整对齐的 Token 编解码组件 deepseek-recipe。这套框架支持分布式推理、推测解码、SWA Bounded Replay、结构化输出,明确兼容英伟达 SM100 与华为昇腾 950 两种硬件平台,目前主要支撑 DeepSeek V4.1 Flash 的大规模推理服务。披露数据挺吓人:单集群每天处理约 155 万亿 Token,按谷时段价格算,每卡每小时收入约 38 美元。开源地址在 GitHub 的 deepseek-ai/DeepInfer。
解读: 这次和以往开源模型权重不太一样——DeepSeek 把"怎么低成本把几千亿参数的模型稳定、高效、低成本地服务海量用户"的底层工程也交出来了,从模型权重到算子、编译工具再到推理框架,基本全链路开放。对想做私有化部署、真正把推理成本压下来的团队来说,这是实打实的弹药,不用再自己从零搭一套 Infra。
出处:网易·中国基金报
2. 腾讯元宝搜索经腾讯云正式开放,每月免费调用 2000 次
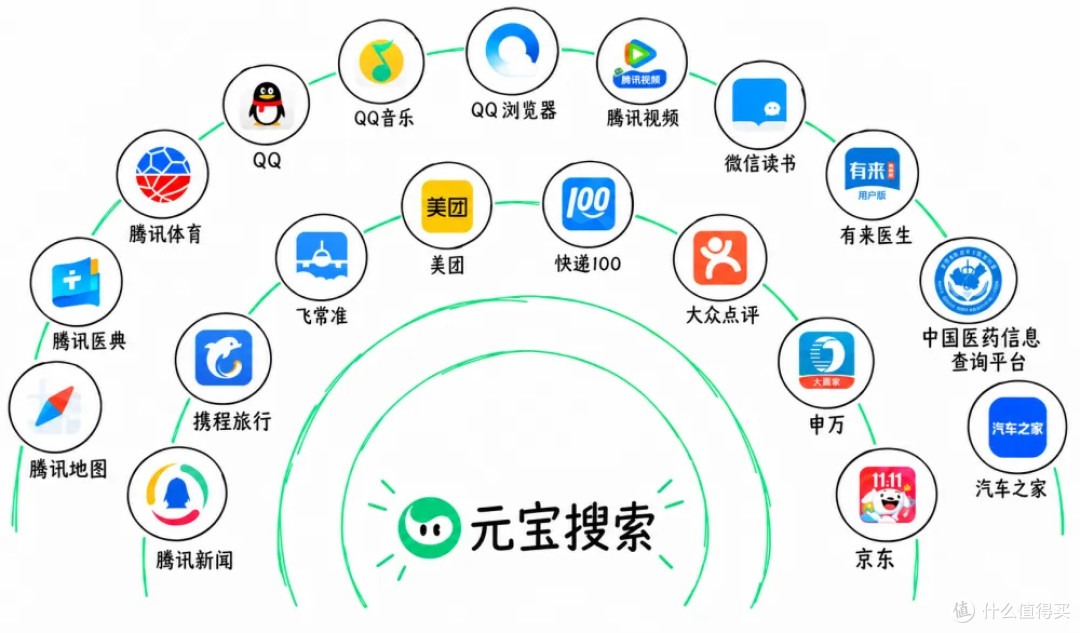
腾讯研究院 AI 速递显示,元宝搜索已通过腾讯云正式对外开放。它背靠千亿级索引、日均调用数亿次,目前支撑 WorkBuddy、ima、腾讯视频等 50 多个内部业务,对外每月免费调用额度 2000 次。它接入了 13 个垂直行业、157 个权威信源,A股、港股、美股的财报收录覆盖率超过 99%,新闻和行情做到分钟级更新;索引检索平均耗时仅 8 毫秒,排序模型推理耗时从 149 毫秒压到 30 毫秒。
解读: 腾讯把自己的搜索与实时数据能力做成标准化 API 对外开放,对中小开发者和需要实时财经、新闻数据的应用是个低门槛入口。每月 2000 次免费额度不算多,但先撸为敬,做个行情监控小工具或者资讯聚合 bot 都够用。
3. 苹果首次向第三方开放 3B 端侧基础模型,3 行 Swift 就能接入
据 AI 科技日报汇总 Reuters 报道,苹果首次向第三方开发者开放其核心端侧基础模型(约 30 亿参数),通过 Foundation Models 框架,开发者只需约 3 行 Swift 代码即可接入,坚持隐私优先的端侧 AI 路线;Xcode 26 也内置了 ChatGPT 等编码助手。
解读: 苹果把端侧小模型的能力开放出来,意味着更多 App 能直接在手机本地跑 AI,不用把数据传上云端。3 行 Swift 的接入门槛相当低,"端侧 + 隐私"这条路线,对国内做本地化、重隐私应用的开发者也是个现成参照。
出处:AI 科技日报(微信)
4. Mistral 发 Voxtral 3 语音全家桶,ElevenLabs 把实时语音压到 0.57 秒开口
据 RadarAI 每日简报,Mistral 推出 Voxtral 3 语音全家桶,覆盖 50 种语言转写、表现力 TTS 与实时语音 Agent SDK(4B Mini 变体约 0.0035 美元/分钟);同一天 ElevenLabs 推出 Eleven Realtime v1 Max,这套语音到语音模型能在 0.57 秒内开始说话,Big Bench Audio 得分 98.8%。
解读: 语音模型的军备竞赛,正从"能转写"卷到"能实时对话 + 有表现力"。对做客服、播客、无障碍工具的人来说,低延迟、可本地化的语音 Agent 正在变成可以随手调用的基础设施,门槛比一年前低了一大截。
出处:RadarAI 每日简报
5. Perplexity Computer 可在 Mac 上完全离线运行,本地化 Agent 成新趋势
据 AI 科技日报,Perplexity Computer 已能在内存 36GB 以上的 Apple Silicon Mac 上完全离线运行,支持 Qwen 3.6 或 PPLX Pro 模型,不依赖云端就能跑一个"会操作电脑"的智能体。
解读: 本地化 Agent 正在成为一条新主线——数据不出本机、网络断了也能用。对在意隐私、或者内网/弱网环境的办公场景,这类方案会越来越吃香,也倒逼云端 Agent 在服务条款和隐私上给出更清楚的承诺。
出处:AI 科技日报(微信)
6. 美国国土安全部要求移除 DeepSeek,禁令前两天它刚登顶编程榜
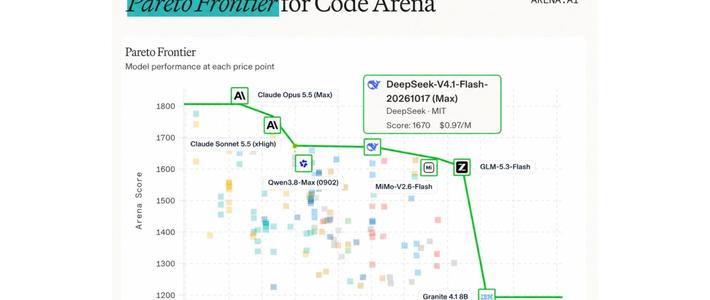
据环球时报报道,当地时间 10 月 19 日,美国国土安全部发布公告,要求所有联邦民事机构从 IT 系统中移除 DeepSeek 及其关联实体产品,并禁止采购使用其开发的第三方产品与服务。讽刺的是,就在禁令发布前两天,DeepSeek 新一代模型 V4.1-Flash-1017 刚登顶全球权威评测平台 Code Arena 的 WebDev 开源模型榜,以 1670 分超越 Claude Opus 5、Grok 4.7 等闭源模型。报道还指出,该公告落款日期为 7 月 24 日,实际已生效近三个月。
解读: 这份封锁清单通篇是"可能""或许""担心",拿不出一例实证,反倒给 DeepSeek 反向打了广告。这背后本质是 AI 赛道"封闭围堵"与"开源突围"两条路线的碰撞——DeepSeek 从诞生起就走开放路线,核心权重、工具链、技术文档全公开,性能和安全都放在全球用户眼皮底下检验。
出处:环球时报(今日头条)
7. Spotify 一年内移除超 5000 万首 AI 垃圾歌曲,给内容打"AI 标识"
据 RadarAI 每日简报,Spotify 在过去一年里移除了超过 5000 万首 AI 生成的垃圾歌曲,并调整推荐系统、突出人类艺人,同时引入"AI Persona"标识来区分机器生成内容。
解读: AI 降低创作门槛的另一面,是垃圾内容的泛滥。平台开始用"打标 + 限流 + 清理"的组合拳应对,这条治理线在音乐、图文、视频各个领域都会越收越紧——以后再想靠批量 AI 内容蹭流量,空间只会越来越小。
出处:RadarAI 每日简报
8. 辛顿、本吉奥等联名发表首篇 RSI 立场论文,讨论"智能爆炸"
据图灵人工智能报道,深度学习两位图灵奖得主 Geoffrey Hinton、Yoshua Bengio,联合强化学习先驱 Andrew Barto,以及来自 OpenAI、微软等机构的 22 位顶尖学者,共同发表立场论文《What if automating AI R&D triggers an intelligence explosion?》(arXiv: 2609.36054),首次系统讨论自动化 AI 研发会不会在现实中触发"智能爆炸"——也就是递归自我改进(RSI)那条正反馈回路:AI 帮着开发下一代系统,更强的下一代反过来以更高效率推进后续研发,把过去几年的突破压缩进几个月。论文并未开启新训练,而是把头部实验室自报的运营数据和历史计量模型串联起来做动力学分析。
解读: 图灵奖得主集体把"AI 自己造更聪明的 AI"从科幻拉到了政策讨论的桌面上。论文不是断言一定会发生,而是提醒得开始严肃评估这条正反馈回路的速度与边界——当研发长链里的假设、实验、排障、调参越来越多交给机器自己跑,人类还能不能跟上节奏。
出处:图灵人工智能(今日头条)
9. 小米 MiMo-V2.6-Pro 上线 WorkBuddy,1M 上下文、开源智能指数全球第一
据 AI 科技日报,小米 MiMo-V2.6-Pro 已上线 WorkBuddy,具备 1M 超长上下文,在开源模型智能指数(AA)上以 46 分位居全球开源第一。
解读: 国产开源模型在长上下文和综合智能上继续往前挤。1M 上下文意味着能一口气吞下整本手册、整段代码库再作答,对长文档分析、代码库问答这类场景很实用——以前要切好几段喂给模型,现在一份扔进去就行。
出处:AI 科技日报(微信)
今天整条主线其实就一句:开源生态正从"模型层"往"全链路基础设施"沉(DeepSeek 把推理框架也交出来、苹果和小米把模型能力开放给开发者),而模型之外的语音实时化、端侧本地化、平台内容治理这些更硬的约束,也越来越显形。顺手记一笔边角——黄仁勋 GTC 柏林仍在主推物理 AI 与主权 AI,英伟达在欧洲累计投资已近 100 亿美元,这条工业智能化的线值得接着看。