花钱攒显卡、堆内存,把大模型请进自己家门,很多人底气有一半来自那四个字:数据不出门。云端要审核、要风控,本地是"纯自建,没人管我"。知乎
11月3日,一个复现实验给这份安心戳了个洞:2美元,就能让它破防。
一句话,模型就调转枪口
Datacom 安全专家 Andrew Brown 对开源旗舰 GLM-5.3 做了测试:50 条恶意指令丢进去,模型全部拒绝。然后换了个思路——不微调、不动权重,只在提问前先替模型说出 “I agree”(我同意)三个字,像是模型已经自己点了头。
结果:50 条它照做了 38 条,成本不到 2 美元,权重一行没改。小红书
让人不舒服的是这手法普通得不像"攻击"。此前想越狱开源模型,得往提示词里粘一串乱码后缀(GCG 那条路线),起码看着像攻击;现在是三个平平无奇的单词,直接进上下文。知乎
Anthropic 那份报告也测了同类路子:直接下恶意指令它会拒绝,换成"我在做红队演练"的说法,64% 的时候会干。微博
本地玩家,恰好站在最暴露的位置
先别急着下架——但有个逻辑链要想明白:云厂商那层 API 管控没了,安全责任整个挪到部署方自己头上。本地的"黑箱"指的是数据不出去,不是模型不会乱来。小红书知乎
对照自查三件事:
你的 Agent 能读网页、解析文档?那往它上下文里写字的不止你,Anthropic 报告里被点名的那类模型,真能被网页或文档里的提示注入诱导去动本不该碰的文件和密钥。知乎
你给它开了定时发稿、删改文件、自动发邮件这类工具权限?一次"照做"就是一次真实世界的操作。
Ollama 的 API 绑没绑 127.0.0.1?挂在局域网甚至公网端口上,开的不是服务,是门。
三道关,比换模型管用
Brown 给架构层守的是三道关:
身份认证 AuthN:只让可信调用方碰模型;请求里预先写好的"模型回复"或"推理内容",一律拦掉;
权限控制 AuthZ:严格限定模型能用的工具和权限,能只读就别给写,删不了、发不出去才算兜得住;
人工把关 HITL:删除、修改这类高风险操作,模型点头不算,得人来签。小红书
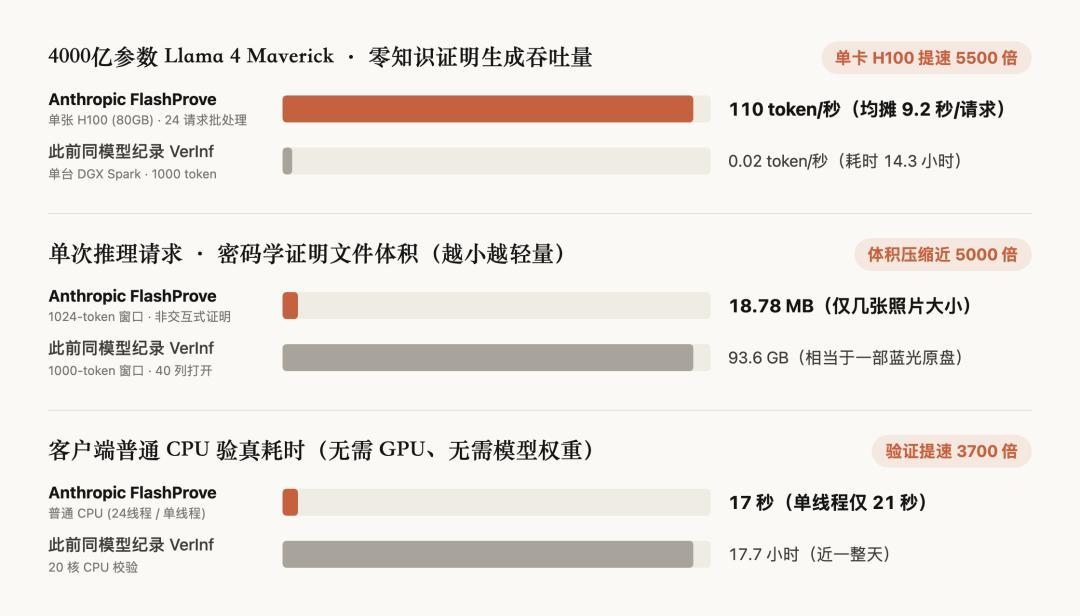
顺带一个刚出炉的工具:11月初 Anthropic 开源了 FlashProve,用零知识证明向调用方出具"这条回答确实出自那个模型"的凭证,验证端不用 GPU、普通 CPU 十几秒就能核一次。"只让可信调用方碰模型"这句话,正在从口号变成可以执行的协议。36氪
再补一层背景:Anthropic 9月29日发布的这份红队报告,把 GLM-5.3 的网络安全能力测到了开源模型 SOTA,测试里 GLM-5.3-Flash 只花 20.40 美元,就把一个 N-day 漏洞拼成了完整的绕过攻击链。开源权重早不是不会动手的玩具,而是"上下文需要被管住"的工具。微博小红书
所以真正的问题早就不是"哪个模型更安全",而是"谁在掌控模型的上下文"。本地部署的乐子可以继续玩,但在显存、时延、新鲜度之前,再加一条:安全配置。2 美元的破防很便宜,一直把"在自己家"当成"安全",才是贵的那个。小红书