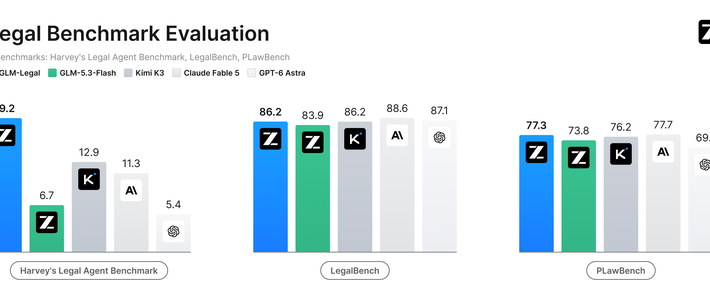
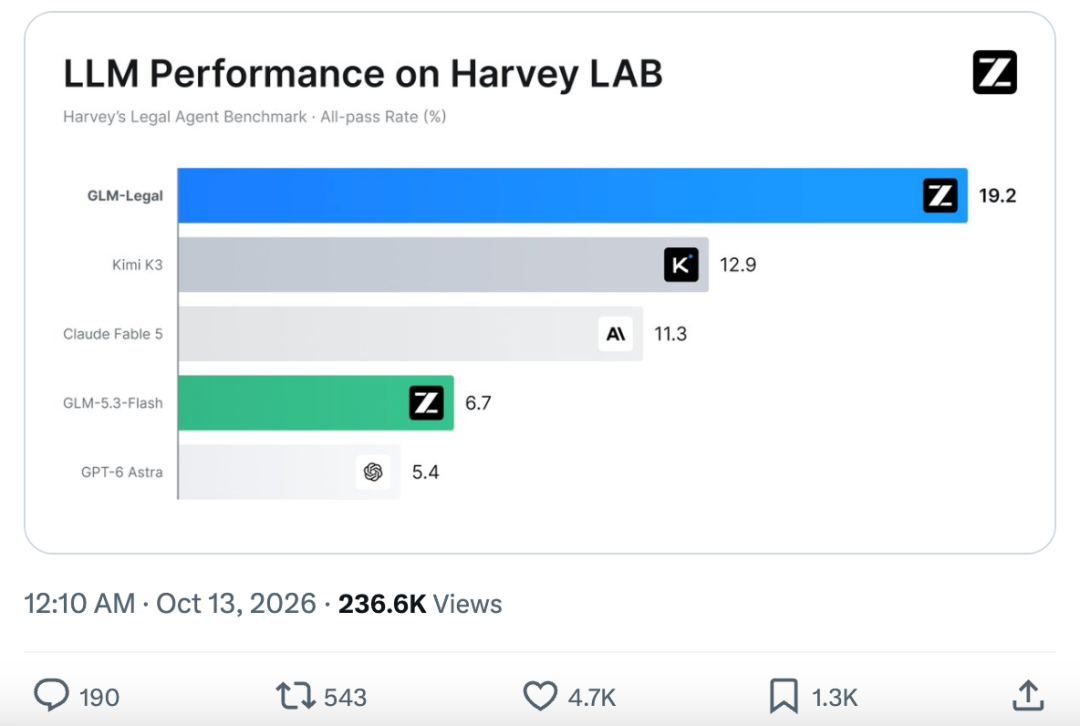
GLM-Legal 发布时,两个数字被反复引用:LegalBench 准确率 86.23%,HarveyLAB 全通过率 19.2%。知乎微博知乎
一个接近满分,一个不到两成。它们不是同一张卷子,也没在量同一件事。
先看 19.2%。HarveyLAB 首版有 1200 多道模拟任务,覆盖 24 个法律业务领域,评分用“全条件通过”:一份任务里的所有检查项必须全部满足,漏一条就算零分。知乎
交付物格式错了,零分。少引一个案号,零分。时间点写错,零分。
LegalBench 考的是合同、并购文件、司法意见书的解析,86.23% 说明它读得懂、答得对。19.2% 说明它把一整件事做完、做到能直接交,只有不到两成。知乎
这条从读材料到交成果的链,恰恰是法律工作的日常。
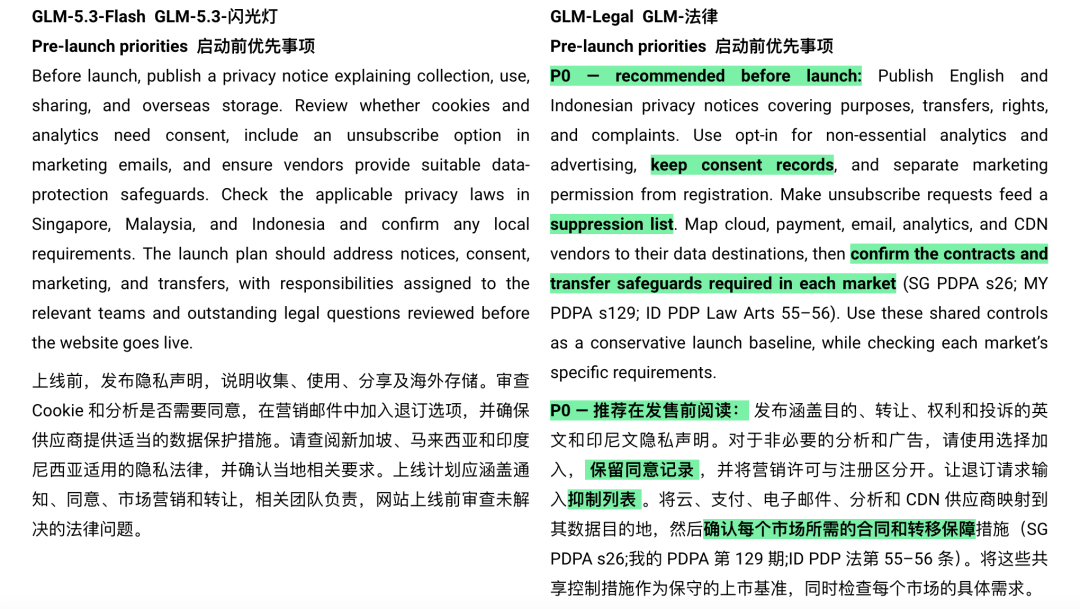
智谱给出的对比很具体。客户要换软件供应商,审合同里的终止和交接条款。底座 GLM-5.3-Flash 的建议是“可以考虑缩短通知期、要求返还数据”。知乎
GLM-Legal 把通知期从 60 天压到 30 天,要求交回全部成果,包括还没做完、还没付款的部分,再加最长 90 天过渡支持。每条都对应回合同现有条款。知乎
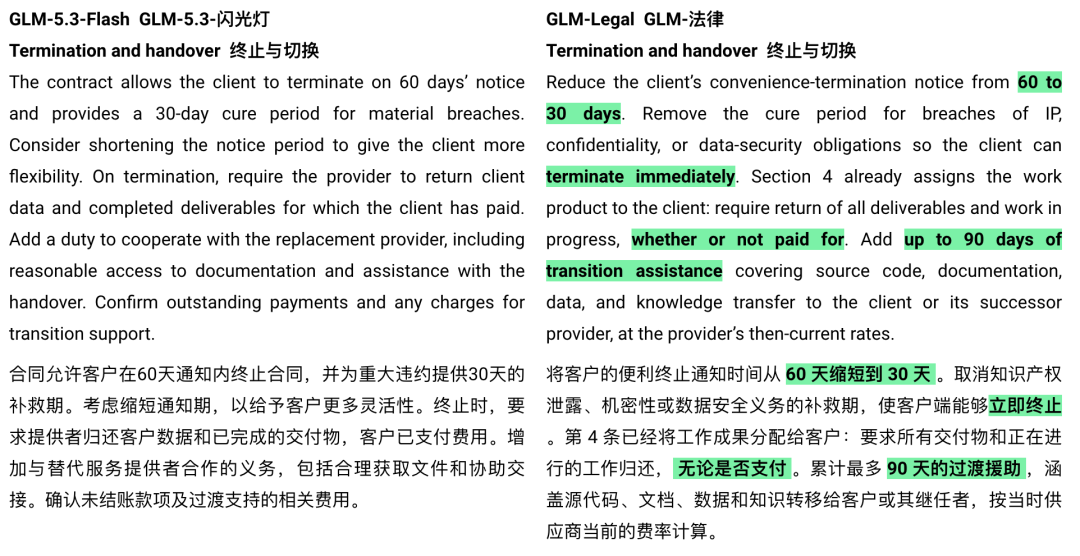
另一个任务是 40 份项目材料。对外报告写完成 60%,内部记录是 41%。底座模型也能发现这个矛盾,然后建议进一步审查。知乎
GLM-Legal 把 9 月 30 日的报告、9 月 8 日“里程碑无法达成”的警告、管理层要求压住风险继续开票的邮件串成一条线,标上文件编号,再提醒先核对原件。知乎
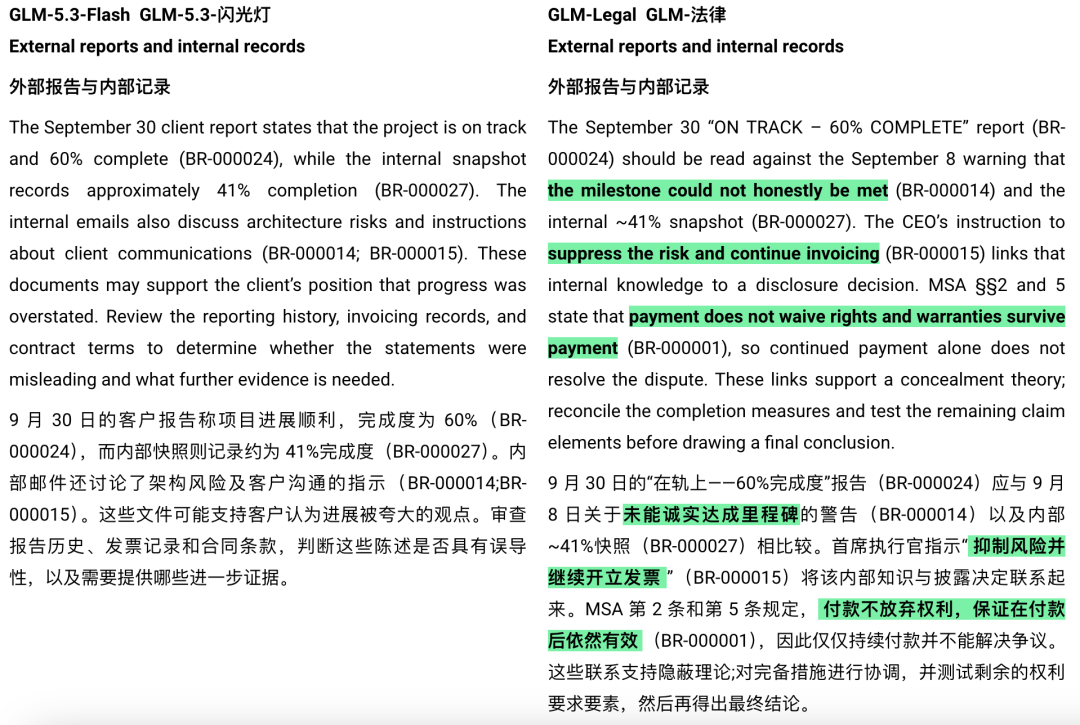
三组官方演示里还有一个跨境合规任务:网站要在新加坡、马来西亚、印尼上线,它把义务拆成带优先级的清单,附上三国具体法条。知乎
发现矛盾是整理信息。把矛盾连成一条可主张的论证路径,才是律师的活。
这也是“垂直模型”真正的意思:不是多背几本法条,是把一个岗位的交付标准写进训练里。
代价和成绩都摆出来了。Vals AI 的独立评测给 19.17%,单任务成本 0.15 美元。10 月 12 日榜单上排第七,前十名里最便宜。知乎
成绩相近的 Gemini 4 Argon 每项测试成本约是它的 70 倍,但快近半小时。知乎
发布后,一位法律从业者从 GitHub 找了四道题做独立测试。GLM-Legal、GLM-5.3、Kimi K3 的账单分别是 5 元、50 元、218 元,质量的差距没有价格那么大。小红书
另一位拿模拟卷宗跑了一遍,说它在证据分析和管辖问题上与 Claude 不相上下。小红书
但 19.2% 的另一面是 80.8%。在最严的口径下,大多数任务它仍然没有全部达标。智谱自己的定位是协作助手,不是替代律师。知乎
法条引用、证据编号、合规清单,每一项都可能出错。签字负责的还是人。
现在这版法律模型已经进了 AutoClaw,能调用北大法宝、天眼查等六个法律数据库,Word 插件里可以直接改合同、查法条。小红书
Beta 阶段的价格、能否私有化、数据放在哪,官方还没完全说清,这几项比跑分更该先问。
智谱做法律模型不是第一次。2023 年它和幂律智能做过 PowerLawGLM。知乎
今年 8 月,Harvey 也用 Kimi K3 后训练出了 Tenet。通用底座加行业任务,正在成为一条固定路线。知乎
对不碰法律的人,GLM-Legal 也提供了一个看模型的尺子:单项通过率再高,也不等于能把活交出去。真正值得盯的,是那个更低的数字。