本地AI圈这两个月最大的一次热闹:2026 年 11 月 12 日,开源项目 Edge0 正式发布了 Edge0-145B 和 Edge0-120B,并把模型权重和推理框架一起开源。让人上头的还不只是快,是代码、图纸、客户资料这些东西,真的可以不进云端了。知乎小红书
官方 GitHub 的测速确实挑衅:RTX 4090(24G 显存)跑 Q3_K 版,对话解码约 70 token/秒,智能体解码约 92。但热闹归热闹,这篇只给你通稿里看不到的数字。三处口径,先拆开:小红书
内存口径:宣传里的"峰值内存 29GB"只算活跃内存,海外博主实测 54GiB——话术,不是会消失的内存。知乎
能力口径:“Terminal-Bench 碾压 Claude Opus 4.6"这份基准是官方自测口径。开源第 3 天,真人实测寥寥几篇,中文圈全是新闻通稿,无一篇真机部署。评论区已经有人反问"明明是旗鼓相当”。不支持视觉,中文质量基本没人验过。哔哩哔哩
硬件口径:145B 档在 Linux 和 Windows 上需要 NVIDIA GPU(CUDA 13),Mac 限 Apple 芯片,A 卡和核显用户这次没你的座。小红书
再看真正把它装上机的人,三天里趟出来的坑:
一、98GB 权重,千万别放 NAS。 Edge0-145B 的权重是三层结构:约 40GB 专家库放内存,51GB 词表放本地 NVMe。同一份文件,本机盘冷读 18.3 秒,放 NAS 要 15.6 分钟,差 51 倍。瓶颈不是硬盘,是那条千兆网线:实测两路就顶到 112MB/s,加线程、换 NAS 都没用——官方赌的是专家命中率,不是你的带宽。知乎
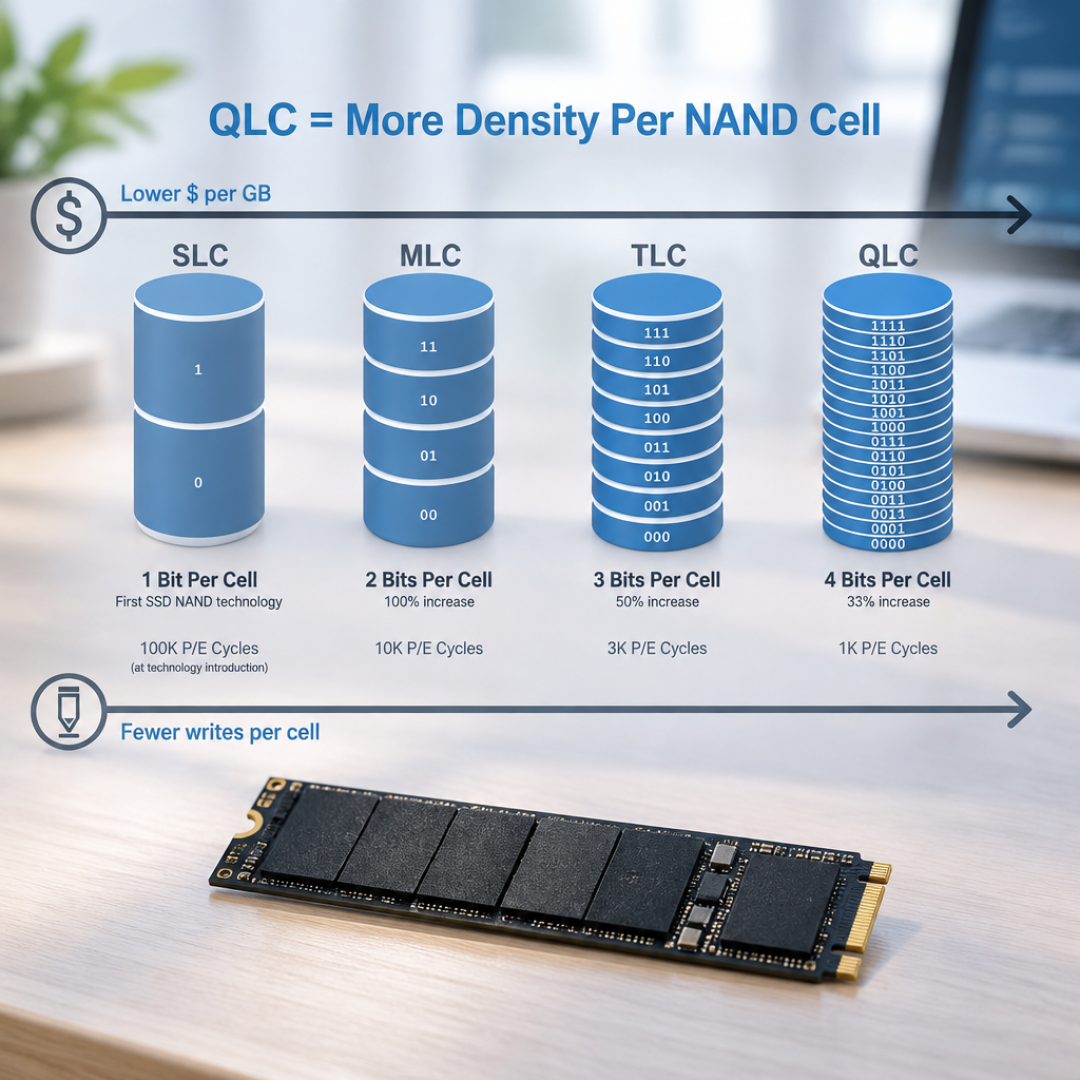
二、下载源之间差 225 倍。 HuggingFace 直连超时,别死信镜像:有人实测同一文件同一天,hf-mirror 只跑出 94KB/s,modelscope 单流 21.2MB/s、8 路并行 44.44MB/s。98GB 请预留 40 分钟。顺手排个雷:直觉上 NVFP4 该更省,实际仓库反而比 q3k 大 7GB——q3k 才是三层结构最紧凑的那版。知乎
三、跑不了 145B 的,35B 档只能聊天,别指望它干活。 一台千元级二手迷你主机(16GB 单通道内存、无独显)实测:热缓存后首字 1.3 秒、解码 4.27 tokens/s,日常聊天够用。但当编程 Agent?系统提示词约 11000 tokens,预填充只有 11.5 tok/s,敲一个问题白等 16 分钟才见第一个字——数学上不可行。三年前这套配置得进机房,今天塞在一个鞋盒里。知乎
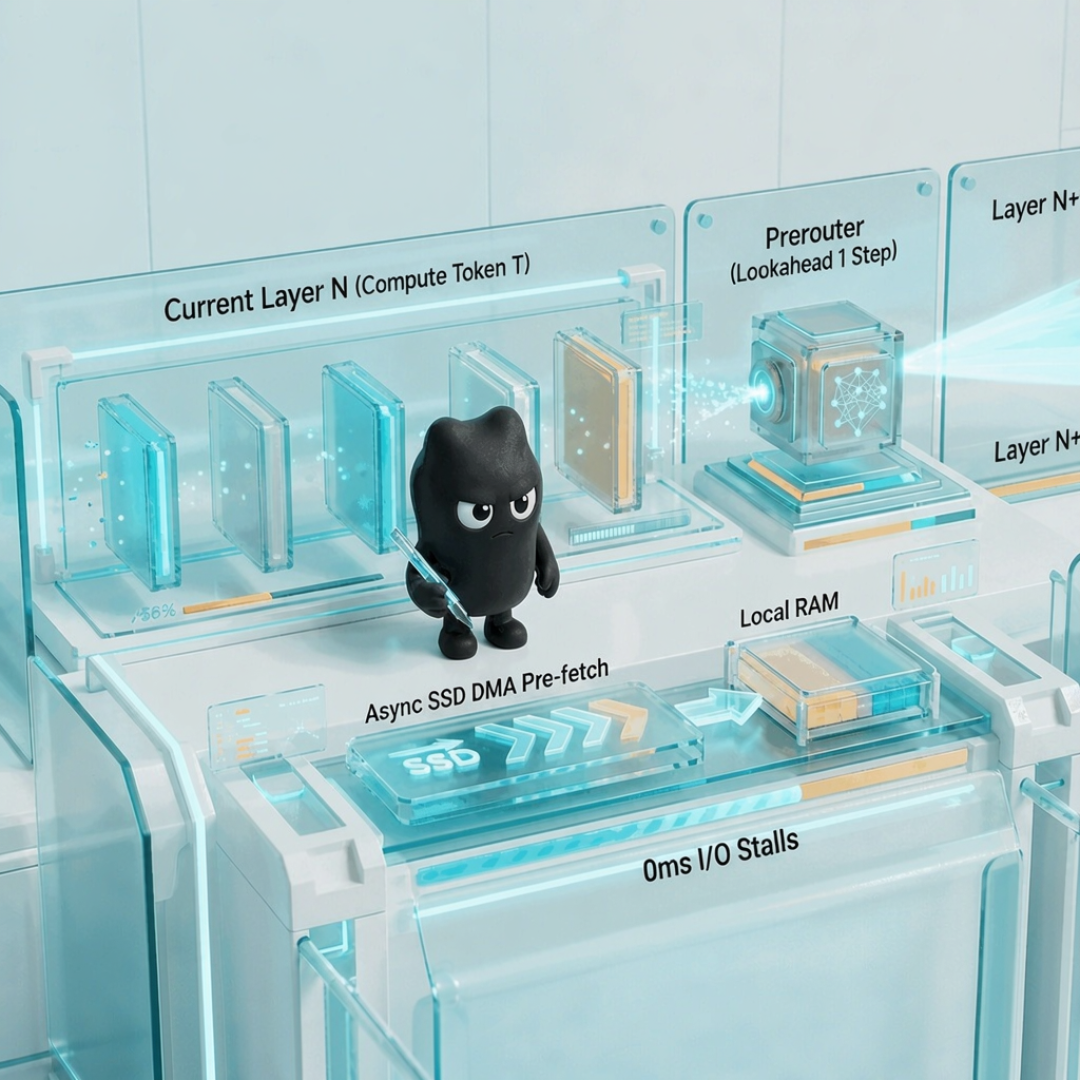
原理一句话:Edge0 把全部 MoE 专家权重留在 SSD,每次只加载路由选中的那几个,再用 Prerouter 提前预取下一步的专家来藏磁盘延迟,官方报告解码速度最高提升 59%、是项目方测试的最大值。它没把内存变多,是把"大内存常驻"改写成了"存储和调度协同"。知乎
想冲的话,门票账提前算好:N 卡 RTX 20 系起步,官方实测过的最低预算档是 16G 显存 + 20G 内存、44.9 tok/s 起步。再配一块一千出头的 2TB 企业级 NVMe,比把千兆升到 2.5G 便宜一半。提醒一句,以上速度和内存数字全是个人机器实测,官方路由和命中率参数没公开,你的里程必然不同。知乎知乎
只有一条对所有机器成立:那 98GB,别放 NAS。