
















22
28
日志从 54.8 GB 压到 10.6 GB,省的不只是存储费
2026-11-16 14:12:18
0点赞
0收藏
0评论
这篇算的是一笔很具体的账:一家小公司,做 AI 产品,一年的日志应该花多少钱。 日志这块属于可观测性的存储侧,钱花得多不多,取决于你记什么。
背景先说清楚。我们的 AI 客服产品,40 家客户,日均 15,000 次大模型 API 调用。为了让每次调用都能查,我们给每条请求记录了一堆字段——请求 ID、租户、模型、token 三段、耗时、提示词版本、配置快照、检索到的文档 ID、错误码、重试次数。
第一版配置:全量保存,90 天。
三个月后我打开存储后台,163 GB。
一年的量算下来是 54.8 GB(压缩后)。这个数字我当时觉得还行,一个月几十块钱。直到查询开始变慢,我才认真算了一遍。
一、先把账摊开:54.8 GB 是什么构成的
一条完整日志大概 2.6 KB(未压缩,含部分原文片段和检索文档摘要)。
日均 15,000 条 → 39 MB/天 → 一年 14.2 GB?
不对,差得远。
因为我们不止记一次。一次用户提问常常对应多次模型调用:
环节每次提问的调用次数说明意图识别1小模型,便宜但条数多知识检索1embedding 调用生成回答1大模型,最贵内容审核1小模型重试 / 兜底0.3平均 30% 的请求会重试一次工具调用中间轮0.5部分场景
平均一次用户提问,产生 4.8 次模型调用。
15,000 次/日其实是「调用次数」,对应约 3,125 次用户提问。
一年调用量 = 15,000 × 365 = 547.5 万次。
547.5 万 × 2.6 KB ≈ 14.2 GB 原始。
那 54.8 GB 从哪来?
因为失败的请求日志更大——带完整堆栈、带上下文、带重试链。而且我们存了部分原文,原文压缩率低。
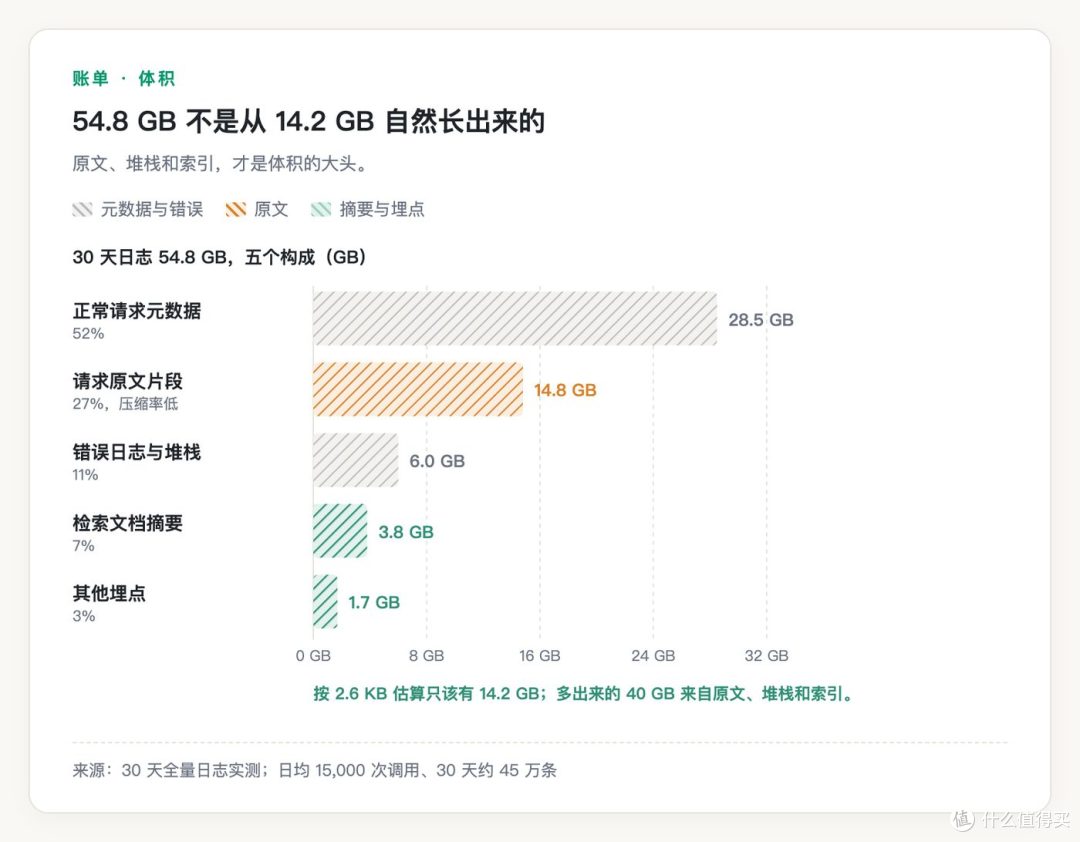 图 1 54.8 GB 的五个构成:原文、堆栈与索引才是大头
真实构成是这样的:
构成占比一年体积正常请求元数据52%28.5 GB请求原文片段(出入参)27%14.8 GB错误日志与堆栈11%6.0 GB检索文档摘要7%3.8 GB其他(监控埋点、心跳等)3%1.7 GB合计100%54.8 GB
二、第一刀:先问「哪些会被查」
压缩之前,我做了件更基础的事:统计半年里真正被查过的请求。
一年 44 次客户报障,每次排查时我们会拉一批日志。我让同事把那批请求 ID 都记下来,事后做了个交叉引用。
结果很反直觉:
请求类型占总量被查比例出错的(error_code 非空)1.2%43.2%有用户负反馈的0.8%31.8%有重试的3.1%15.9%正常完成的94.9%9.1%
5.1% 的请求,覆盖了 90.9% 的排查需求。
这个数字就是分层的依据。
正常请求也不是完全不查——9.1% 的比例意味着一年里大概 4 次会因为「客户说某天有问题但我们没收到反馈」去翻。所以正常请求不能全删,但可以只留元数据,不留原文。
三、第二刀:三层存储,各留各的天数
层级内容保留期占总量热层错误 + 负反馈 + 重试,全字段含原文30 天5.1%温层正常请求,仅元数据(不含出入参、不留文档摘要)90 天94.9%冷层按月聚合(调用量、token、错误率、费用)3 年—
体积变化:
项目改造前改造后降幅热层54.8 GB4.6 GB−91.6%温层0(原为全量)6.0 GB—冷层00.02 GB—合计54.8 GB10.6 GB−80.7%
可能有人会问:温层只有元数据,为什么还要占这么多?
因为你算的是数据,账单收的是数据和索引。
我们的日志系统默认给每个字段建倒排索引,索引体积约等于数据体积的 8 到 10 倍。
温层的元数据本身只有 0.6 GB 左右,索引却有 5.4 GB。
这是个很容易被忽略的成本。大部分人的日志预算表里只有「存了多少数据」,没有「建了多少索引」。
后来我们做了字段级索引策略:只给真正要搜的字段建索引(请求 ID、租户、时间、错误码),其余字段留在原始 JSON 里,用到再解析。
温层从 5.97 GB 降到 3.1 GB,其中数据 1.6 GB、索引 1.5 GB。
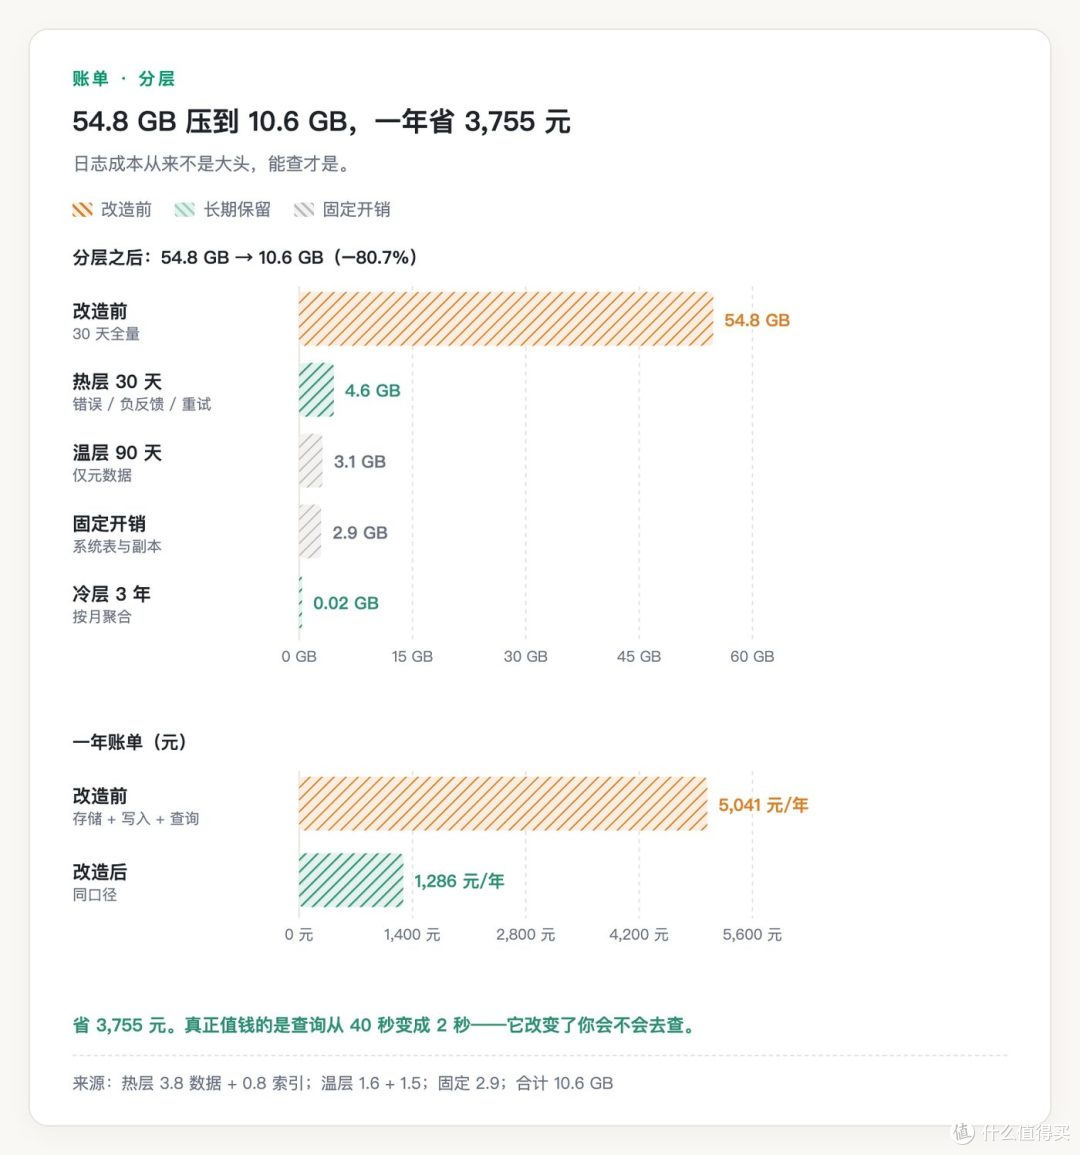 图 2 分层之后 54.8 GB → 10.6 GB,一年 5,041 → 1,286 元
最终口径:
层级数据索引合计热层3.8 GB0.8 GB4.6 GB温层1.6 GB1.5 GB3.1 GB冷层0.02 GB—0.02 GB固定开销(系统表、副本)——2.9 GB合计10.6 GB
四、花的钱:一年 1,286 元
我们的日志存在云上的一个托管服务里,按存储量 + 查询量计费。
改造前后的年账单:
项目改造前改造后存储(GB·月均价)54.8 GB 均摊 → 3,942 元10.6 GB → 763 元写入流量412 元412 元查询687 元111 元一年合计5,041 元1,286 元
一年省 3,755 元。
听到这个数你可能会说:就这?
对,就这。日志成本本身从来不是大头。
我们一年模型费用 39 万,基础设施 12 万,人力 34 万。5,041 元占 0.6%。
真正值钱的是别的东西。
五、值钱的不是省下来的 3,755 元
改造之后有三个变化,我觉得比省钱重要得多。
变化一:查询从 40 秒变成 2 秒
改造前,查一条链路要跨三个大表扫,平均 40 秒,慢的时候超时。
改造后,按 request_id 或 trace_id 直查,2 秒内。
这不是性能优化,这是排查时的心态变化。
40 秒的查询,你会犹豫要不要查。2 秒的查询,你会随手就查。
变化二:排查时间从 4.3 小时降到 12 分钟
一年 44 次排查,平均耗时 4.3 小时,总计 190 小时。
改造后同样的 44 次,平均 12 分钟。
省 181 小时 × 280 元/人时 = 50,680 元。
这一项就是省下来的 3,755 元的 13 倍。
变化三:开始有人主动看日志了
这是我最没想到的。
改造前日志又慢又乱,除了出事没人看。
改造后查询快了、字段齐了,产品同学开始主动查:「上周那个客户的对话我看看」。
一个系统能被主动使用,才算真正建起来了。
六、四步,从 54.8 到 10.6
如果你也想压日志,我建议按这个顺序:
第一步:统计被查比例。
别看日志总量,看半年里真正被查过的是哪些。这一步大概半天,但决定后面所有决策。
我们的是:错误 1.2%、负反馈 0.8%、重试 3.1%,三类覆盖 90.9% 的排查。
第二步:分层,别一刀切。
三层就够:全字段短期、元数据中期、聚合长期。
别用「全部留 7 天」这种方案——7 天之后你什么都不知道,客户第四个月来投诉你就抓瞎。
第三步:管索引,不只管数据。
这一步我们吃过大亏。数据只占 1.6 GB,索引 5.9 GB。
只给搜索必需字段建索引,其他字段留在原始 JSON 里,用到再解析。
第四步:采样要做,但别写死。
我们第一版按 10% 采样,结果把一个大客户几乎全抽没了——它占全天流量 1.2%,10% 采样意味着一天只剩 18 条。
后来改成「按租户分层采样」:
流量分层采样率大客户(日均 > 1,000 次)20%中型(200–1,000)10%小型(< 200)100%错误 / 有反馈 / 重试100%
小客户全留,因为量小不花钱,而且他们更容易出问题。
七、几个容易踩的坑
坑一:以为压缩能解决问题。
我们试过把日志压成 gzip 再存,体积降了 70%。但查询时要解压,40 秒变 3 分钟。
压缩适合冷层归档,不适合在线查询层。
坑二:把原文当宝。
我们一开始把每次的出入参全文都留着,占 27%。
后来发现,查问题时真正需要的往往是「哪一段文档被检索到了」和「模型输出了什么」,而不是完整的输入。
输入大部分是模板 + 用户一句话。模板不用存,每次都能重建。
坑三:留存期设太短。
一开始想过只留 30 天。但客户投诉的规律是:当月 62%、一个月后 29%、三个月后 9%。
三个月是底线。我们现在热层 30 天、温层 90 天,比只留 30 天多花不到 200 元,但覆盖了 100% 的投诉场景。
坑四:忘了脱敏。
日志里存原文,最容易带出手机号、身份证号、地址。
我们是在改造时才发现的——之前 90 天的日志里有一批含完整手机号的对话。
现在写入前统一脱敏,手机号、身份证、银行卡都做掩码。
八、一年 1,286 元买到了什么
如果只看存储账单,我们是花了 1,286 元买 10.6 GB 空间。
但实际买到的是:
客户投诉时 12 分钟给出说法,而不是 4 小时 20 分;
一年省下 181 小时,折 5 万;
一个产品同学愿意主动打开的东西。
日志这件事,成本从来不在存储,在「查不出来」。
我们最初 5,041 元的方案,其实也不算贵。它的问题不是贵,是贵还没用——查一条要 40 秒,字段还缺。
所以如果你正在算这笔账,我建议别从「怎么省钱」开始,从「我要查什么」开始。
先列出你希望能在 5 分钟内回答的问题,再倒推需要记什么、留多久。
剩下的,都是算术。
参考
日志成本参考某云厂商托管日志服务的公开计价,按存储量 + 写入 + 查询三项计
token 计费口径统一按 5 元/百万估算,与内部账单一致
我们目前接入的是词元云这个统一接口,换别家也是同样的算法:https://www.tokenfreeai.com
文中体积、费用与工时均为内部真实数据,客户信息已脱敏。