这周开源圈有个事挺有意思。Arm 的工程师 Lorenzo Stoakes——长期参与 Linux 内核开发的老手——嫌内核编译太慢,拉了个大模型来帮忙。结果 AI 还真没让他失望:藏在庞大构建流程里的性能瓶颈被一个个揪了出来,构建、测试、调试、分析也全包了。但轮到 AI 动手写修复代码时,Stoakes 在补丁说明里写下了一个相当直接的词:hideous,惨不忍睹。36氪
换很多人,故事到这就该变成又一篇"AI 不行"的檄文了。但结局是反的:Stoakes 把 AI 写的烂代码大段重写、把提交信息和注释全部改过、亲手验证内核能正常构建运行之后,合入了 23 个补丁——全模块构建最高提速 36%,增量构建最高快了约 70%,部分 noop 构建快了约 90%,而且在他之外的不同硬件和内核配置下都能复现。
一边骂"惨不忍睹",一边收下 90% 的提速。这个拧巴的组合,恰好是当下 AI 工具使用现状最真实的切片:AI 好不好用,已经不取决于模型多强,而取决于你把哪几步交给它、哪几步攥在自己手里。
55 万浏览的抱怨帖:累是真的,而且不是个例
如果你觉得"我用 AI 之后反而更累了"是自己能力不行,可以先看看社区里的讨论热度。知乎上,"为什么用 AI 写代码之后,人反而越来越累了?"这个回答拿了 937 赞、1216 收藏,浏览量 55 万+;"为什么感觉 AI Coding 剥夺了我写代码的乐趣?"848 赞、22 万+浏览;还有"AI 编程这么厉害,为什么不下班前提交需求给 AI,第二天回来 Review 代码?"992 赞、29 万+浏览,评论区唱衰党、乐观党吵成一团。这些发帖的不是没接触过 AI 的观望者,而是天天在用的人。
微博上也有同样鲜活的样本。一条"Codex 太猛了"的帖子拿了一千七百多赞,博主感叹 AI"1 分钟干人类 1 天的活,虽说 bug 不少,但效率碾压"。配图里的 X 原帖更直观:一个预估"15 人日"的重构,15 分钟后成品就被推上了 GitHub。微博
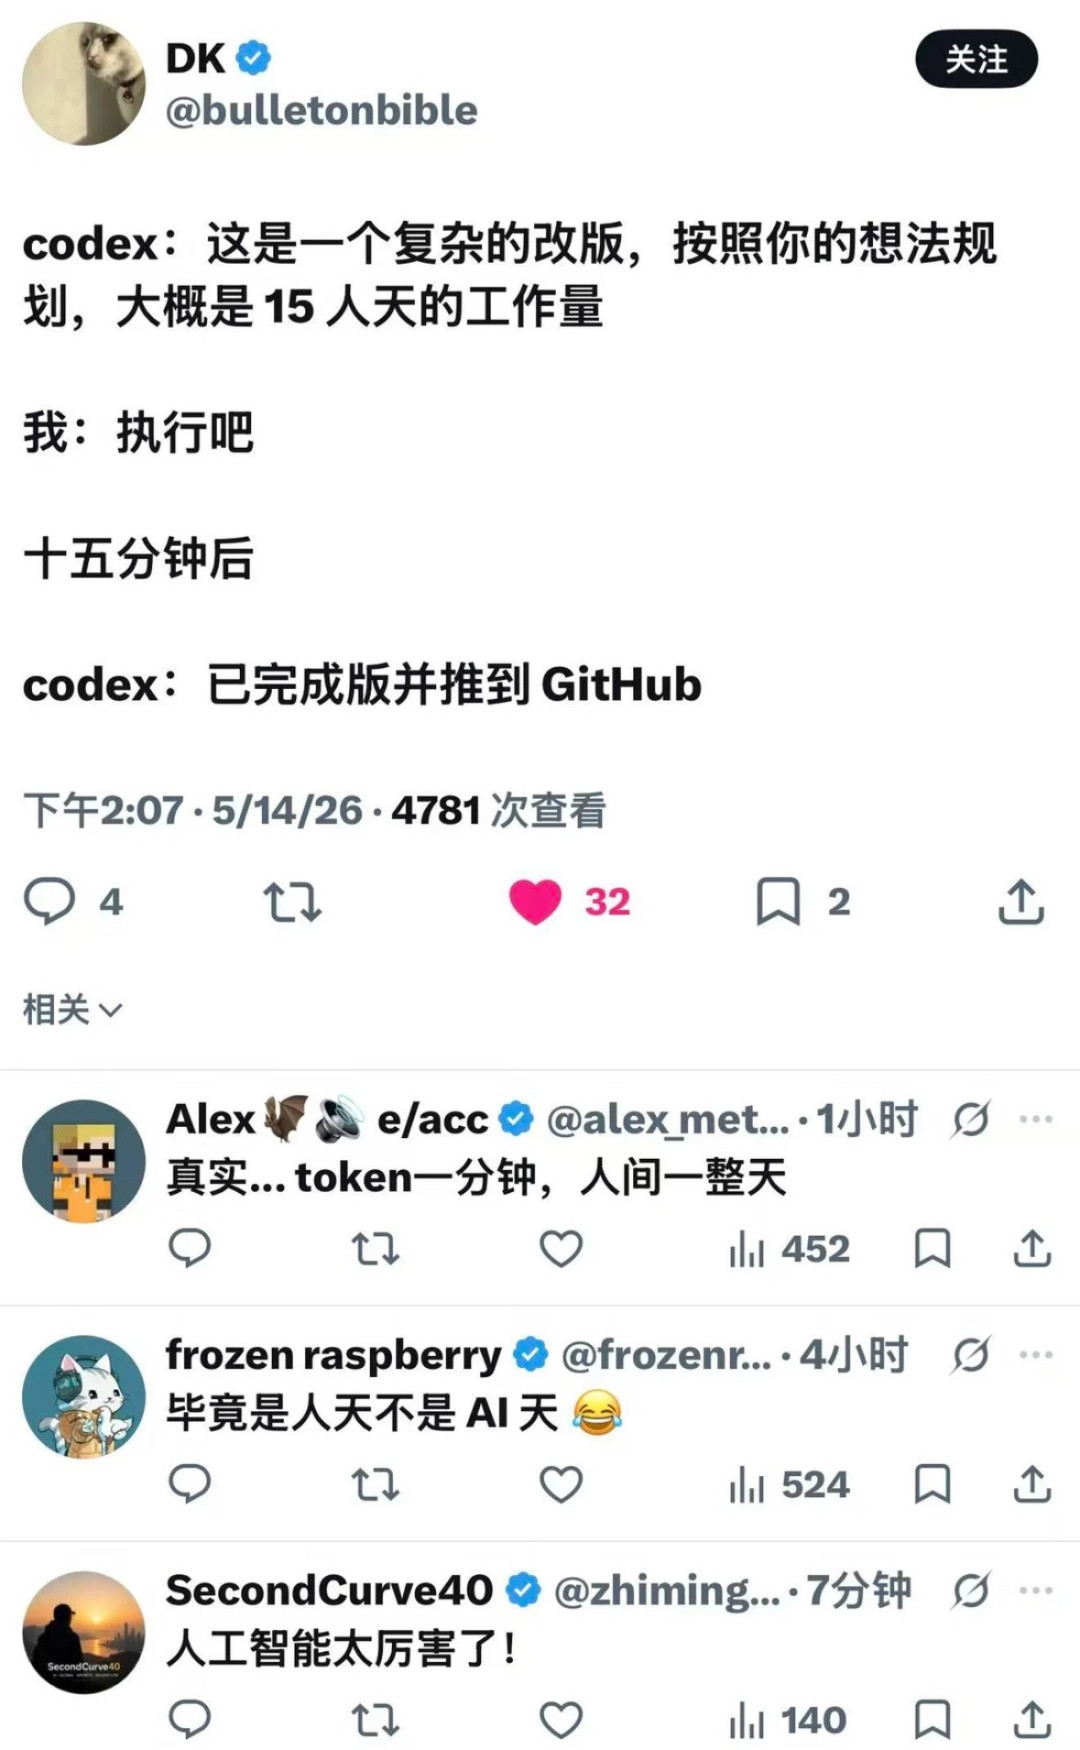
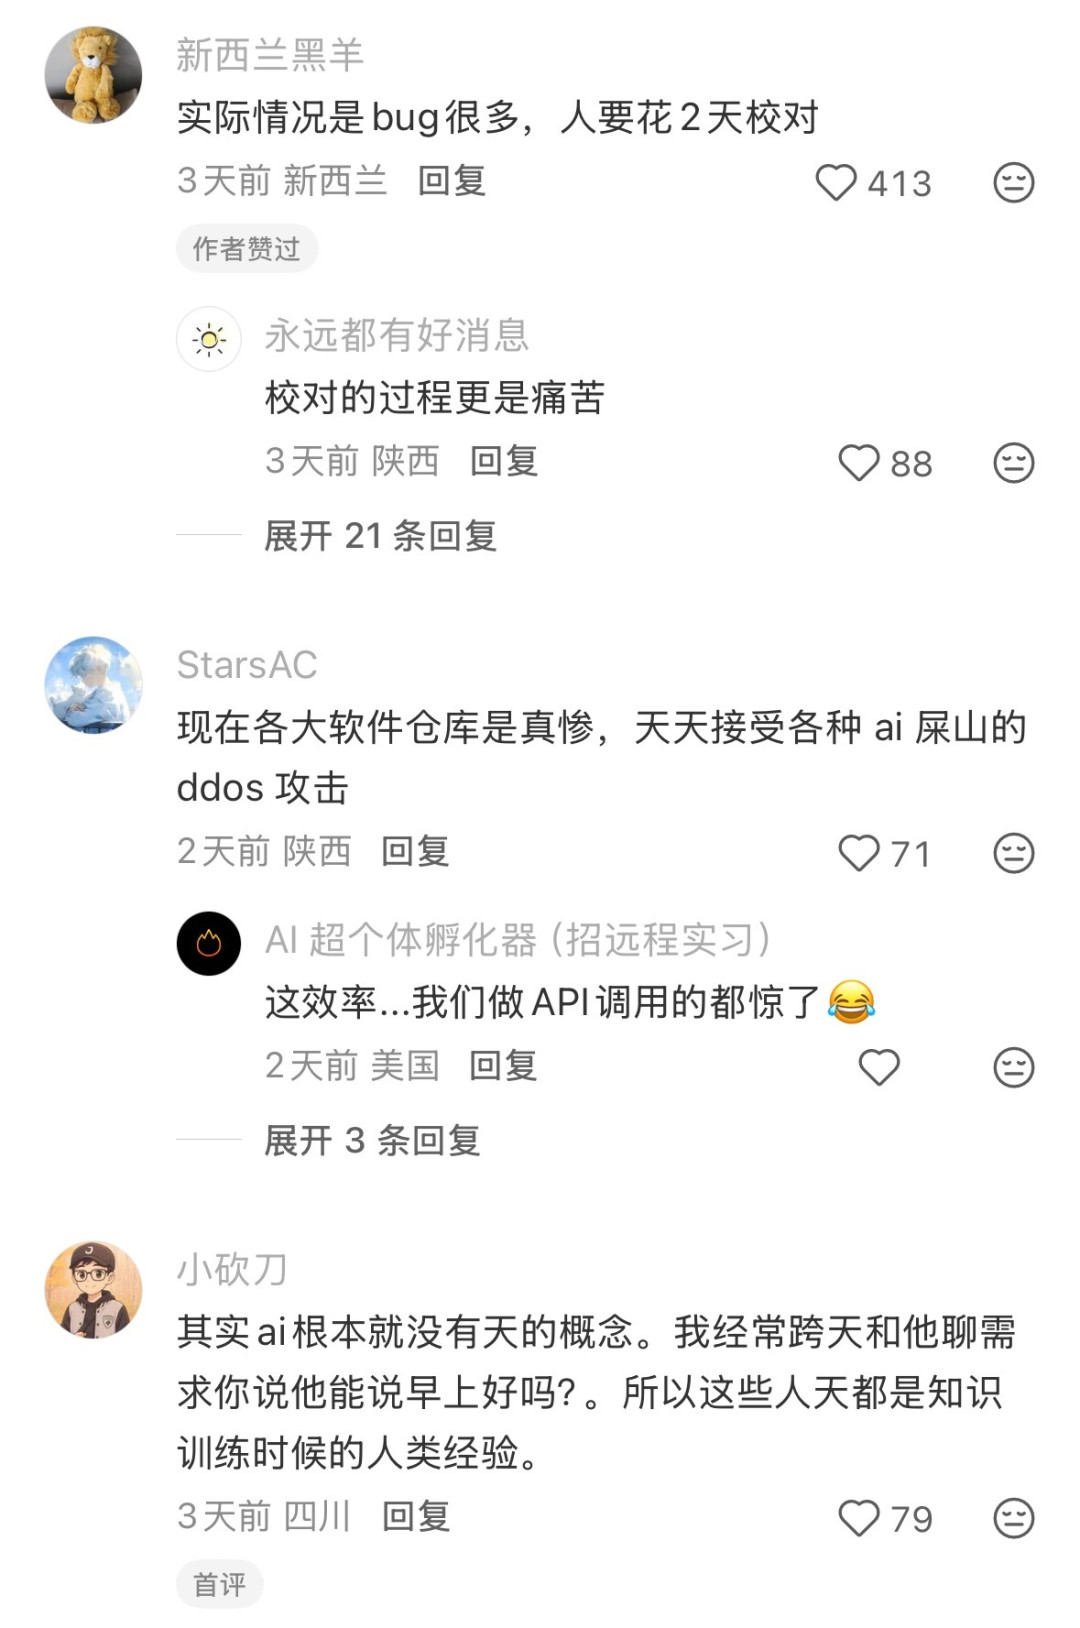
但点赞最高的一条泼了盆冷水——“实际 bug 很多,人要校对 2 天”,413 个赞,博主自己都在楼里补了一句:“校对的过程更是痛苦。”
这种累甚至传染到了 AI 圈顶层。吴恩达在一条被转疯了的视频里说,用 AI Coding 干一整天,“整个人脑子都快累瘫了”,但转念又承认,“说到底它还是工程”。周鸿祎更直接,自曝同时开 3 个 AI 写代码,结果"AI 编程 5 分钟,自己检查代码要看 1 小时"。他还半服气地补了句:AI 聪明起来的时候,是他合作过水平最高的程序员。微博微博
离 AI 最近的人都在喊累。那这个累,到底是从哪来的?
那篇 55 万浏览的回答给出了一个很锋利的解释框架。它借用了美国空军上校 John Boyd 的 OODA 循环——观察(Observe)、定向(Orient)、决策(Decide)、行动(Act)。传统干活方式里,这四步是一个秒级翻转的闭环:写几行、跑一下、看报错、查资料、改代码,每转一圈你对系统的理解就加深一层。真正费脑子的是 Orient(搞清状况),而搞清状况的过程本身就是建立掌控感的过程。
AI 进来之后发生了什么?读代码、看报错、定位根因、写代码、跑通编译——Observe、Orient、Act 三步 AI 全包了,而且跑得比你快。你被留在原地,只剩一个 Decide:在它递过来的方案上点"通过"或"拒绝"。
用那个回答里的话说,这叫"AI 在你的循环里跑得比你快"——它三步秒级走完,把一个决策塞到你面前时,你还没把上一段的根因想清楚。于是你永远在反应、永远慢半拍、永远基于不完整的理解拍板。那种"累"、“跟不上”、“心里没底”,不是矫情,是你的决策循环被从内部超车了。知乎
越自动,越累人:这个悖论 43 年前就被写下来了
更有意思的是,这种疲惫一点都不新鲜。1983 年,人因工程学者 Lisanne Bainbridge 发表了著名的《自动化的反讽》(Ironies of Automation):系统越自动化,剩下给人做的那点活反而越难、越累——因为人被踢出了执行回路,情境感知慢慢丢光,却还要为偶发的高风险时刻兜底。对照着用 AI 的日常,三个后遗症几乎一一对应:知乎
第一,决策频率上去了,质量下来了。以前一个决策管两百行代码,前面有十分钟读代码铺垫,后面有半小时动手验证。现在决策变成高频碎片:“这个变量名行吗”“这个异常类型对吗”——每个都孤立、没铺垫,数量翻十倍、深度只剩十分之一,责任却一分没减。这就是审批疲劳。
第二,责任和控制对不上。出了 Bug 问责的是你不是 AI,可风格是 AI 定的、算法是 AI 按概率选的、新引入的依赖你在 diff 里才第一次见到。责任全压肩上,控制权不在手里,"心里没底"就来源于此。
第三,直觉在退化。那些让你踏实的本能——“这递归迟早栈溢出”“这命名跟业务对不上”——不是读书读出来的,是一行行敲、一次次排查喂出来的。以前每写一段都在加固它,现在只在 diff 上盖章,直觉没有新东西可养。结果就是那个很扎心的状态:代码能跑,但你说不清它为什么对、哪天会崩。知道,但不懂。知乎
知乎上还有个 155 万浏览的回答提供了注脚:有人接手同事 vibe coding 出来的一千七百多行代码,重构完不到 200 行,还顺手追加了功能——因为 AI 写了一堆根本不需要的重复校验。看得懂的人一刀下去能砍掉 88% 的冗余;看不懂的人,只能对着这座屎山继续让 AI 往上糊。知乎
连《代码整洁之道》的作者 Uncle Bob 都在 X 上承认,他现在的策略是不再阅读他的 agent 们写的任何代码。但注意他的做法:不是不看就合,而是把逐行审查换成了单元测试、验收测试、变异测试、覆盖率这一整套硬约束。微博
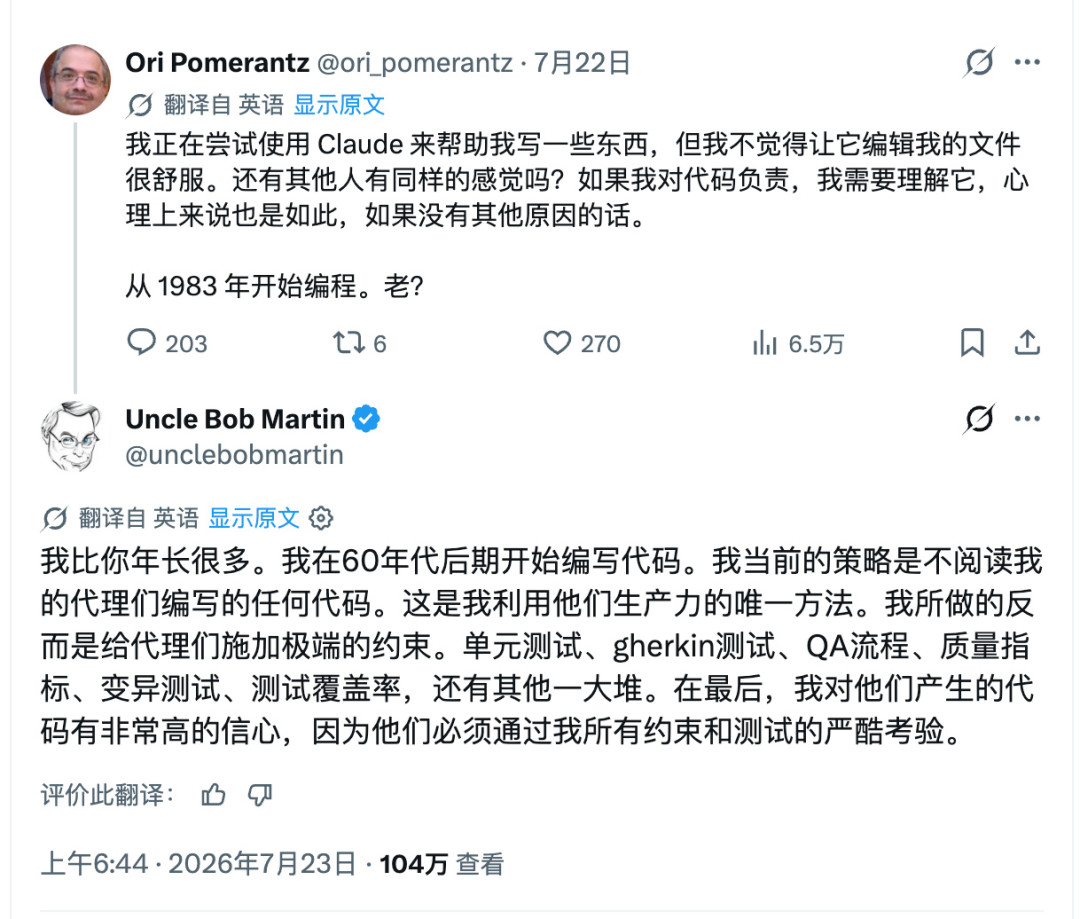
连"整洁代码"布道者都换了把关方式,背后是同一笔账:当 AI 的产出速度超过人的阅读速度,"人肉逐行看"这条路就走不通了,只能用规则替代肉眼。
不只你累,组织层面的账更诚实
如果说个体感受还只是个案,组织级的数据能告诉你这件事有多普遍。工程数据平台 Faros AI 在 2026 年发布了一份基于两年遥测、覆盖 2.2 万名开发者、4000 多个团队的报告,结论相当扎眼:
产出侧确实涨了:人均 epic 完成量涨 66.2%,任务吞吐涨 33.7%,PR 合并率涨 16.2%;
但每周真正部署上线的次数反而降了 11.7%——合并得更多,发出去的更少,中间全堵在审查环节;
代价落在人身上:人均背的 bug 数涨 54%,每个 PR 对应的线上事故涨 242.7%,PR 平均体积涨 51.3%;
最扎眼的是等待:等一个人来审的中位时长涨了 441.5%,还多出 31% 的 PR,一次审查都没经过就直接合了进去。36氪
Anthropic 自己的数据也指向同一处:过去一年公司人均代码产出增长了 200%,代码审查随之成了瓶颈。他们内部上线 AI 审查系统之前,只有 16% 的 PR 能拿到实质性审查意见;上线之后这个数字升到 54%,超过 1000 行的大 PR 有 84% 能被查出问题、平均 7.5 个,工程师标记"找错了"的不到 1%。而成本是:审一个 PR 平均跑 20 分钟、烧掉 15 到 25 美元的 token。
一句话总结:写代码变便宜了,审代码变贵了。工程师的身价也跟着换了算法——以前看写得多快,现在看审得多快。36氪
内核大佬的正确示范:AI 找,人改,人验证
回到开头的 Stoakes。他的 23 个补丁之所以能成,关键不在 AI 多强,而在分工切得干净:
交给 AI 的:分析构建流程、翻查海量代码找瓶颈、提出候选方案、跑构建、跑测试、调试、汇总分析结果——全是"大海捞针"式的检索和重复劳动;
攥在自己手里的:判断哪些思路靠谱、重写烂代码、大改提交信息和注释、以及最后一道验证——他亲自检查生成的内核能不能正确构建、能不能正常运行、提速是不是真的存在。补丁里还老老实实打上了 Assisted-by 标签,声明 AI 参与。
连 Linus Torvalds 本人也上演过类似剧情。之前他排查 Intel Xe 显卡驱动的一个 Bug,AI 反复声称问题"不可能解决",建议直接写报告了事。Linus 没放弃,继续指挥 AI 加调试代码、分析结果——24 个调试补丁、18 次内核重启之后,答案出来了:一个本该写成 round_down() 的函数被错写成了 round_up()。修改量:一行。Linus 事后的评价很公道,“在这场漫长的排查中,AI 几乎承担了大量繁琐工作……虽然 AI 好几次准备放弃,但该给的功劳还是要给”。同时他也点破了要害:AI 干苦力活是一把好手,但需要有足够经验和韧劲的人类去引导。36氪
Claude Code 的作者 Boris Cherny 则把这套分工做成了一个极端实验:把自家 App 的日常维护整个丢给 Claude,开个 Slack 频道让它每天自己上班——几星期下来 388 个 PR、180 个被合并,“工程师需要做的,只剩下一个决定是否合并的按钮”。但仔细看它接走的活:崩溃巡检、重复抽象合并、死代码清理(拿不准的先埋一天日志观察,确认没人走再删)……十一项全是"能当场验证对错"的长尾杂务,没有一项是"做个新东西"。他的调优方式也值得抄:某类 PR 老是不合格,不去逐个修 PR,而是回头修生成它们的规则——不修结果,修规则。
把三个案例叠在一起,规律就出来了:AI 提效提在"找"和"重复",不在"判断"。找瓶颈、找根因、翻资料、跑测试、批量清理,这些是 AI 的主场;方案取舍、代码重写、最终验证,这些是人的主场。
这个分界线现在连开源社区都写进官方规则了。Rust 项目今年 8 月给 AI 贡献立了规矩:AI 生成的代码要事先打招呼、不能碰关键路径、测试要充分、必须如实披露用了大模型;涉及 soundness(正确性根基)的关键改动,强烈不建议交给大模型生成;维护者甚至没有义务审查 AI 提交的 PR,可以直接关掉。对代码质量极端谨慎的社区,划线方式和内核大佬的实践完全重合:AI 可以参与,但关键判断和最终责任必须留在人手里。36氪
不写代码的人,同一套分工照样成立
这套逻辑不止属于程序员。把"代码"替换成"文档、报表、方案",分工表几乎原样成立:
放心交给 AI 的:跨资料检索和汇总、报错和异常数据的定位、初稿生成、格式转换、批量重复处理、会议纪要和素材整理。
必须攥在手里的:方案选哪条路(改不改、做不做、先做哪个)、边界和取舍(哪些数据不能碰、哪个结论说过头了)、以及最终验证——发出的稿子、提交的报表、上线的东西,自己从头到尾过一遍,出了事自己签字负责。
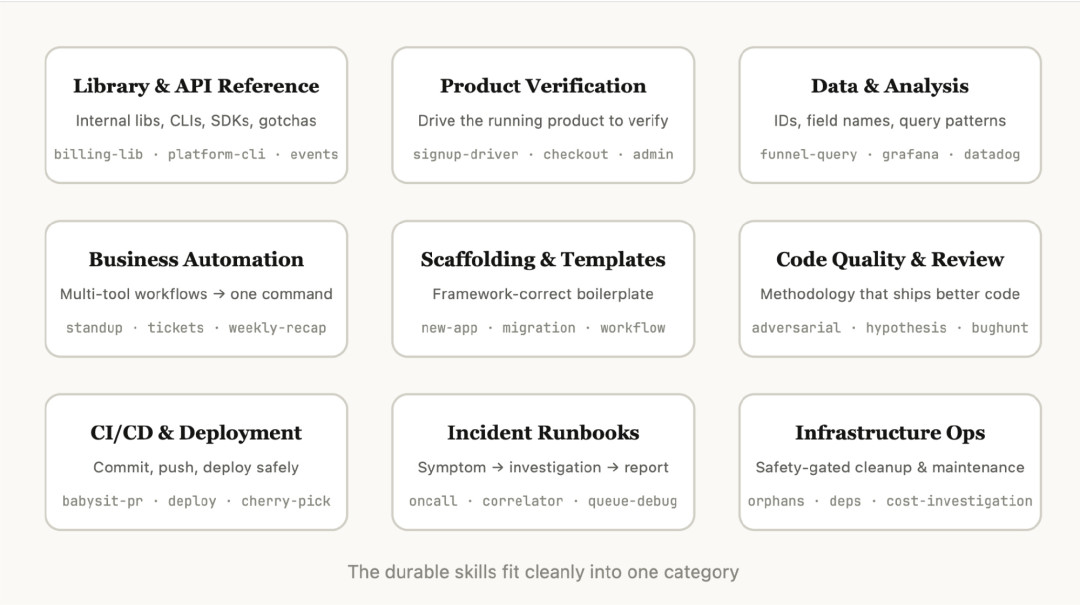
行业头部公司已经在把这套分工工程化。Anthropic 最近有门被微博科技博主转疯了的课,叫《The AI-Native SDLC Playbook》,讲的就是:人负责目标、判断和治理,AI Agent 负责大量执行,从 Plan 到 Maintain 全流程如此。他们的官方博客还把 AI 编程里的重复工作沉淀成了九类"技能":库与 API 参考、产品验证、数据分析、业务自动化、脚手架模板、代码质量审查、CI/CD 部署、事故手册、基础设施运维——九类清一色是"有明确规则的活",没有一类叫"判断方向"。微博
Claude Code 团队自己的做法更进一步。据微博上流传的一份内部分享,他们的代码审查已经不再靠人逐个看:先让多个 agent 并行去找潜在 bug,再用对抗式评审多角度过滤误报,最后只把真正值得人看的东西送到人类 reviewer 面前——因为 fan-out 产生的信息量对人来说太大,必须先压缩再呈递。Claude 给自己提 PR 时还会自己跑测试、附上截图作为验收证据,人看到的是证据链,不是裸代码。微博
微博上还有条被转发不少的实操帖,发帖人把自己的 AI 工具箱拆成了明确的分层:复杂规划用一家、写代码用另一家的便宜档、日常搜索用第三家、简单杂事丢给免费工具。你会发现重度玩家的共同点不是"找到了一个全能 AI",而是按任务分工、每家只干自己最擅长的活——本质上还是同一个思路:让 AI 包掉观察和执行的苦力,把定向和决策留在人脑里。
三个具体调整,把"被拖着跑"变回"驾驶"
结合知乎高赞回答和这些一线实践,给你三个马上能落地的调整:
1. 先要方案,再要结果。别一上来就让 AI"直接做完"。让它先输出思路和方案,你判断、修改、拍板之后,再让它动手。多花两分钟,换回的是 Orient 环节的参与感——你不是在审批一个黑盒结果,而是在驾驶一个执行者。知乎那篇讲"乐趣被剥夺"的讨论里,848 赞的实操派说得直白:闭着眼让 AI 写,它绝对给你一大坨;但你把以前的代码丢给它当参考、把要写什么和用什么方案说清楚,它就是你手指的延伸。知乎
2. 把验收条件写进规则,而不是靠现场把关。Boris 的"不修结果,修规则"和 Uncle Bob 的测试约束是同一招:与其每次都在 diff 里替 AI 补脑洞,不如把"什么算做对"提前写成 AI 能读的要求——旧代码给它当参考、边界条件写清楚、验证方式定好。想清楚了,AI 只是高速打字员;想不清楚,你就得在审批环节连本带利还债。
3. 定期亲手干一次脏活。排查一个 Bug、重构一段旧逻辑、从零手搓一份分析——不是为了证明不需要 AI,而是给直觉续粮。你的判断力是这套分工里唯一不可替代的资产,别让它饿着。
什么时候该警惕:三个自查信号
最后给三个"被 AI 拖着跑"的预警信号,中了两条以上,建议主动放慢节奏:
东西能跑、稿子能发,但你说不清它为什么是对的;
打开 diff 或终稿前会犹豫,心里冒出"算了不看了吧"——Faros AI 数据里那 31% 未经审查就合并的 PR,就是从这一念之间开始的;
每天拍板的次数明显变多,但每个决策花的思考时间越来越短。
AI 工具这波竞赛,比的从来不是谁写得快,而是谁找得准、谁审得住——找 Bug、找瓶颈、找资料,这是 AI 的主场,内核大佬已经用 90% 的提速证明了这一点;而审查、取舍、签字,这是你的主场,组织级数据也已经证明了它有多贵。
别当审批员,当决策者。同样是累,前者越累越虚,后者越累越值钱。