这几天刷AI资讯的人,大概率都躲不开一个四字母缩写:Jev。
时间线先摆出来:9月15日,一家叫TypeSafe AI的公司开放了新模型Jev的早期体验,当天在HackerNews拿下1679分,第二天Vercel AI Gateway就宣布接入。 随后Cloudflare、LangChain跟进集成,谷歌Gemma官方账号也发了条"DiffusionGemma as Jev"凑热闹,发布第五天,用例已经冒出几百个。不到36小时,就有多达14万名开发者涌入内测。哔哩哔哩知乎专栏
有意思的是,这波狂欢的主角,是一个不会说话的大模型。它不能聊天、不能写代码、连一个标点符号都不生成。而站在它背后的,是ChatGPT的核心缔造者之一——Diogo Almeida,InstructGPT论文第四作者,OpenAI早期最核心的研发人员之一,RLHF和InstructGPT的核心奠基人。 2024年初他离开OpenAI,隐身两年,端出来的不是更大的GPT,而是一个反着来的东西。知乎专栏
如果你正在用大模型干活、搭工作流、写Agent,这篇帮你把这波热度拆干净:什么是真的,什么是滤镜,以及你这周到底要不要花时间去测它。
一、它到底是个啥:一个"只会做选择题"的模型
Jev给自己起的品类名叫System One Model,出处是卡尼曼的《思考,快与慢》。系统1是快思考——你问1+2等于几,不需要低头沉思三分钟。现在的GPT、Claude、各种Reasoning Model都在卷系统2(慢思考、长推理),而Jev赌的是另一边:这个世界上存在海量根本不需要长篇推理的智能任务,只需要一个判断。
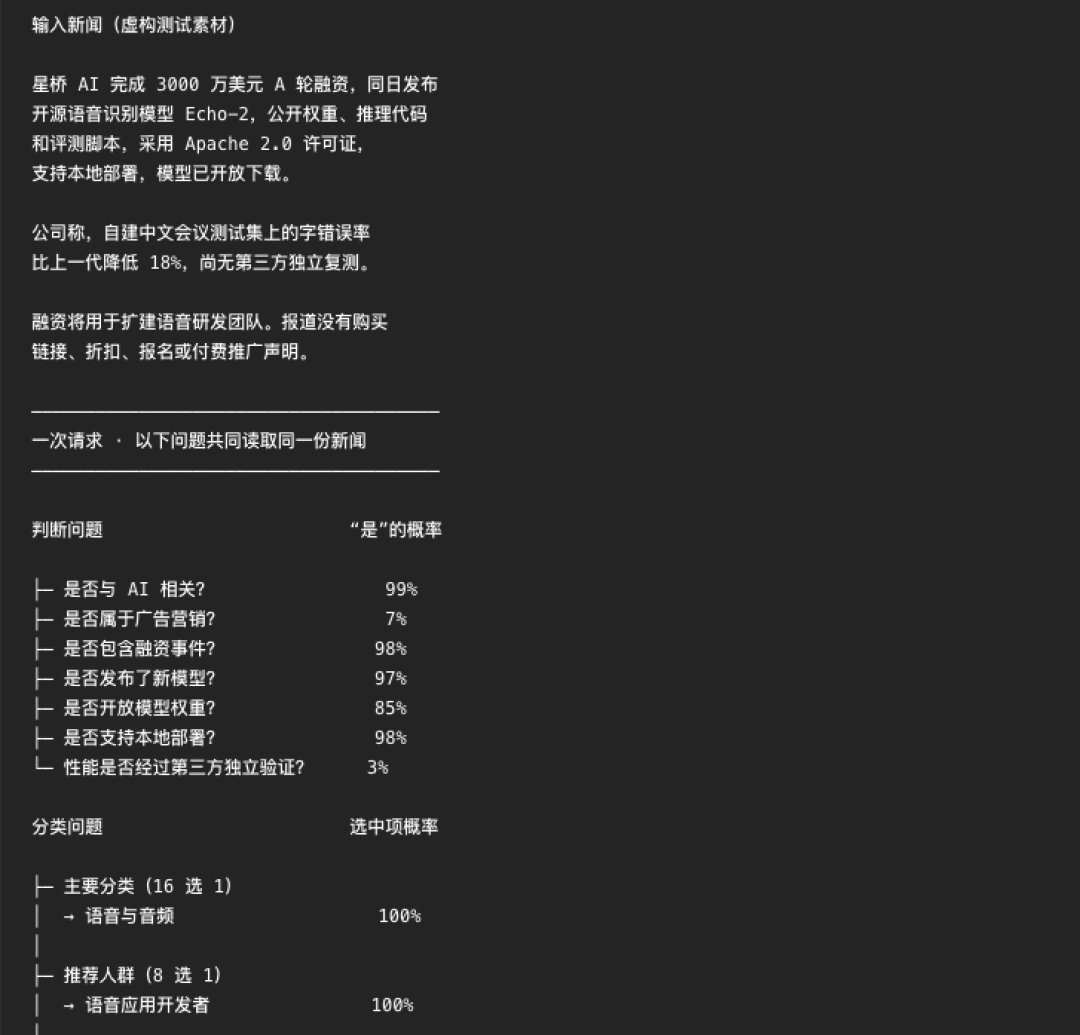
它的用法朴素到离谱。你扔进去一段乱七八糟的非结构化状态——一封炸毛的客诉邮件、一条X帖子、一个程序卡壳的现场——它只做三类输出:Choice(从给定选项里挑一个)、Score(打个分)、Noul(甩回一个0到1之间的概率值)。每个答案都附带所有选项的完整概率分布和整体置信度,全程不生成任何一个字——它根本不向外输出自然语言,不写任何字符串,哪怕是一个单词、一个汉字或一个标点符号。知乎专栏

为什么快?传统大模型是自回归解码,每生成一个token都要把上下文重新跑一遍前向传播,输出300个token就是300次串行循环。Jev因为根本不生成文本,输出字段的候选空间在请求到达时就已经确定,所有目标变量的概率矩阵在单次前向传播里并行算完。做一次判断,Jev端到端只要70到500毫秒,同样的活交给前沿大模型,要3到329秒。 官方口径是快20到200倍,让它打《毁灭战士》,每秒能做10次决策,一小时算力成本只要7美元左右。知乎专栏
为什么便宜?既然没有逐字生成,就没有值得计费的输出。输出Token永久免费,只对输入收费,成本低了40~400倍,0.042美元/百万Token,便宜到离谱。 对比一下:前沿模型的输出定价普遍在每百万Token几十美元这个量级。知乎专栏

这套玩法的训练方法叫RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习)。RLHF奖励的是"人类看了很爽",RLCD想优化的,就是这个决定到底对不对,而且模型嘴里说的"我有90%把握",到底是不是真的接近90%。 这一点对自动化系统是刚需:置信度大于0.90直接自动执行,0.7到0.9之间交给更强的大模型复核,低于0.7转人工。判断的"含水量"第一次变成可计算的成本项。知乎专栏
至于"Jev"这个名字,来自经济学里的「杰文斯悖论」(Jevons paradox):瓦特把蒸汽机效率提上去之后,煤炭消耗不降反暴增——因为动力便宜了,全世界的蒸汽需求爆炸了。TypeSafe的野心写在名字里:把高频决策的推理成本打掉两个数量级,让那些今天根本不值得调用AI的场景,全部变得值得。
二、3个真本事:这些数据不是滤镜
热度会骗人,但有些数字来自一线开发者的真实工程环境,值得记下来。
第一,格式错误率是0%,这是架构层面的。官方技术白皮书称Jev的类型错误(Type Error)发生率为0%——不是靠外层容错兜出来的,而是因为它根本不走自回归字符生成链路,在受限概率空间里采样,数学上不可能出现类型损坏。 做过业务系统的人都知道结构化输出有多糟心:JSON前后带客套话、漏闭合括号、返回枚举之外的选项,工程师被迫在外面包一层又一层的格式修复器和重试循环。官方对比数据里,轻量模型Haiku 4.5的结构化输出错误率甚至高达45.5%。知乎专栏
第二,账单差异是两个数量级级别的。有人拿它审PR:一次7万分之一美元,1000个PR才花7美分,同样的活交给Opus 5得烧掉14.5美元。 有人把它接入企业收件箱:把300封包含商务采购、线上故障与日常通知的邮件实时路由给15个业务部门,耗时9.9秒,API成本仅约3美分。知乎专栏知乎专栏
第三,可组合性改变了调用姿势。一个复杂决策可以拆碎了并行去问——扔进一条新闻,同时问"是不是AI相关"“是不是广告”“是不是融资”“该归哪个分类”“值不值得推给用户”,一口气全答完。开发者Marcel Pociot做的那个X过滤插件就是这么玩的:后台实时判断每条帖子命不命中"故意引战骗回复"“加密货币”“政治争论”,命中就折叠,而这个判断的速度,平均只需要380毫秒。 而传统大模型开个思考模式做同样判断,可能要十几秒甚至几十秒。知乎专栏

三、3个坑:官方基准和社区实测的另一面
但同一周里,工程实测也把短板摆上了台面。三个坑,每一个都可能直接决定你接入之后是惊喜还是事故。
坑一:准确率并没有"碾压",只有68%。官方自己公布的企业工作流基准里,单个工作流的处理成本仅约0.0003美元,比调用GPT和Claude便宜两个数量级,且综合准确率维持在68%左右。 它的生态位是"低延迟、低成本的判别前哨",不是判断质量的天花板。指望它替你做高难度判断,方向就错了。知乎专栏
坑二:长程任务几乎不可用。有人把它接入浏览器端到端自动化测试,在需要长程状态回溯的任务集上仅取得了1/20的完成度。 Jev是神经反射弧,不是大脑皮层——连续多步、需要记住"我五步之前干过什么"的任务,仍然是大模型的领地。知乎专栏

坑三:中文语境和国内网络,都要打折扣。也有开发者反馈,在复杂中文语境与长上下文输入下,模型的判断准确率存在明显的抖动。 国内开发者还多一层:卡兹克用100道预筛题实测了Jev和GLM-5.3 Flash、DeepSeek V4.1 Flash、Qwen 3.7 Flash的同场对比——GLM 5.3 Flash是唯一一个全对的,但是也最慢和最贵;Jev目前看起来是最综合的,准确性第二、便宜很多;Qwen 3.7 Flash价格只有Jev一半但精度差一截;而Jev因为国内网络延迟,实际耗时被明显拉高。 对国内用户来说,"快"这个最大卖点,不挂代理可能先打个折。知乎专栏知乎专栏

另外提醒一句官方文档里写得很清楚、但踩的人比看的人多的使用纪律:社区一窝蜂拿Jev做浏览器Agent、上下文压缩、监工,但一次只问一个问题、大问题整个丢给它、阈值乱设这三个坑,踩的人比看文档的人多。 社区总结的三条心法是原子问题、投机扇出、置信度路由。哔哩哔哩
四、1场复刻之争:2小时对2年,到底谁对
Jev刷屏的同时,知乎上另一路讨论也很热闹。有回答直接点破:这玩意本质上就是个prefill为主带constraint decoding的小语言模型,“文艺复兴了说是”。 更狠的是一位老哥,用2小时做了一个可运行的开源版本,直接开源了一个基于Qwen-2.5-1B的小模型(Qwen-2.5-1B-RLCD),来证明这东西的门槛根本没那么高。 他在M4 MacBook上对比了并行"RLCD"和普通自回归推理,确实能看到几倍速度提升,而且输出带概率、字段更完整。知乎知乎
这事怎么看?把两边的技术层级拆开就清楚了。复刻版本做的是推理工程优化:利用decoder模型已有的next-token logits,把JSON生成改造成"一次并行做完几十道选择题"——prefill一次、广播KV Cache、每个字段做子词表投影、最后程序化拼装。它证明的是"快"和"格式稳定"这两件事,用普通小模型加工程手段就能逼近。但这个项目还比较糙,支持的类型也比Jev窄很多,主要就是boolean和enum/choice,自由文本、复杂嵌套结构这些并没有真正解决。 更没有碰"校准"——模型说90%把握时是不是真有九成命中率,这才是RLCD两年功夫花的地方。知乎
所以这场争论的合理结论不是"Jev是骗局",而是:快和省,是可以被工程复制的护城河浅水区;置信度校准和零样本通用性,才是深水区。用圈内人的话说,Jev偏API/schema抽象,复刻项目偏推理优化,两个层级理论上还能叠起来。 社区里也已经出现了0.4B、2.37GB、兼容官方API/SDK的开源替代,排队排不上的开发者已经开始用脚投票。知乎
五、三笔账算完,四类人对号入座
正在搭Agent或工作流的人(该测): 模型路由、内容预筛、监工模式、上下文压缩——这些"用大炮打蚊子"的环节,是Jev的主场。把贵的模型留给判断,把判断前置给Jev,账单可能直接砍一个数量级。Vercel AI Gateway已经接入,试错成本是一个下午。
重度AI工具用户、不写代码的人(观望): Jev没有聊天界面、没有App,它只对开发者开放API。这波热潮暂时改变不了你的使用体验,除非你等的是"用它做的产品"——比如那个X过滤插件。可以关注,不用焦虑。
想蹭概念做业务的团队(先想清楚68%): 它是判别前哨,不是决策大脑。任何"接入Jev就全自动了"的叙事,都请先对着68%的基准准确率和1/20的长程完成度冷静一下。置信度路由那套阈值设计(大于0.9自动、0.7到0.9复核、小于0.7人工),才是它正确的打开方式。
等国产平替的人(不用等太久): 卡兹克的实测已经说明,国产Flash模型在纯判断场景的准确率并不落下风,差的只是定价和"输出免费"的架构。Jevons悖论这个名字起得精准——判断成本一旦崩到接近于零,第一波爆发的会是调用量的暴增,而不是某一家公司的垄断。
六、接下来盯这三个信号
一是谷歌那条"DiffusionGemma as Jev"会不会长成正式产品——Gemma官方账号火速发了条「DiffusionGemma as Jev」,直接把自家的扩散模型塞进这个新范式,甚至还顺手把视觉能力也给补上了。 大厂入场是把品类做实,还是收割,一个月内见分晓。二是开源复现(Qwen-2.5-1B-RLCD、0.4B兼容版)能不能把"校准"也补上,如果能,TypeSafe的定价权就到头了。三是国内云平台和模型厂商会不会跟进这个品类,那才是国内用户"快和省"真正落地的时间点。知乎专栏

一句话收尾:Jev不是又一个跑分明星,它是把"AI判断"从按字计费改成按打计费的一次定价实验。实验能不能成,看的是校准,不是速度。在你自己的工作流里,也一样。