画面够真,一开口就穿帮:AI视频这轮「声音关」,三个病因别用同一个药方
这两周的AI视频社区,讨论热点肉眼可见地从"画面"滑向了"嘴"。
9月15日,知乎有人认真发问:为什么AI视频里的人,说话时嘴部的动作幅度都特别大,看得觉得很别扭? 这个问题下面攒了几十条回答。9月19日,小红书上一条"Minimax-H3提示词不会写?音频总出问题?“的教程拿了79赞95藏。 9月22日,微博一条长剧截图视频拿了4609赞,高赞评论是"以后都要这样看长剧了吗,真人AI好诡异”。知乎小红书微博
9月24日,豆包版"华强买瓜"被反复转发,评论区都在聊那个配音的"AI腔"。 同一周,B站有人贴出MiniMaxH3直出30秒视频的ComfyUI教程,标题直接写"媲美Seedance2.5",两天做到500+赞、600收藏。 教程标题里写的是"直出",可点进评论区,问得最多的是"声音怎么办"。微博哔哩哔哩
把这几件事摆在一起,能看出来一个正在发生的错位:画面生成这半年的进步速度,已经把声音甩在后面了。9月下旬的抖音创作者大会上,剪映推出了一站式创作工作台,把AI生成和剪辑环节打通。 会上的另一组口径是,平台上使用AI创作的稿件量半年增长91%,AIGC成了增长最快的内容类型。 但平台同时在对"好内容"焦虑。焦虑落到观众体感上,大多不是"这画面一看就是AI",而是"这人一开口,前面攒的真感全没了"。36氪知乎
先分清:「不像人」不是一个病,是三个病
社区里现在最常见的动作,是口型一别扭就回去改提示词、重抽画面。但把近两周知乎、小红书、B站上的教程和实测帖按处理环节归一下类,"声音穿帮"其实分三层,病因和解法完全不同。
第一层:念稿感——问题在文案,不在模型
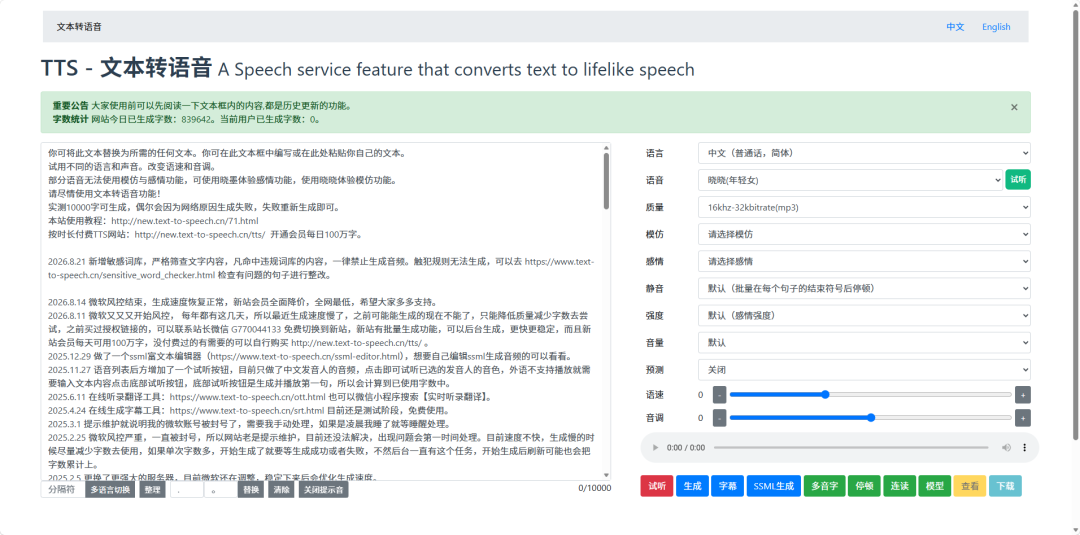
这是最被冤枉的一层。多数AI配音引擎读文案时,标点就是它的指挥棒:逗号句号管停顿长短,省略号拖尾音,问号升调,圆括号里直接降成气声。一篇在知乎教程区流传的配音情绪指南给过一个扎心判断:六成AI配音"不像人",不是声音不真,而是从头到尾一个调子——塞进哪怕两处情绪变化,整个听感就会换档。 同一句"我一点都不在意",标点方案不同能听出十几种情绪;语速、音高、停顿这些参数在TTS后台都是一排现成的滑杆。这层的修复成本接近零:改标点、加情绪指示、控语速(旁白160-180字/分钟,情感类降到120-140),比换任何工具都值得先做。知乎
第二层:口型别扭——问题在节奏和素材,不全是口型同步的锅
一篇9月15日的口型工具横评(先说清楚:它带着自家产品立场,匹配度数字当不得真,但工程经验部分和评论区是通的)里有几条被多个教程反复抄录的规则:语速降到原速的85%-90%,嘴型违和明显下降——慢下来10%左右,模型匹配窗口变宽,准确率能提升一档。 每15-20秒留一个明确停顿,给模型锚点;源素材别用贴脸特写——中近景最考验口型,远景的嘴巴小到观众根本不看。再叠加知乎"嘴部幅度"问题下的另一种解释:夸张口型有一部分是训练语料里"演出字面化"的锅,你越提示"情绪饱满",它嘴动得越用力。也就是说,这层至少三分之一的问题,靠改分镜、改语速、改提示词就能吃掉。教程区沉淀的共识做法还包括:对白单段控制在15秒以内、长对白拆开生成再拼、多角色用不同声音角色并控制话轮间隔——这些的代价是时间不是钱,一段对白超过15秒,口型效果就不稳定。知乎专栏知乎
第三层:真要"凭空让画面开口",才轮到工具出场
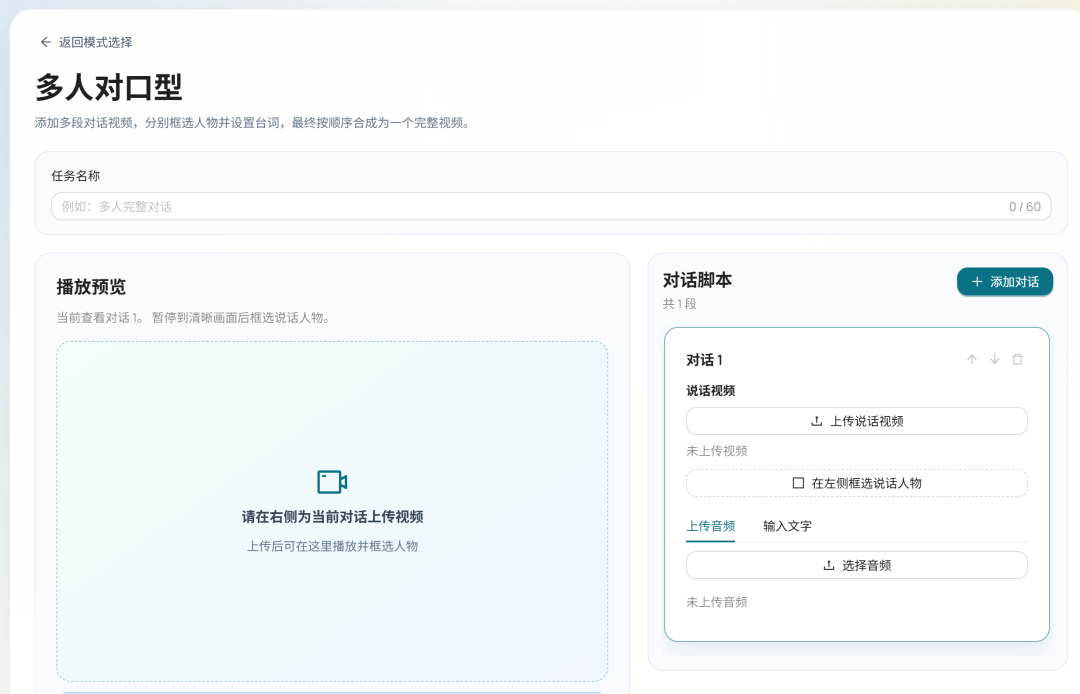
数字人口播、真人视频翻译出海这类场景,绕不开TTS+口型同步+合成这条链。9月3日知乎一篇开源工作流观察写得最具体:本机管素材、任务、FFmpeg渲染,云端只挂TTS(火山引擎、CosyVoice)和口型同步(VideoRetalk)接口;它的选型建议只有一句话——别先问哪个工具更全,先问你的成片是否需要一个会说话的人。 同月B站围绕MiniMaxH3、Seedance 2.5、Kling 3.0的"直出"教程密集上架,方向是模型原生音频:音画一次生成,理论上没有对齐问题,但社区实测反馈恰恰是"音频总出问题",直出的声音能不能用,取决于你接不接受它的默认情绪。知乎

三种人,卡在不同的门上
口播/带货/知识号:在意"谁在说",瓶颈在第一层。先把文案标点和断句按呼吸节奏重写一遍,再谈配音工具;固定一张脸反复讲不同内容的,走数字人+TTS流水线。
漫剧/短剧作者:在意"像不像戏",瓶颈在第二层。口型违和先查语速和景别,别先查模型。
出海翻译向:瓶颈在第三层的硬骨头——音素和口型本来就不是一一对应,英文的一个音素常常对应中文里两到三个发音动作。 经验是先做同语系(中文到日韩语的口型同步成本,比中文到英语低得多),英语版只留给你最爆的素材,别全量做。知乎专栏
掏钱顺序:先做不要钱的三件事
把近两周的信号排一下优先级,结论挺反直觉:大多数人的"口型别扭",不需要买任何工具。
自查顺序应该是——①改文案:情绪变化至少两处、标点按呼吸写、语速压到85%-90%;②改素材:把贴脸特写换成中近景,远景镜头的嘴部问题直接豁免;③改预期:翻译出海的内容,非头部素材不做英语口型版。三件事做完仍然"一开口就出戏"、且这条内容值得救,再进入口型同步工具的选型。
选型时多留个心眼:这一周搜索结果里"X款口型/配音工具对比"的文章,点开不少是厂商自己写的横评,带水印的教程配图和评论区互推混在一起。判断标准不是它的匹配度数字,而是三件事——中文源适配、能不能嵌进你现有流程、价格是否按你实际跑的量收。
至于要不要等"模型直出音频"完全成熟,观察两个信号就够:H3这批新模型的音频直出,评论区从"音频总出问题"变成"够用"的比例;以及"给AI视频补声音"类教程的热度会不会在一个月内退下去。在任何一个信号转正之前,声音这一环,手艺仍然比工具值钱。